
WISSEN > GLOBAL FILE SYSTEM > CYBER RESILIENCE
Ransomware erkennen, eindämmen und Daten wiederherstellen
Autor: Dirk Neumann Geschäftsführer ASSISTRA Cloud Services GmbH 17.08.2026
Cyber Resilience für File Services
Das sollten Sie mitnehmen:
- Ransomware-Schutz ≠ einzelnes Feature
Prevention, Detection, Containment, Data Recovery und Platform Recovery lösen jeweils ein anderes Problem.
- Die Reichweite der Erkennung entscheidet
Protokolle, Volume-Typen und Lizenzumfang bestimmen, welcher Teil der Umgebung tatsächlich überwacht wird.
- Erkannt ≠ eingedämmt
Ob die Reaktion automatisch erfolgt oder eine manuelle Bewertung voraussetzt, entscheidet über den betroffenen Datenbestand.
- Geschützte Daten bedeuten keinen geschützten Service
Ohne Metadaten und Control Plane bringt ein intakter Object Storage den File Service nicht zurück.
- Administrative Trennung ist ein eigener Schutzmechanismus
Recovery-Systeme sollten nicht dieselben Identitäten und Failure Domains nutzen wie die Produktion.

Inhaltsverzeichnis
- Mehrere unabhängige Schutzebenen statt eines einzelnen Features
- Erkennung und Eindämmung im Vergleich
- Wiederherstellung: Datenebene und Plattformebene
- Praxisfall: Die Daten überlebten – die Plattform nicht
- Was wir daraus für heutige Architekturen ableiten
- Administrative Trennung und die Grenzen von Immutable Storage
- Was bei der Auswahl zu prüfen ist
- Fazit
- Quellen
Ransomware-Schutz wird häufig auf zwei Funktionen reduziert: Antivirus erkennt Schadsoftware, Backups stellen im Ernstfall die Daten wieder her. Für eine belastbare File-Service-Architektur reicht das nicht. Ein Angriff kann über ein kompromittiertes Benutzerkonto laufen, sich legitimer Protokolle wie SMB bedienen und neben den Nutzdaten auch Infrastrukturkomponenten, virtuelle Maschinen und Backup-Systeme treffen.
Entscheidend ist deshalb nicht nur, ob eine einzelne Datei geschützt oder wiederhergestellt werden kann. Die Architektur muss den gesamten Weg abdecken – von der Erkennung über die Eindämmung bis zum Wiederanlauf der Plattform. Genau darin liegt der Unterschied zwischen Cybersecurity und Cyber Resilience: Angriffe früh erkennen und begrenzen, gleichzeitig aber davon ausgehen, dass ein Angriff gelingt, und die Wiederherstellbarkeit von Anfang an einplanen.
Nahezu alle Anbieter im Umfeld verteilter File Services – CTERA, Nasuni, Panzura, Egnyte, NetApp ONTAP, Azure Files – werben inzwischen mit Ransomware-Funktionen. Die Mechanismen unterscheiden sich jedoch erheblich darin, an welcher Stelle der Architektur sie greifen und welche Ausfallszenarien sie überhaupt adressieren. Ein von uns begleiteter Ransomware-Fall zeigt, warum diese Unterscheidung nicht akademisch ist.
Mehrere unabhängige Schutzebenen statt eines einzelnen Features
Eine robuste Architektur setzt nicht darauf, dass eine einzelne Maßnahme jeden Angriff verhindert. Sie kombiniert Mechanismen, die unterschiedliche Angriffs- und Ausfallszenarien adressieren.
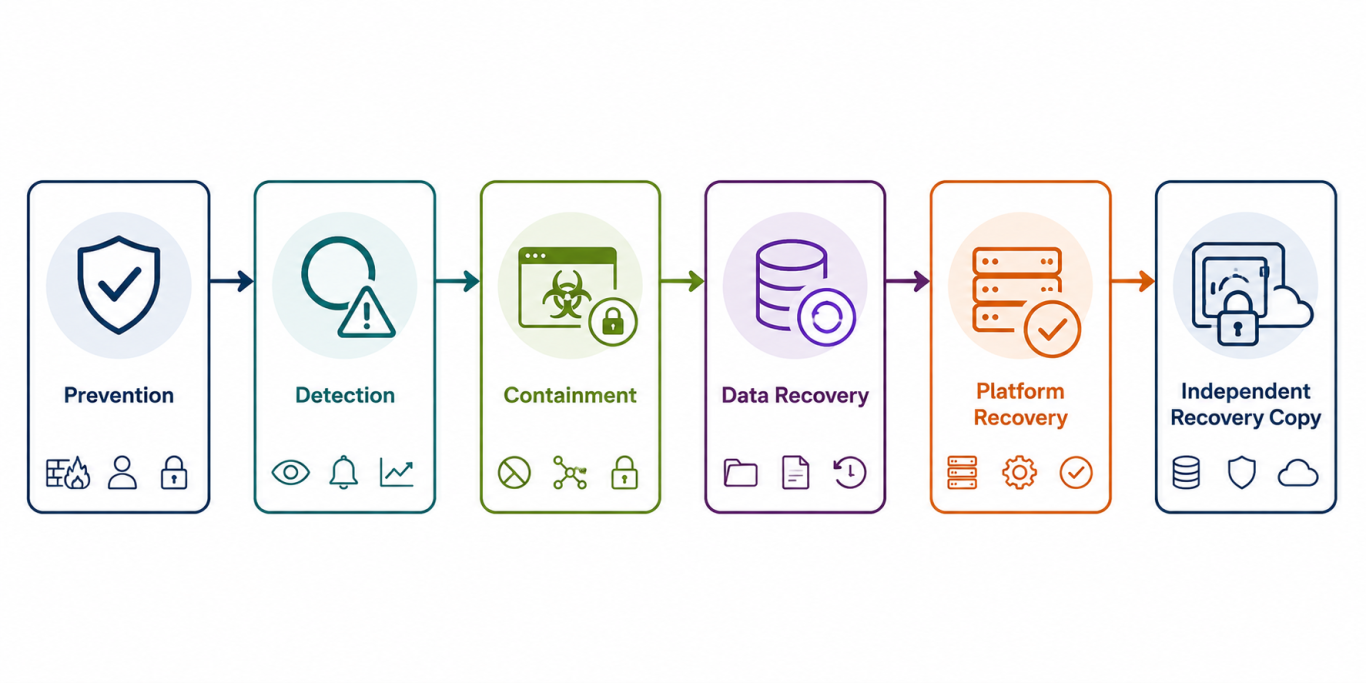
Ein Virenscanner untersucht Dateien auf erkennbare Schadsoftware. Eine verhaltensbasierte Erkennung betrachtet stattdessen die Aktionen eines Benutzers oder Prozesses. Versionierung und Snapshots ermöglichen die Rückkehr zu einem Zustand vor einer Veränderung. Und eine davon getrennte Disaster-Recovery-Architektur muss sicherstellen, dass die Plattform selbst nach dem Verlust von Servern, Datenbanken oder Virtualisierungsinfrastruktur wieder aufgebaut werden kann. Keine dieser Ebenen ersetzt eine andere: Ein Antivirus-System rekonstruiert keine zerstörte Datenbank, ein Snapshot erkennt keinen kompromittierten Account, und ein immutable Bucket stellt keine Plattform wieder her.
Dieses Raster eignet sich auch als Bewertungsmaßstab für die verfügbaren Plattformen.
Erkennung und Eindämmung im Vergleich
Der wichtigste Unterschied zwischen den Lösungen liegt nicht in der Frage, ob eine Ransomware-Erkennung vorhanden ist, sondern wo sie sitzt: am Edge im Schreibpfad, im Storage-Layer, in einer zentralen Cloud-Analyse – oder gar nicht in der File-Plattform selbst.
CTERA
Erkennung Ransom Protect: verhaltensbasierte ML-Analyse am Edge Filer, optional mit Honeypot-Engine. Malware-Scan über ICAP-Anbindung externer AV-Systeme.
Zugriffswege Verhaltenserkennung ausschließlich über SMB. NFS und FTP werden nicht analysiert.
Eindämmung Automatische Benutzersperre, bestehende SMB-Sessions werden sofort beendet. Über andere Protokolle keine neuen Sessions.
Nasuni
Erkennung Ransomware Protection als kostenpflichtiges Add-on: In-line-Prüfung an der Edge Appliance über Signaturen und Verhaltensanalyse.
Zugriffswege Schreibpfad der Edge Appliance; laut Dokumentation werden nur neue und geänderte Dateien geprüft.
Eindämmung Konfigurierbare Mitigation Policies und Incident Report. Wiederherstellung über Snapshots.
Panzura
Erkennung Detect and Rescue beziehungsweise Threat Control: ML-Modell, das seine Baseline aus der eigenen CloudFS-Umgebung lernt.
Zugriffswege Dateiaktivität über die CloudFS-Knoten.
Eindämmung Alarmierung und Interdiction innerhalb von Minuten. Das Datenblatt beschreibt Teilschritte des Ablaufs als manuell.
Egnyte
Erkennung Signaturbasierte Erkennung typischer Ransomware-Artefakte plus verhaltensbasierte Modelle in der SaaS-Plattform.
Zugriffswege Zugriffe über die Egnyte-Plattform und deren Clients.
Eindämmung Automatische Sperrung des betroffenen Kontos, sofern Auto-Remediation freigegeben ist.
NetApp ONTAP
Erkennung Autonomous Ransomware Protection: Entropie- und Workload-Analyse im Storage-Layer, ab ONTAP 9.16.1 ohne Lernphase.
Zugriffswege NFS und SMB, ab 9.17.1 auch SAN. Nicht unterstützt unter anderem auf SnapLock- und FlexCache-Cache-Volumes.
Eindämmung Automatisch erzeugte gesperrte Snapshots und Alarmierung. Benutzersperre nur über zusätzliche Dienste der NetApp Console.
Azure Files / File Sync
Erkennung Keine verhaltensbasierte Erkennung im Datenschutzmodell. Threat Detection über Defender for Cloud und Sentinel auf Identitätsebene.
Zugriffswege Kein dateidienstseitiger Erkennungspfad; Microsoft nennt Soft Delete, Share Snapshots, Azure Backup und File Sync.
Eindämmung Keine Eindämmung im Dateidienst. Reaktion über Identitäts- und SIEM-Ebene.
Microsoft DFS-R
Erkennung Kein plattformeigener Mechanismus.
Zugriffswege Kein Erkennungspfad im Dienst selbst.
Eindämmung Keine. Schutz und Reaktion hängen an Endpoint-Security und Backup-Lösung.
Zwei Punkte verdienen besondere Aufmerksamkeit.
Erstens die Protokollreichweite. CTERA dokumentiert ausdrücklich, dass Ransom Protect Windows File Sharing überwacht und Benutzerverhalten über NFS oder FTP nicht analysiert. NetApp deckt mit ARP von Beginn an NFS und SMB ab, schließt dafür aber SnapLock- und FlexCache-Cache-Volumes aus – gerade Letzteres ist relevant, wenn FlexCache als Grundlage eines verteilten Namespace dient. Wer in gemischten Linux-/Windows-Umgebungen plant, sollte diese Grenzen kennen, bevor er eine Erkennungsfunktion als flächendeckenden Schutz einplant.
Zweitens der Automatisierungsgrad der Reaktion. Erkennung besitzt nur dann unmittelbaren Schutzwert, wenn eine Reaktion folgt. Hier reicht die Bandbreite von vollautomatischer Benutzersperrung über konfigurierbare Auto-Remediation bis zu Abläufen, in denen der Administrator Evidenzdateien herunterlädt und manuell entscheidet. Je früher die Eindämmung greift, desto kleiner bleibt der betroffene Datenbestand – ein Prozess mit menschlicher Freigabe kann fachlich richtig sein, verändert aber die Zeitachse.
Aus der Praxis: False Positives gehören zur Einführung
Bei einem unserer Kunden ist die verhaltensbasierte Erkennung produktiv im Einsatz. Tatsächliche Ransomware-Angriffe hat das System dort bislang nicht erkannt – False Positives dagegen schon. Diese Fälle haben wir genutzt, um das Erkennungsmodell anzupassen.
Das ist kein Randthema, sondern der eigentliche Aufwand bei der Einführung, und es betrifft jede verhaltensbasierte Lösung unabhängig vom Hersteller. Das System muss zwischen legitimen ungewöhnlichen Zugriffsmustern und einem Angriff unterscheiden. CTERA bildet diesen Zielkonflikt in der Konfiguration ab: Ein zu hoher Detection Threshold verzögert oder verhindert die Erkennung, ein zu niedriger erhöht die Zahl der Fehlalarme. Mit dem Aktivieren des Schalters ist es also nicht getan. Wer eine Erkennungsfunktion evaluiert, sollte deshalb weniger nach der beworbenen Trefferquote fragen als danach, wer im Betrieb die Incidents bewertet.
Wiederherstellung: Datenebene und Plattformebene
Alle betrachteten Plattformen bieten eine Form der Versionierung, und praktisch alle arbeiten mit unveränderbaren Objektkopien. Die architektonisch interessantere Frage betrifft die zweite Ebene: Wo liegen die Metadaten, die aus gespeicherten Objekten wieder ein Dateisystem machen – und was ist nötig, um sie wiederherzustellen?
CTERA
Versionierung Snapshots für Cloud-Drive-Ordner alle fünf Minuten, sofern Änderungen vorlagen. Retention Policy konfigurierbar.
Unveränderbarkeit Geschlossene Snapshots read-only. Object Storage mit Immutability, WORM über CTERA Vault.
Metadaten und Control Plane Separate PostgreSQL-Datenbank des Portals, Sicherung erforderlich. Point-in-Time Recovery und Offsite-Backup der Datenbank in einen S3-Bucket.
Nasuni
Versionierung Continuous File Versioning. Snapshot-Intervalle laut Dokumentation bis hinunter zu einer Minute, unbegrenzte Versionszahl.
Unveränderbarkeit Snapshots werden als WORM-Objekte in den Object Store geschrieben.
Metadaten und Control Plane UniFS hält Daten, Metadaten und Versionen gemeinsam im Object Storage. Die Management Console ist Verwaltungs-, nicht Datenhaltungsebene.
Panzura
Versionierung Lokale read-only Snapshots am Filer alle 60 Sekunden. Cloud-Snapshots konfigurierbar, standardmäßig stündlich.
Unveränderbarkeit Unveränderbare Datenblöcke im Object Store.
Metadaten und Control Plane Metadaten-Tabellen als Grundlage der Wiederherstellung. Abhängigkeiten von Panzura Data Services projektspezifisch prüfen.
Egnyte
Versionierung Snapshot-basierte Recovery, Intervall aktivitätsabhängig. Abdeckung als 30- oder 90-Tage-Plan.
Unveränderbarkeit Versionierte Snapshots in der Egnyte-Cloud.
Metadaten und Control Plane Control Plane wird vom Anbieter betrieben. Wiederherstellbarkeit ist Bestandteil des Dienstes, nicht der Kundenarchitektur.
NetApp ONTAP
Versionierung Geplante Snapshots plus zusätzliche gesperrte Snapshots, die die Ransomware-Erkennung bei Verdacht erzeugt.
Unveränderbarkeit SnapLock im Compliance- und Enterprise-Modus, ergänzt um Tamperproof Snapshots.
Metadaten und Control Plane Cluster- und Konfigurationssicherung sowie replizierte Ziele. Multi-Admin Verification gegen administrativen Missbrauch.
Azure Files / File Sync
Versionierung Share Snapshots und Soft Delete für Shares, über Azure Backup mindestens 14 Tage.
Unveränderbarkeit Vaulted Backup mit Immutable Vault, Soft Delete und Multi-User Authorization.
Metadaten und Control Plane Dienstebene liegt beim Provider. Rekonstruktion der Sync-Topologie und der Server-Endpunkte bleibt Kundenaufgabe.
Microsoft DFS-R
Versionierung Kein plattformeigener Versionsstand. Abhängig von VSS und der eingesetzten Backup-Lösung.
Unveränderbarkeit Nur über nachgelagerte Backup-Systeme.
Metadaten und Control Plane Vollständig abhängig von Windows-Server-, Active-Directory- und Backup-Infrastruktur.
Die Unterschiede beim Metadaten-Recovery wiegen schwerer als die bei Versionierung und Intervall. Ob ein Snapshot alle 60 Sekunden oder alle fünf Minuten entsteht, verschiebt den RPO um Minuten. Ob die Metadaten mit den Daten im Object Store liegen oder in einer separat zu sichernden Datenbank, verändert dagegen den gesamten Wiederanlaufpfad nach einem Totalausfall der Infrastruktur.
Das ist kein Qualitätsurteil über eine Architektur. Eine separate Metadatenbank bringt Vorteile bei Suche, Auditing, Mandantenfähigkeit und Policy-Verwaltung. Sie erzeugt aber eine zusätzliche Komponente, die im Recovery-Konzept auftauchen muss – und genau das wird in der Praxis regelmäßig übersehen.
Praxisfall: Die Daten überlebten – die Plattform nicht
Wie weit geschützte Nutzdaten allein tragen, zeigte sich bei einem Kunden, den wir nach einem massiven Ransomware-Angriff begleitet haben. Nach Einschätzung im Projekt waren rund 90 Prozent der IT-Infrastruktur zerstört oder unbrauchbar. Der Angreifer hatte sich Zugriff über die Active-Directory-Umgebung verschafft.
Die Daten auf dem Object Storage blieben erhalten. Ausschlaggebend war die administrative Trennung: Die Zugangsdaten für die File-Plattform und den Object Storage lagen nicht im kompromittierten Active Directory, der Angreifer konnte diese Konten über die AD-Kompromittierung also nicht übernehmen.
Der File Service stand damit trotzdem nicht zur Verfügung. Die Portal-Server liefen als virtuelle Maschinen, und der Angriff zerstörte auch die VM-Infrastruktur. Gleichzeitig waren die regulären Backup-Daten betroffen. Es entstand eine auf den ersten Blick paradoxe Situation: Die Nutzdaten waren vorhanden, die Infrastruktur, die sie verwaltete, nicht mehr funktionsfähig.
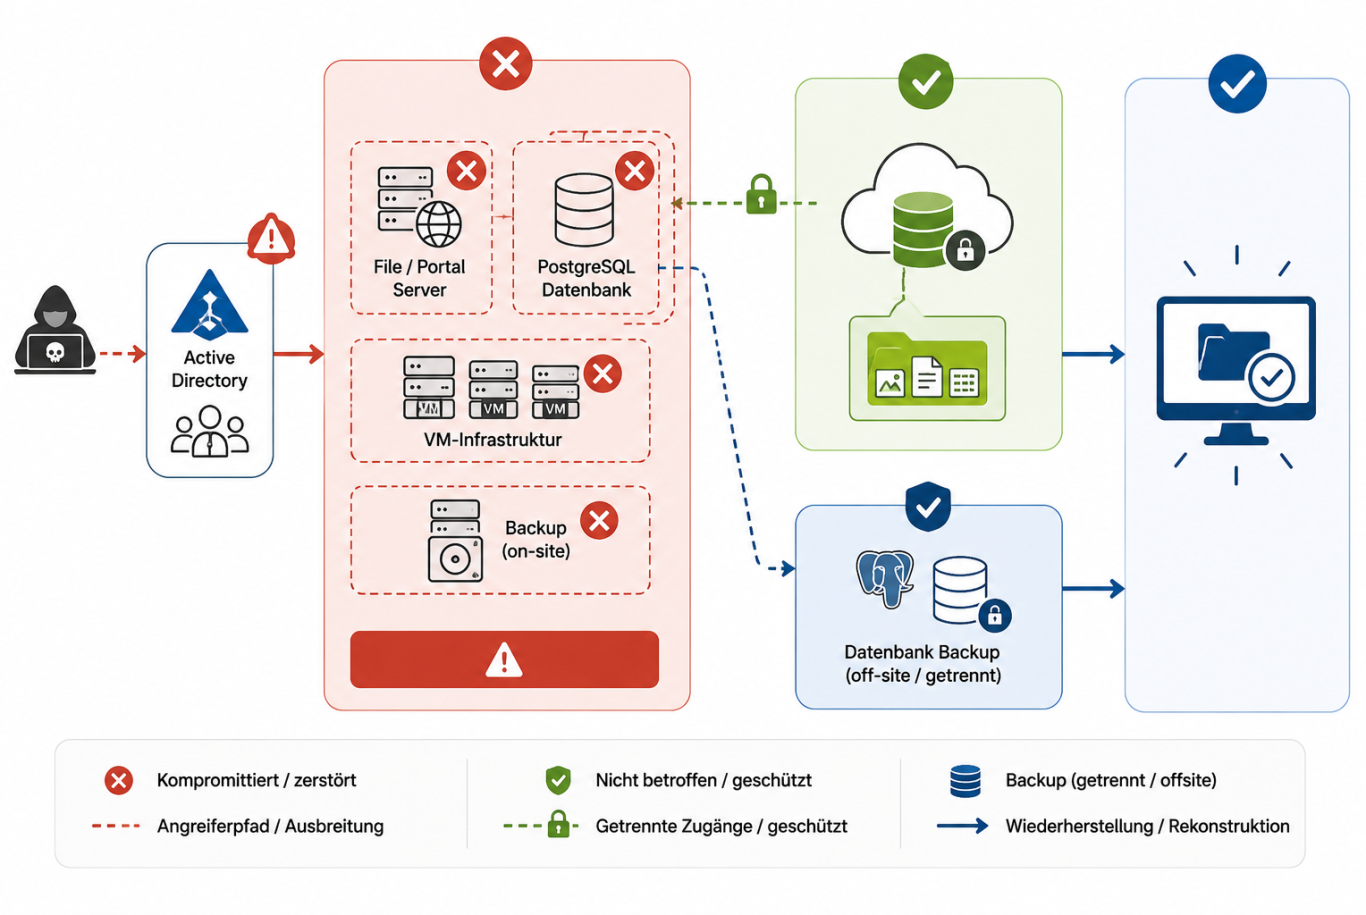
Besonders kritisch war die Portal-Datenbank. CTERA speichert die Plattform-Metadaten in PostgreSQL und weist ausdrücklich darauf hin, dass diese Datenbank gesichert werden muss, um Daten- und Metadatenkonsistenz sowie die Wiederherstellbarkeit der Plattform sicherzustellen. Die Wiederherstellung war deshalb erheblich aufwendiger als zunächst erwartet. Entscheidend wurde eine zusätzliche Kopie der Datenbank auf einem getrennten Offsite-System – erst mit diesem Backup konnten wir die Umgebung gemeinsam mit dem Kunden rekonstruieren.
Die Erkenntnis daraus ist nicht produktspezifisch. Ein unversehrter Data Layer garantiert nicht die Wiederherstellbarkeit des File Service. Jede Plattform hat eine Control Plane, und jede Control Plane hat Abhängigkeiten: bei On-Premises-Deployments Datenbanken, Konfigurationen und Virtualisierung, bei SaaS-Angeboten die Verfügbarkeit und Wiederanlauffähigkeit des Anbieters. Verschwunden ist die Abhängigkeit in keinem der Modelle – sie liegt nur an unterschiedlichen Stellen und in unterschiedlicher Verantwortung.
Was wir daraus für heutige Architekturen ableiten
Wir betrachten die Absicherung seither nicht mehr als einzelnen Backup-Pfad, sondern sehen mehrere voneinander unabhängige Recovery-Mechanismen vor. Am Beispiel einer CTERA-Architektur bedeutet das drei Ebenen.
Erstens die Sicherung der Portal-Server mit einer regulären Backup-Lösung, womit ein Recovery-Pfad für die zugrunde liegenden Systeme beziehungsweise VMs existiert. Zweitens die plattforminternen Datenbankmechanismen: PostgreSQL Continuous Archiving mit Base Backups und Write Ahead Logs erlaubt Point-in-Time Recovery innerhalb des verfügbaren Sicherungszeitraums, dokumentiert als db-rollback auf einen konkreten Zeitpunkt; ergänzend steht Streaming Replication zur Verfügung. Drittens die Sicherung der Portal-Datenbank in einen separaten S3-kompatiblen Bucket, die neuere CTERA-Versionen als Offsite Database Backup unterstützen und die neben Datenbank-Backups und Archiv-Logs auch wiederherstellungsrelevante Konfigurationen umfasst. Diesen Mechanismus setzen wir in aktuellen Projekten in Verbindung mit einem entsprechend geschützten, immutable ausgelegten Object-Storage-Ziel ein.
Die konkreten Mechanismen unterscheiden sich je nach Plattform – bei ONTAP treten Cluster-Konfigurationssicherung und SnapMirror-Ziele an diese Stelle, bei Azure Files die Vaulted Backups und die Rekonstruktion der Sync-Topologie. Das Prinzip bleibt gleich: Es braucht mindestens einen Recovery-Pfad außerhalb der Failure Domain der Produktionsumgebung. Eine replizierte Datenbank hilft nur begrenzt, wenn Primär- und Replikationssystem derselben kompromittierten administrativen Domäne angehören.
Administrative Trennung und die Grenzen von Immutable Storage
Der Fall zeigt einen zweiten Architekturpunkt. Ein Backup kann technisch vorhanden sein und trotzdem gemeinsam mit der Produktionsumgebung kompromittiert werden, wenn Angreifer über dieselben administrativen Vertrauensbeziehungen darauf zugreifen. Cyber Resilience muss deshalb nicht nur fragen, wo die zweite Kopie liegt, sondern auch, wer sie löschen oder verändern kann – und welche kompromittierte Identität diesen Zugriff eröffnet.
Bemerkenswert ist, dass mehrere Hersteller genau diesen Punkt inzwischen als eigenes Feature adressieren: NetApp mit Multi-Admin Verification, Microsoft mit Multi-User Authorization und gesperrten Immutable Vaults in Azure Backup. Beide Mechanismen setzen voraus, dass eine einzelne kompromittierte administrative Identität nicht ausreicht, um Recovery-Daten zu vernichten. Wo solche Funktionen fehlen, muss die Trennung organisatorisch und über getrennte Credentials hergestellt werden – so wie im geschilderten Fall.
Immutable Storage ist dabei ein wichtiger Baustein, aber keine DR-Strategie. Unveränderbare Daten verhindern, dass ein Angreifer vorhandene Recovery-Daten innerhalb des Schutzzeitraums überschreibt oder löscht. Wie schnell sich daraus eine komplette Plattform rekonstruieren lässt, ist damit nicht beantwortet. Zu betrachten sind drei Ebenen: der Data Layer (sind Datei- beziehungsweise Objektdaten vorhanden und konsistent?), Metadaten und Control Plane (sind Datenbank, Konfigurationen und die zur Interpretation der Daten nötigen Metadaten wiederherstellbar?) sowie der Service Layer (lassen sich Portal und File Services wieder in Betrieb nehmen?). Im geschilderten Fall überstand Ebene eins den Angriff, während Ebene zwei und drei verloren gingen.
Von diesem Anwendungsfall zu trennen ist die Revisionssicherheit. Wir setzen unveränderbare Speichermechanismen auch zur Erfüllung von Compliance-Anforderungen ein – dass Daten aus rechtlichen Gründen nicht verändert oder gelöscht werden können, beantwortet aber keine der Recovery-Fragen: ob die Management-Infrastruktur wiederherstellbar ist, ob Metadaten, Credentials und Schlüssel verfügbar sind, ob sich ein konsistenter Zustand von Daten und Metadaten herstellen lässt, wie lange der Wiederanlauf dauert und ob dieser Pfad je getestet wurde. Cyber Resilience ist eine Eigenschaft der Gesamtarchitektur, nicht des Speichermediums.
Was bei der Auswahl zu prüfen ist
Bei der Planung sollte nicht nach einem vorhandenen Ransomware-Feature gefragt werden, sondern nach dem vollständigen Angriffs- und Recovery-Pfad. Konkret: Welche Zugriffsprotokolle nutzt die Umgebung tatsächlich, und deckt die Erkennung diese ab? Ist die Erkennung Bestandteil der Plattform oder ein separat zu lizenzierendes Add-on? Erfolgt die Eindämmung automatisch oder erst nach manueller Bewertung, und wer bewertet die Incidents im Betrieb? Wie oft entstehen Wiederherstellungspunkte, und wie lange bleiben sie erhalten? Wo liegen die Metadaten, und welche Komponente muss zusätzlich gesichert werden, um sie wiederherzustellen? Welche administrativen Identitäten haben Zugriff auf die Recovery-Daten, und lässt sich dieser Zugriff durch Mehr-Augen-Verfahren absichern? Und schließlich: Wurde der vollständige Wiederanlauf jemals getestet – nicht die Rücksicherung einzelner Dateien, sondern die Rekonstruktion der Plattform?
CTERA weist beispielsweise darauf hin, dass bei einem Portal-Ausfall Portal-Server, Storage und Portal-Datenbank gleichermaßen in die Business-Continuity-Planung gehören, und empfiehlt für die Datenbank unter anderem WAL-Archivierung sowie eine Kopie des Base Backups an einem anderen physischen Ort. Vergleichbare Hinweise finden sich in den Betriebsdokumentationen der anderen Anbieter – sie stehen nur selten im Datenblatt.
Fazit
Der Markt hat sich in den vergangenen Jahren angeglichen. Verhaltensbasierte Erkennung, unveränderbare Snapshots und kurze Wiederherstellungsintervalle finden sich heute bei praktisch allen ernstzunehmenden Anbietern. Als Auswahlkriterium taugt die bloße Existenz dieser Funktionen deshalb kaum noch – sie ist zur Grundausstattung geworden.
Unterschiede bestehen dort, wo die Datenblätter schweigen: in der Protokoll- und Volume-Abdeckung der Erkennung, im Automatisierungsgrad der Reaktion, in der Lizenzierung als Kern- oder Add-on-Funktion und vor allem in der Frage, wo die Metadaten liegen und wer für deren Wiederherstellung verantwortlich ist. Diese letzte Frage entscheidet über den Wiederanlauf nach einem schweren Vorfall stärker als jedes Snapshot-Intervall. Eine Plattform, deren Metadaten gemeinsam mit den Daten im Object Storage liegen, hat ein anderes Abhängigkeitsprofil als eine mit separater Datenbank – und eine SaaS-Plattform verlagert die Verantwortung, ohne die Abhängigkeit aufzulösen.
Der geschilderte Vorfall hat unsere Planungspraxis verändert, und die Konsequenz gilt unabhängig vom Produkt: Wir bewerten eine Architektur danach, wie viele voneinander unabhängige Recovery-Pfade sie besitzt und welche administrative Identität jeweils darauf zugreifen kann. Eine einzelne Schutzschicht mag beeindruckend wirken; belastbar ist erst die Kombination mehrerer Ebenen, die nicht gemeinsam ausfallen.
Die entscheidende Prüfung lautet daher nicht „Haben wir ein Backup?", sondern: Können wir die komplette File-Service-Plattform nach einer vollständigen Kompromittierung ihrer primären Infrastruktur wieder in einen konsistenten Zustand bringen? Diese Frage gehört an den Anfang einer Global-File-System-Architektur – nicht an das Ende eines Angriffs.
Quellen
- NIST: Ransomware Risk Management: A Cybersecurity Framework 2.0 Community Profile, NIST IR 8374.
- CTERA: Ransomware Protection: CTERA Ransom Protect; Setting Up CTERA Ransom Protect; Blocking Malicious Users; Setting Up Antivirus Scanning; The Snapshot Retention Policy; Configuring CTERA Portal Database for Backup and Restore; Using PostgreSQL Continuous Archiving; Backing Up the CTERA Portal Database to an S3 Bucket; CTERA Business Continuity Solutions.
- Nasuni: Nasuni Ransomware Protection; Recovering from Ransomware; Nasuni File Data Platform Security Model.
- Panzura: Detect and Rescue (Produktseite und Datenblatt); Threat Control; A Framework for Ransomware Resilience.
- Egnyte: Snapshot-Based Ransomware Recovery; Ransomware Recovery Using Egnyte Secure & Govern; Ransomware Detection (Produktseite).
- NetApp: Learn about ONTAP Autonomous Ransomware Protection; ARP use cases and considerations; Supported configurations for ARP/AI; Learn about ONTAP SnapLock.
- Microsoft: Data protection overview for Azure Files; About Azure Files backup; Overview of security features – Azure Backup.
Welche Entscheidung steht bei Ihnen an?
Sie möchten eine bestehende Infrastruktur bewerten, eine neue Architektur planen oder eine konkrete technische Fragestellung klären? Sprechen Sie mit uns über Ihre Anforderungen.
Spezialist für moderne Dateninfrastruktur
