
WISSEN > GLOBAL FILESYSTEM > EDGE FILE SERVICES
Lokaler Dateizugriff, Caching und globale Zusammenarbeit
Autor: Dirk Neumann Geschäftsführer ASSISTRA Cloud Services GmbH 17.08.2026
Edge File Services
Das sollten Sie mitnehmen:
- WAN-Latenz lässt sich nicht wegkaufen, nur umgehen.
Edge File Services sorgen dafür, dass möglichst wenige Zugriffe den WAN-Pfad durchlaufen.
- Global verfügbar heißt nicht lokal gespeichert.
Für die Cache-Größe zählt der lokale Working Set, nicht die Gesamtkapazität.
- Caching und Locking lösen zwei verschiedene Probleme.
Das eine optimiert den Weg zu den Daten, das andere koordiniert konkurrierende Schreibzugriffe. Wer nur das erste plant, bekommt das zweite als Überraschung.
- Nicht jedes Produkt kann standortübergreifend sperren.
DFS Replication und Azure File Sync bieten kein globales Locking – das entscheidet die Auswahl früher als jede Performance-Kennzahl.
- Sizing braucht Nutzungsdaten, keine Kapazitätszahlen.
Aussagekräftig sind Dateianzahl, Änderungsverhalten und Zugriffsverhalten am Standort.

Inhaltsverzeichnis
- Warum WAN-Verbindungen für File Services problematisch sind
- Der lokale Cache als Working Set
- Cache Hit und Cache Miss
- Sichtbarkeit einer Datei und Vorhandensein ihrer Daten
- Lokale Performance löst noch nicht das Problem globaler Zusammenarbeit
- Global File Locking
- Wie schnell sehen andere Standorte eine Änderung?
- Fünf Architekturansätze im Vergleich
- Microsoft DFS: Namespace und Replikation statt Edge Cache
- Azure File Sync: Cloud Tiering auf dem Windows Server
- NetApp FlexCache: Origin und Cache
- Ablösung verteilter Windows-File-Server-Strukturen
- Der Weg dorthin: Migration wird regelmäßig unterschätzt
- Was passiert bei einem WAN-Ausfall?
- Warum Cache-Sizing eine Architekturentscheidung ist
- Wo Edge Caching an Grenzen stößt
- Architekturentscheidung: Caching, Replikation oder zentraler Zugriff?
- Fazit
- Quellen
Unternehmen mit geografisch verteilten Standorten stehen bei klassischen File-Service-Architekturen vor einem Zielkonflikt, der sich nicht wegdefinieren lässt. Anwender erwarten Dateizugriff mit der Reaktionszeit eines lokalen Fileservers. Gleichzeitig soll nicht an jedem Standort eine vollständige, separat zu verwaltende Kopie des Datenbestands liegen. Und wenn Benutzer an verschiedenen Standorten an denselben Dateien arbeiten, müssen konkurrierende Änderungen kontrolliert werden.
Edge File Services adressieren diese Anforderungen, indem sie lokale File Services mit einem übergeordneten Datenbestand und Mechanismen für Caching, Synchronisation und – je nach Architektur – standortübergreifendes File Locking verbinden.
Ein einheitliches technisches Konzept steckt dahinter allerdings nicht. CTERA Edge Filer, Nasuni Edge Appliances, Azure File Sync, Microsoft DFS und NetApp FlexCache lösen Teile des Problems mit unterschiedlichen Architekturmodellen. Gerade diese Unterschiede entscheiden in der Planung darüber, ob eine Lösung trägt.
Warum WAN-Verbindungen für File Services problematisch sind
Die Leistungsfähigkeit eines entfernten File Service wird nicht allein durch die verfügbare Bandbreite bestimmt. Mindestens ebenso relevant ist die Round Trip Time zwischen Client und File Service. Vereinfacht gilt für eine Folge voneinander abhängiger Operationen die Beziehung T ≈ n × RTT + T_Data, wobei n für die Anzahl der sequenziell voneinander abhängigen Netzwerkoperationen steht und T_Data für die eigentliche Datenübertragung.
Diese Formel bleibt abstrakt, solange man keine Zahlen einsetzt. München–New York liegt bei etwa 90 bis 100 Millisekunden RTT. Öffnet eine Office-Anwendung eine Datei, laufen davor eine ganze Reihe voneinander abhängiger SMB-Operationen: Namespace-Auflösung, Verzeichniszugriffe, Metadatenabfragen, Öffnen von Sperrdateien, Prüfen der Berechtigungen. Kommen fünfzig solcher abhängiger Operationen zusammen – für Office-Formate keine ungewöhnliche Größenordnung –, vergehen fünf Sekunden, bevor das erste Byte Nutzdaten übertragen wird. An dieser Zahl ändert eine schnellere Leitung nichts.
Noch anschaulicher wird der Zusammenhang am Bandwidth-Delay-Product. Eine einzelne TCP-Verbindung kann pro Round Trip höchstens so viele Daten übertragen, wie das Empfangsfenster groß ist. Ohne Window Scaling liegt dieses Fenster bei 64 KB; bei 100 Millisekunden RTT ergibt das rund 640 KB/s, also etwa 5 Mbit/s – unabhängig davon, ob die Leitung 100 Mbit/s oder 1 Gbit/s liefert. Aktuelle Betriebssysteme handeln Window Scaling standardmäßig aus, sodass dieses konkrete Limit selten noch zuschlägt. Der grundsätzliche Zusammenhang bleibt aber bestehen: Der Durchsatz einer einzelnen Verbindung skaliert mit dem Verhältnis von Fenstergröße zu RTT, nicht mit der Leitungskapazität. Wer eine 1-Gbit/s-Standleitung bestellt und erwartet, dass sich damit die Latenz erledigt hat, misst hinterher Werte, die niemand versteht.
Ein zentraler Fileserver, der über ein WAN angesprochen wird, zeigt deshalb ein anderes Antwortverhalten als derselbe Server im LAN – auch bei hoher Übertragungsrate.
Edge File Services verändern diesen I/O-Pfad:
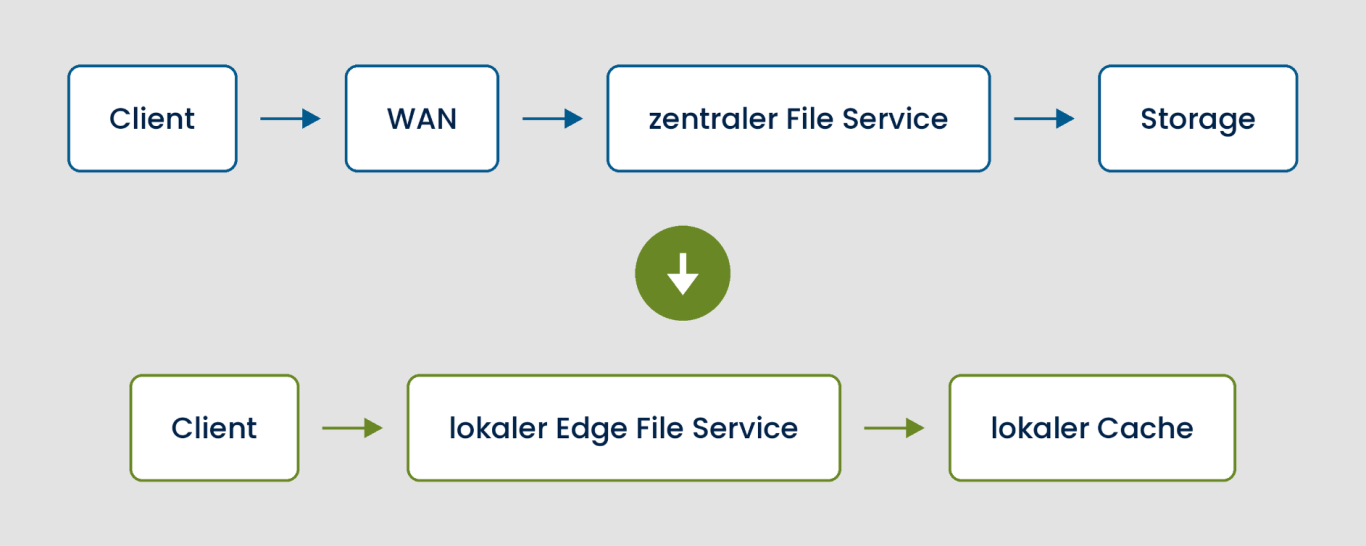
Nur wenn benötigte Daten lokal nicht vorhanden oder nicht aktuell sind, greift die Edge-Komponente auf den übergeordneten Datenbestand zu. Der Ansatz beseitigt WAN-Latenz also nicht – das ist physikalisch ausgeschlossen. Er reduziert die Zahl der Operationen, die den WAN-Pfad überhaupt durchlaufen müssen.
Der lokale Cache als Working Set
Ein Edge File Service benötigt keine vollständige Kopie des global verfügbaren Datenbestands.
CTERA unterscheidet zwischen lokal vorhandenen „hot files" und Daten, die nur im übergeordneten Global File System liegen. Wird der Cache-Speicher knapp, können länger nicht verwendete Dateien lokal entfernt werden, während gepinnte Daten weiterhin über den Edge Filer bereitstehen. Nasuni verfolgt ein vergleichbares Grundprinzip: Der Cache einer Edge Appliance hält die Daten vor, die Benutzer voraussichtlich benötigen, und reserviert gleichzeitig Speicher für neu eintreffende Daten. Als Ziele nennt Nasuni lokalen Datenzugriff, geringere WAN-Nutzung und Datenzugriff während Internet-Ausfällen.
Daraus folgt eine Unterscheidung, die sich durch die gesamte Planung zieht: Global verfügbar ist etwas anderes als lokal gespeichert. Ein Unternehmen kann einen sehr großen globalen Dateibestand besitzen, von dem an einem einzelnen Standort nur ein Bruchteil regelmäßig verwendet wird. Für die Dimensionierung eines Edge File Service zählt deshalb nicht die Gesamtkapazität der Shares, sondern der lokale Working Set.
ASSISTRA-Praxiserfahrung: Cache-Größe nicht aus der Gesamtkapazität ableiten
In ASSISTRA-Projekten hat sich die tatsächliche Nutzung der Daten als wesentliche Planungsgröße erwiesen. Als erste Orientierung verwenden wir etwa 10 Prozent der Kapazität der abzubildenden Shares. Das ist eine Faustformel aus unserer Projekterfahrung und kein technischer Grenzwert – aber sie ist als Startpunkt deutlich brauchbarer als jede Rechnung, die von der Gesamtkapazität ausgeht.
Liegen Informationen aus der bestehenden Datensicherung vor, liefert die durchschnittliche inkrementelle Änderungsmenge zusätzliche Hinweise auf das Änderungsverhalten. Ausschlaggebend bleibt die tatsächliche Nutzung.
Für CTERA-Projekte gehen wir in der Planungsphase so vor: Ein Edge Filer wird gegen das bestehende Legacy File System gefahren und führt dort eine Discovery durch. Das Ergebnis ist eine Bestandsaufnahme der vorhandenen Shares mit Datenvolumen, Dateianzahl und Änderungszeitpunkten – also genau die Kennzahlen, aus denen sich Alter und Änderungsverhalten der Daten ablesen lassen. Dieselbe Appliance, die später den produktiven File Service bereitstellt, liefert damit bereits vor der Entscheidung die Datengrundlage.
Diese technische Bestandsaufnahme kombinieren wir mit Gesprächen über das tatsächliche Nutzungsverhalten. So lassen sich Arbeitsbereiche berücksichtigen, deren Nutzung von rein kapazitätsbasierten Kennzahlen abweicht. Ziel ist nicht, einen festen Prozentsatz auf jeden Standort anzuwenden, sondern den erwarteten lokalen Working Set belastbar abzuschätzen.
Cache Hit und Cache Miss
Zwei Fälle sind zu unterscheiden. Beim Cache Hit liegen die benötigten Daten bereits lokal.
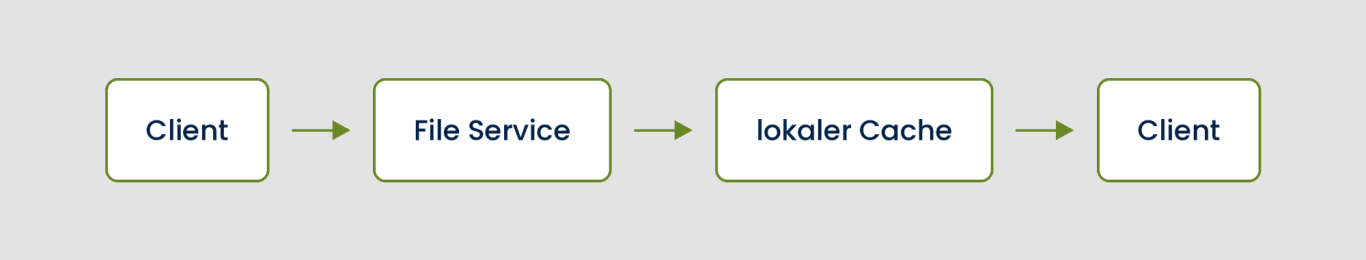
Der Dateiinhalt muss nicht erst über das WAN geladen werden.
Beim Cache Miss ist die Datei im Namespace sichtbar, der Inhalt liegt jedoch nicht vollständig im lokalen Cache.
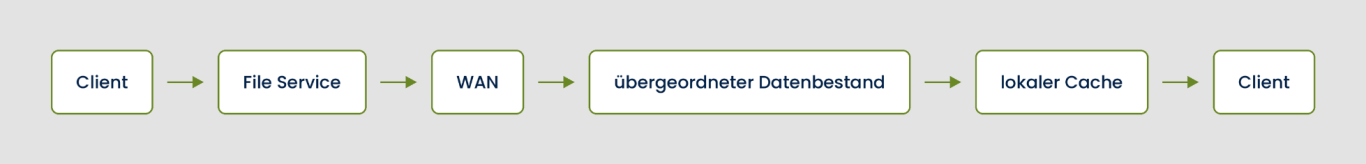
Die WAN-Abhängigkeit verschwindet also nicht, sie beschränkt sich auf Zugriffe, bei denen Daten lokal fehlen. Genau darin unterscheidet sich das Modell von einer Architektur, in der jeder Standort eine vollständige Replik hält.
Sichtbarkeit einer Datei und Vorhandensein ihrer Daten
Für Anwender ist ein Effekt besonders wichtig: Eine Datei kann im lokalen Namespace sichtbar sein, ohne vollständig im Cache zu liegen. Diese Trennung zwischen Namespace und Metadaten auf der einen Seite und Dateiinhalt auf der anderen erlaubt es, einen wesentlich größeren Datenbestand darzustellen, als physisch im Edge Cache Platz findet.
In von ASSISTRA begleiteten CTERA-Projekten war dieses Verhalten bei Microsoft Office und CAD-Anwendungen besonders relevant. Dateien wurden im lokalen File Service schnell sichtbar, der Inhalt kam beim Zugriff nach. Auch bei großen Dateien haben die eingesetzten Anwendungen mit diesem Verfahren gut gearbeitet.
Für diese Projekte liegen allerdings keine standardisierten Performance-Messungen mit dokumentierter RTT, Dateigröße, Cache-Zustand und Öffnungszeit vor. Aus der Beobachtung lässt sich deshalb kein Benchmark ableiten – es handelt sich um qualitative Projekterfahrung unter den jeweiligen Einsatzbedingungen. Die Einschränkung ist uns wichtig, weil die Aussage „Edge File Services sind bei großen Dateien schnell" in dieser Pauschalität falsch wäre. Das tatsächliche Verhalten hängt von Cache-Zustand, WAN-Latenz, Bandbreite, Dateigröße und Zugriffsmuster der Anwendung ab.
Lokale Performance löst noch nicht das Problem globaler Zusammenarbeit
Caching beantwortet die Frage, woher ein Benutzer die benötigten Daten bekommt. Es beantwortet nicht, was passiert, wenn zwei Benutzer an unterschiedlichen Standorten dieselbe Datei verändern.
Angenommen, dieselbe Datei ist über Edge File Services in München und New York verfügbar. Sobald beide Standorte Schreibzugriff ermöglichen, muss die Architektur konkurrierende Änderungen entweder koordinieren oder nachträglich Konflikte behandeln. Aus einem Cache-Problem wird an dieser Stelle ein Konsistenzproblem eines verteilten Systems – und die Antworten der Hersteller unterscheiden sich hier stärker als bei allem anderen.
Global File Locking
Eine Möglichkeit besteht darin, Schreibzugriffe standortübergreifend zu koordinieren:
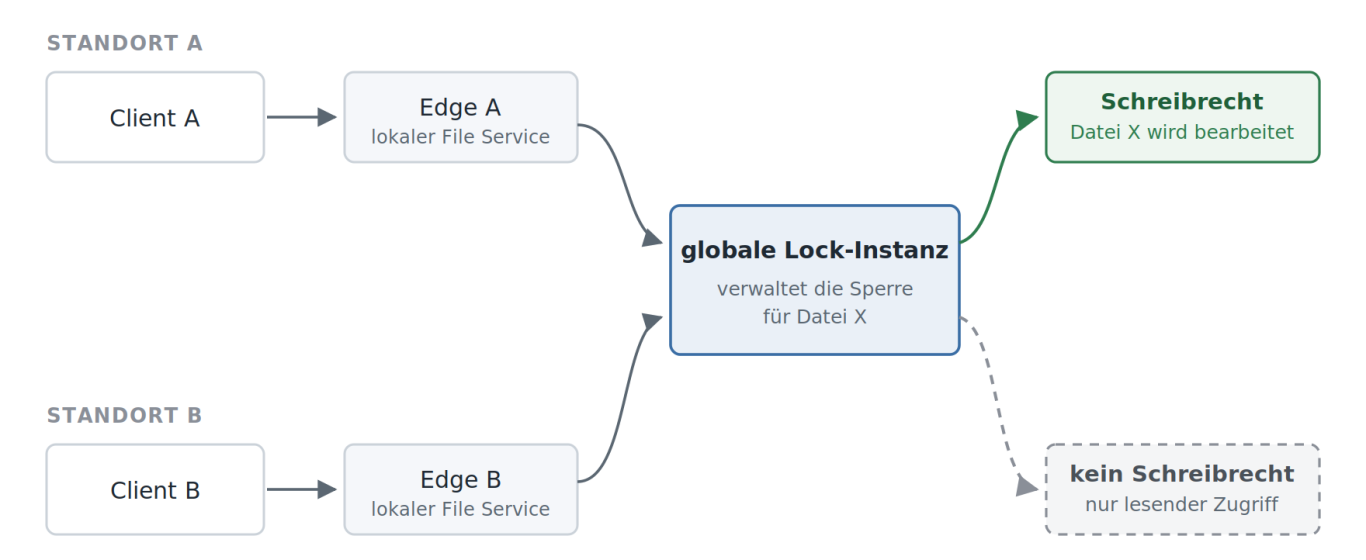
Global File Locking erweitert damit das Prinzip lokaler File Locks über die Grenzen eines einzelnen File Servers hinaus.
CTERA implementiert den Mechanismus auf Ebene eines Cloud Folders. Öffnet ein Benutzer eine entsprechend konfigurierte Datei zum Schreiben, kann ein anderer Benutzer auf einem anderen mit demselben Portal verbundenen Edge Filer diese Datei nicht gleichzeitig bearbeiten; je nach Anwendung lässt sie sich nur lesend öffnen. CTERA dokumentiert Global File Locking unter anderem für DOC/DOCX, XLS/XLSX, PPT/PPTX sowie InDesign-, AutoCAD- und Revit-Dateien und grenzt den Mechanismus ausdrücklich von der Erzeugung von Konfliktdateien ab: Wird Global File Locking für einen Cloud Folder verwendet, ist der Konfliktmechanismus für diese Konstellation deaktiviert.
Nasuni verfolgt einen vergleichbaren Ansatz. Ist GFL für einen Ordner aktiviert, soll jeweils nur ein Benutzer eine Datei verändern können. Nasuni dokumentiert zudem das Management globaler Locks für den Fall, dass eine Edge Appliance nicht verfügbar ist, einschließlich des manuellen Aufbrechens oder Herabstufens von Locks – ein Detail, das in der Betriebsplanung erfahrungsgemäß zu spät auffällt.
Bei der Feinsteuerung gehen beide unterschiedliche Wege, und dieser Unterschied ist für die Auswahl aussagekräftiger als die Frage, ob ein Produkt Global File Locking überhaupt beherrscht. CTERA konfiguriert auf Ebene des Cloud Folders und setzt zusätzlich beim Dateityp an: Gesperrt wird, was zu den unterstützten Formaten zählt. Nasuni konfiguriert pro Verzeichnis samt Unterverzeichnissen und stellt dort mehrere Betriebsmodi zur Wahl, die zwischen strenger Sperre und reduziertem Locking-Verkehr abstufen – wobei die Auswahl dieser Modi bei NFS- und Multiprotokoll-Volumes eingeschränkt ist. Die eine Achse der Feinsteuerung ist damit das Dateiformat, die andere das Sperrverhalten.
Welcher Ansatz besser passt, hängt an den eingesetzten Anwendungen. Wer überwiegend mit Office- und CAD-Formaten arbeitet, kommt mit einer typbasierten Zuordnung weit. Wer Anwendungen mit eigenen Sperrverfahren über Hilfsdateien betreibt oder gemischte Protokolle im Einsatz hat, sollte das Modusverhalten vorab prüfen – am besten mit der konkreten Anwendung, nicht anhand der Formatliste im Datenblatt.
Der Trade-off dahinter ist grundsätzlicher Natur: Lokaler Datenzugriff kann weitgehend am Edge erfolgen, die Koordination konkurrierender Schreibzugriffe hat jedoch zwingend eine globale Dimension. Caching und Locking erfüllen unterschiedliche Aufgaben und sollten architektonisch getrennt betrachtet werden.
Wie schnell sehen andere Standorte eine Änderung?
Zwischen Caching und Locking liegt eine dritte Eigenschaft, die in Auswahlprozessen selten geprüft wird und im Betrieb regelmäßig auffällt: die Zeit, bis eine an einem Standort gespeicherte Änderung an den übrigen Standorten sichtbar ist. Anwender erleben Verzögerungen an dieser Stelle als Langsamkeit des Systems, obwohl der lokale File Service tadellos arbeitet.
Nasuni propagiert Änderungen über Snapshots und Syncs. Ein Snapshot überträgt die Daten in den Object Storage; erst der Sync macht die zugehörigen Metadaten für die anderen Edge Appliances sichtbar, die daraufhin ihren lokalen Bestand mit den Änderungen der übrigen Standorte zusammenführen. Die Frequenz ist konfigurierbar: Für gemeinsam genutzte Volumes liegt das Minimum bei einer Minute zwischen Snapshots, der Standardwert bei fünf Minuten, wobei die tatsächlichen Zeitpunkte bewusst gestreut werden, damit nicht alle Appliances gleichzeitig den Snapshot-Lock anfordern. Nasuni weist selbst darauf hin, dass eine niedrigere Snapshot- und Sync-Frequenz die Propagation neuer Dateien entsprechend verlangsamt, weil deren Verbreitung genau an diesen beiden Schritten hängt.
Wie relevant der Punkt ist, zeigt sich daran, dass Nasuni ihn eigens adressiert hat. Global File Acceleration priorisiert Snapshots dynamisch anhand der Lock-Aktivität und weist Edge Appliances an, neue Daten aus der Cloud nachzuziehen, sobald ein Snapshot abgeschlossen ist. Die Beschreibung des Zustands ohne diesen Dienst ist in der Dokumentation bemerkenswert offen: Dann entscheiden die Appliances rein zeitbasiert, wann sie snapshotten, ohne dass eine von ihnen Vorrang hätte.
CTERA setzt an anderer Stelle an. Die Metadaten des globalen Namespace liegen im Portal, das sie für alle verwalteten Dateien und Objekte indiziert; die Edge Filer halten lokal Stubs mit Dateiname, Größe und Änderungsdatum und cachen Metadaten am Standort. Änderungen an Dateien in synchronisierten Ordnern stoßen den Abgleich mit dem Portal an, Metadatenaktualisierungen werden asynchron zwischen den Standorten propagiert. Eine mit den Nasuni-Werten vergleichbare Intervallangabe veröffentlicht CTERA nicht, sodass sich die beiden Modelle nicht Zahl gegen Zahl stellen lassen.
Der Unterschied liegt im Auslöser: auf der einen Seite intervallgesteuert, auf der anderen ereignisorientiert. Für Standorte, die weitgehend getrennte Datenbereiche bearbeiten, spielt das kaum eine Rolle – dort zählt der Cache Hit, und den bedienen beide Architekturen aus lokalem Storage. Relevant wird es, wo Teams über Zeitzonen hinweg eng an denselben Verzeichnissen arbeiten und die Übergabe zwischen Standorten in Minuten statt in Stunden gemessen wird. Wir empfehlen deshalb, die akzeptable Sichtbarkeitsverzögerung im Auswahlprozess als eigene Anforderung zu formulieren, statt sie unter „Performance" mitlaufen zu lassen. Sie lässt sich vorab benennen, im Test messen und gegen die Konfigurationsmöglichkeiten des jeweiligen Produkts halten.
Fünf Architekturansätze im Vergleich
Die Unterschiede zwischen den Produkten treten deutlicher hervor, wenn man ihre grundlegenden Mechanismen vergleicht statt ihrer Feature-Listen.
Grundmodell
- CTERA: Edge Cache und Global File System
- Nasuni: Edge Cache und globales Datenmodell
- Azure File Sync: Server-Endpoint und Cloud-Endpoint
- Microsoft DFS: Namespace und Replikation
- NetApp FlexCache: Origin und Cache
Namespace
- CTERA: global
- Nasuni: global
- Azure File Sync: pro Sync Group
- Microsoft DFS: DFS Namespace
- NetApp FlexCache: ONTAP-Namespace
Sichtbarkeit von Änderungen
- CTERA: ereignisorientiert
- Nasuni: Snapshot- und Sync-Intervall
- Azure File Sync: Sync-Intervall
- Microsoft DFS: DFS-R-Zeitplan
- NetApp FlexCache: vom Origin koordiniert
Lokaler File Service
- CTERA: Edge Filer
- Nasuni: Edge Appliance
- Azure File Sync: Windows File Server mit Sync-Agent
- Microsoft DFS: Windows File Server
- NetApp FlexCache: ONTAP FlexCache
Datenabgleich
- CTERA: Synchronisation mit dem übergeordneten Portal
- Nasuni: Synchronisation über die Nasuni-Architektur
- Azure File Sync: Sync mit dem Azure File Share
- Microsoft DFS: DFS Replication
- NetApp FlexCache: Origin-/Cache-Kohärenz
Lokaler Datenbestand
- CTERA: Working Set im Cache
- Nasuni: Working Set im Cache
- Azure File Sync: Working Set über Cloud Tiering
- Microsoft DFS: vollständig replizierter Ordnerbestand
- NetApp FlexCache: Cache
Schreibkoordination zwischen Standorten
- CTERA: Global File Locking
- Nasuni: Global File Lock
- Azure File Sync: keine; Konfliktdateien
- Microsoft DFS: keine; Konfliktbehandlung nachgelagert
- NetApp FlexCache: Lock Delegations innerhalb FlexCache
Das wichtigste dieser Kriterien ist die Schreibkoordination. Drei der fünf Ansätze bieten kein standortübergreifendes Locking, und das lässt sich weder konfigurieren noch nachrüsten.
Microsoft DFS: Namespace und Replikation statt Edge Cache
Microsoft DFS ist für den Vergleich besonders interessant, weil eine DFS-Architektur für Benutzer ähnlich wirkt: Ein gemeinsamer Pfad stellt Daten verschiedener Standorte bereit. Technisch müssen jedoch DFS Namespaces und DFS Replication getrennt betrachtet werden.
DFS Namespaces stellt einen logischen Namespace bereit. Folder Targets verweisen auf die tatsächlichen SMB-Freigaben; beim Zugriff erhält der Client eine Referral auf einen entsprechenden Server. DFS Replication synchronisiert dagegen Ordner zwischen Servern und Standorten. Microsoft bezeichnet DFS-R als Active-Active Replication Engine; Änderungen innerhalb replizierter Ordner werden zwischen den Mitgliedern einer Replication Group ausgetauscht, wobei Remote Differential Compression geänderte Datenbereiche erkennt, sodass nicht zwangsläufig die vollständige Datei übertragen werden muss. Das zugrunde liegende Protokoll ist als Multi-Master-Replikationssystem spezifiziert.
Für die Frage nach globaler Zusammenarbeit ist entscheidend, was DFS-R nicht tut: Es kennt kein standortübergreifendes Locking. Öffnen zwei Benutzer an zwei Standorten dieselbe Datei und speichern beide, gewinnt der letzte Schreiber. Die unterlegene Version landet im ConflictAndDeleted-Ordner des Servers – für den Anwender unsichtbar, ohne Benachrichtigung, und mit einer Aufbewahrungsdauer, die vom Quota dieses Ordners abhängt. Wer diesen Mechanismus einmal nach einem verlorenen Arbeitstag erklären musste, plant beim nächsten Mal anders. Hinzu kommt, dass DFS-R geöffnete und gesperrte Dateien nicht repliziert; eine Datei, die dauerhaft offen gehalten wird, wird nie abgeglichen.
DFS-R ist damit keine Kollaborationslösung, sondern eine Verfügbarkeits- und Verteilungslösung. Für Datenbestände, die an einem Standort geschrieben und an anderen gelesen werden – Vorlagen, Software-Repositories, Referenzdaten –, funktioniert das Modell gut. Für gemeinsam bearbeitete Projektverzeichnisse über Zeitzonen hinweg ist es der falsche Mechanismus.
Auch das Kapazitätsmodell unterscheidet sich grundlegend. Bei DFS-R werden definierte Ordnerbestände vollständig zwischen den beteiligten Servern repliziert; jeder Standort trägt die volle Kapazität der replizierten Ordner. Bei einem Edge-Cache-Modell existiert ein wesentlich größerer globaler Datenbestand, von dem lokal nur der relevante Working Set gespeichert wird. Die Planungsfrage verschiebt sich von „Welche Datenbestände sollen an welchen Standorten repliziert werden?" zu „Welcher Teil des globalen Datenbestands muss an einem Standort tatsächlich lokal vorliegen?"
Azure File Sync: Cloud Tiering auf dem Windows Server
Azure File Sync verdient eine eigene Betrachtung, weil es Microsofts direkte Antwort auf das Edge-Modell ist und in Umgebungen, die ohnehin stark auf Microsoft 365 und Azure setzen, oft als erstes geprüft wird.
Das Prinzip: Ein Agent auf einem Windows Server synchronisiert ein lokales Verzeichnis mit einem Azure File Share. Cloud Tiering lagert selten genutzte Dateien in die Cloud aus und hinterlässt lokal einen Pointer; der Zugriff auf eine ausgelagerte Datei ruft den Inhalt transparent zurück. Funktional entspricht das dem Cache-Miss-Verhalten der Edge-Filer-Produkte, und der lokale Server bleibt ein normaler Windows File Server mit den gewohnten SMB-Freigaben, NTFS-Berechtigungen und Backup-Werkzeugen. Für Organisationen mit vorhandener Windows-Kompetenz senkt das die Einstiegshürde erheblich.
Die Grenze liegt an derselben Stelle wie bei DFS. Azure File Sync kennt kein Global File Locking. Ändern Benutzer an zwei Server-Endpoints dieselbe Datei, erzeugt der Dienst eine Konfliktdatei, deren Name den Rechnernamen des Zweitschreibers enthält. Beide Versionen bleiben erhalten – das ist besser als der stille Verlust bei DFS-R –, aber der Anwender muss den Konflikt bemerken und manuell auflösen. Für standortübergreifende gleichzeitige Bearbeitung derselben Dateien ist der Dienst deshalb nicht die richtige Wahl.
Unsere Einschätzung: Azure File Sync ist stark, wenn ein Standort schreibt und Cloud Tiering primär der Kapazitätsentlastung und der Backup-Strategie dient. Sobald mehrere Standorte auf denselben Verzeichnissen schreibend arbeiten, führt an einer Lösung mit echtem Global File Locking kein Weg vorbei. Vergleichbar zu bewerten ist Panzura, das ebenfalls ein Global File System mit Locking-Mechanismen anbietet und je nach Anforderungsprofil in die engere Auswahl gehört.
NetApp FlexCache: Origin und Cache
NetApp FlexCache repräsentiert einen dritten Ansatz. Ein FlexCache Volume stellt Daten eines Origin Volume an einem anderen Ort und damit näher am Client als Cache bereit. Unter aktuellen ONTAP-Versionen unterstützt FlexCache unter anderem NFS und SMB; SMB-Zugriff auf FlexCache Volumes ist seit ONTAP 9.8 möglich.
Interessant ist vor allem die Behandlung von Schreibzugriffen. NetApp beschreibt sowohl Write-around als auch das mit ONTAP 9.15.1 eingeführte Write-back-Verfahren. Zur Sicherstellung der Kohärenz verwendet die Architektur Data Delegations und Lock Delegations, die vom Origin koordiniert werden.
FlexCache zeigt damit, dass lokales Caching und standortübergreifende Konsistenz kein Cloud-Object-Storage-basiertes Global File System voraussetzen. Dieselbe Problemstellung lässt sich innerhalb einer Storage-zentrierten Origin-/Cache-Architektur lösen – vorausgesetzt, ONTAP ist ohnehin die Plattform der Wahl, denn FlexCache setzt ONTAP auf beiden Seiten voraus.
Ablösung verteilter Windows-File-Server-Strukturen
Der Unterschied zwischen Replikation und Caching wird besonders relevant, wenn eine bestehende internationale File-Server-Landschaft konsolidiert werden soll.
ASSISTRA hat bei einem Kunden eine weltweit verteilte Windows-File-Server-Struktur durch eine CTERA-basierte Architektur abgelöst. Ausgangspunkt waren dabei nicht Performance-Probleme, sondern Kosten und Managementaufwand der verteilten Infrastruktur.
Dieser Ausgangspunkt ist architektonisch bedeutsam. Eine klassische verteilte File-Service-Infrastruktur bedeutet eigenständige Systeme an jedem Standort, dazu Replikationsbeziehungen, lokale Kapazitätsplanung, Patch-Management und Backup-Verantwortung vor Ort. Beim Edge-Modell änderte sich die Planungsfrage grundlegend: Nicht mehr jeder Standort musste anhand des gesamten global verfügbaren Datenbestands dimensioniert werden, sondern anhand des lokal tatsächlich benötigten.
Die Konsolidierung einer verteilten File-Service-Architektur ist deshalb kein reines Storage-Thema. Sie verändert das Betriebsmodell. Aus vielen Standorten mit jeweils dauerhaft dimensionierten File-Server-Datenbeständen wird ein globaler Datenbestand mit lokalen File Services und standortspezifischem Working Set. Ob dieser Ansatz für eine konkrete Umgebung passt, hängt von Datenzugriff, Anwendungen, Netzwerk, Offline-Anforderungen und Konsistenzanforderungen ab.
Der Weg dorthin: Migration wird regelmäßig unterschätzt
In der Architekturdiskussion geht meist unter, dass zwischen Entscheidung und Betrieb eine Migration liegt, deren Aufwand die Auswahl der Zielarchitektur beeinflussen sollte.
Das erste Thema ist das Seeding. Ein globaler Datenbestand von mehreren hundert Terabyte lässt sich nicht über eine 100-Mbit/s-Standleitung in ein Wochenende pressen. Die Hersteller bieten dafür unterschiedliche Verfahren an – vom initialen Befüllen eines Edge Filers am zentralen Standort mit anschließendem Transport bis zu Import-Diensten der Cloud-Anbieter. Diese Frage gehört in die Planung, nicht in die Umsetzungsphase.
Das zweite Thema sind die Berechtigungen. NTFS-ACLs, Vererbungsstrukturen, historisch gewachsene Sonderrechte und verwaiste SIDs überstehen eine Migration nur, wenn das Zielsystem sie sauber abbildet und der Kopierprozess sie erhält. Eine Bereinigung vorab ist fast immer sinnvoll und wird fast immer aufgeschoben.
Das dritte Thema ist der Cutover. Ein Parallelbetrieb aus alter und neuer Struktur mit einem finalen Delta-Abgleich ist der übliche Weg.
Wie gut diese drei Themen werkzeugseitig abgedeckt sind, unterscheidet die Produkte deutlicher, als die Datenblätter vermuten lassen. CTERA bringt einen Migrationsagenten mit, der auf dem Edge Filer läuft und unmittelbar an die weiter oben erwähnte Discovery anschließt: Aus der Bestandsaufnahme der Legacy-Freigaben entstehen Migrationsjobs, die Daten samt NTFS-Berechtigungen übernehmen und sich für Delta-Läufe wiederholen lassen, bis beim Cutover nur noch eine kleine Änderungsmenge offen ist. Der praktische Vorteil liegt in der Personalunion: Dasselbe System führt die Migration durch und stellt anschließend den produktiven File Service bereit. Ein separates Migrationswerkzeug mit eigener Lizenz, eigenem Betriebskonzept und eigenen Fehlerquellen entfällt. In ASSISTRA-Projekten hat dieses Vorgehen die geschilderten Szenarien zuverlässig abgedeckt.
In dieser Integrationstiefe ist das ungewöhnlich. Wo ein solcher Agent fehlt, wird in der Praxis mit generischen Werkzeugen migriert – Robocopy ist der Klassiker, ergänzt um selbstgeschriebene Skripte für Jobsteuerung, Protokollierung und Fehlerbehandlung. Das funktioniert, kostet aber Zeit und Personal: Jobs müssen manuell geplant, überwacht und für Delta-Läufe wiederholt werden, Abbrüche fallen erst in der Auswertung auf, und der Cutover-Zeitpunkt lässt sich nur schätzen. Bei einigen hundert Freigaben summiert sich dieser Aufwand zu einem eigenständigen Projektteil, der in der Produktbewertung meist gar nicht auftaucht.
Für die Umstellung der Anwender ist DFS Namespaces ein hervorragendes Werkzeug – auch dann, wenn DFS-R ausdrücklich nicht die Zielarchitektur ist. Ein DFS-Pfad als stabile Adresse entkoppelt die Benutzersicht vom tatsächlichen Backend und erlaubt, Freigaben schrittweise umzuhängen, ohne Laufwerksverbindungen, Verknüpfungen und Anwendungskonfigurationen anzufassen. Diese Trennung von Namespace und Speicherort ist der Teil von DFS, der auch in einer Edge-Architektur seinen Wert behält.
Was passiert bei einem WAN-Ausfall?
Ein Edge File Service kann für lokal vorhandene Daten eine gewisse Unabhängigkeit vom WAN schaffen. Das bedeutet nicht, dass bei einem Ausfall der gesamte globale Datenbestand verfügbar bleibt. Ausschlaggebend ist, welche Daten zum Zeitpunkt des Ausfalls lokal liegen.
Nasuni nennt den Zugriff auf lokal gecachte Daten während eines Internet-Ausfalls ausdrücklich als Funktion seines Cache-Konzepts. Auch in von ASSISTRA begleiteten CTERA-Installationen haben Edge Filer bei WAN-Ausfall den lokalen File Service weiter bereitgestellt; im Cache vorhandene Daten blieben verfügbar. Daraus folgt allerdings nicht, dass während der Unterbrechung beliebige, ausschließlich remote vorhandene Dateien nachgeladen werden können.
Besonders sorgfältig zu betrachten ist das Zusammenspiel mit dem Global File Locking. Ein globales Lock setzt voraus, dass die koordinierende Instanz erreichbar ist. Fällt die Verbindung aus, lassen sich Konsistenzgarantie und Schreibfähigkeit nicht gleichzeitig aufrechterhalten: Entweder das System verweigert Schreibzugriffe auf lockpflichtige Dateien, oder es gibt die Garantie auf und nimmt spätere Konflikte in Kauf. Das ist die klassische CAP-Abwägung, angewendet auf File Services, und keine Implementierungsschwäche eines bestimmten Herstellers – sondern eine Eigenschaft jedes verteilten Systems, das Partitionen überstehen muss.
Die Architekturplanung sollte deshalb nicht nur den Normalbetrieb betrachten, sondern explizit festlegen, welche Operationen bei unterbrochener WAN-Verbindung weiterhin möglich sein müssen, und welches Verhalten für lockpflichtige Dateien gewünscht ist.
Warum Cache-Sizing eine Architekturentscheidung ist
Ein zu kleiner Cache erhöht die Wahrscheinlichkeit, dass benötigte Daten nachgeladen werden müssen. Ein überdimensionierter Cache hebt einen wesentlichen Vorteil des Edge-Modells wieder auf, nämlich nicht den vollständigen globalen Datenbestand an jedem Standort physisch bereitstellen zu müssen. Eine Dimensionierung ausschließlich anhand der Gesamtkapazität greift in beide Richtungen zu kurz.
Für die Planung sollten mindestens folgende Größen betrachtet werden:
- Größe der vorhandenen Shares
- Anzahl der Dateien
- letzter Zugriff und letzte Änderung, soweit erfassbar
- Änderungsvolumen
- standortspezifische Nutzung
- Benutzer und Anwendungen
- außergewöhnliche Zugriffsmuster
- erwartetes Wachstum
- benötigte Offline-Daten
CTERA nennt für das Sizing unter anderem Anzahl der Standorte und Benutzer, physische Datenmenge, Zahl der Shares und Dateien sowie die physische Datenmenge am Edge; die Discovery-Funktion erfasst Informationen über bestehende Shares und deren Nutzung.
Aus unserer Sicht ist gerade die Kombination aus technischer Discovery und fachlichem Gespräch mit dem Kunden entscheidend. Messdaten zeigen, welche Dateien vorhanden sind und wann sie verändert wurden. Sie erklären nicht, warum bestimmte Daten nur quartalsweise benötigt werden oder warum ein ungewöhnlicher Workflow kurzfristig einen erheblich größeren Working Set erzeugt. Sizing ist Workload-Analyse, nicht Kapazitätsrechnung.
Wo Edge Caching an Grenzen stößt
Aus dem Funktionsprinzip lassen sich mehrere Grenzen ableiten. Ein Edge Cache vermeidet WAN-Latenz nur für Zugriffe, die lokal bedient werden können; ein Cache Miss erfordert weiterhin Kommunikation mit dem übergeordneten System. Ein stark wechselnder Working Set führt dazu, dass häufiger Daten nachgeladen und andere verdrängt werden.
Praktisch relevanter als das theoretische Zugriffsmuster sind allerdings die Prozesse, die niemand in der Sizing-Rechnung hat. Ein On-Access-Virenscanner, der über den gesamten Namespace läuft, holt den vollständigen Datenbestand zurück in den Cache und verdrängt dabei genau die Daten, für die der Cache gedacht war. Backup-Agents auf dem Edge-System haben denselben Effekt – die Datensicherung gehört bei Edge-Architekturen auf die Ebene des globalen Datenbestands, nicht auf den Edge. Windows Search-Indizierung über getierte Verzeichnisse wirkt genauso. Und ein Anwender, der im Explorer ein Projektverzeichnis vollständig markiert und die Eigenschaften aufruft, löst damit unter Umständen ein Rehydrieren im Terabyte-Bereich aus. Die Ausschlussregeln für Virenscanner und Indexdienste gehören deshalb in die Betriebsdokumentation, und zwar vor dem Produktivstart.
Es gibt außerdem Workloads, bei denen wir von einem Edge-Cache-Modell abraten. Dateibasierte Datenbanken mit mehreren gleichzeitigen Schreibern – Access-Anwendungen sind der Klassiker – vertragen die zusätzliche Indirektion nicht. PST-Dateien gehören ohnehin nicht auf eine Netzfreigabe, auf einem Edge Filer werden sie zum sicheren Problem. Auch Anwendungen, die dauerhaft offene Handles auf große Dateien halten oder eigene Sperrverfahren über Hilfsdateien implementieren, sollten vor der Entscheidung getestet werden, nicht danach.
ASSISTRA hat in den bisher betrachteten Projekten auch außergewöhnliche Anforderungen durch entsprechende Cache-Auslegung abbilden können. Daraus folgt nicht, dass Caching für jedes Workload-Profil ausreicht; das nachzuweisen erforderte reproduzierbare Tests mit definierten Workloads.
Die entscheidende Planungsfrage lautet deshalb nicht „Wie groß sind unsere Daten?", sondern: Welche Daten müssen an diesem Standort mit welcher Wahrscheinlichkeit und unter welchen Betriebsbedingungen lokal verfügbar sein?
Architekturentscheidung: Caching, Replikation oder zentraler Zugriff?
Edge File Services sind nicht automatisch die richtige Architektur für jede verteilte Umgebung.
Ein direkter zentraler Zugriff kann genügen, wenn Netzwerkbedingungen und Anwendungen das zulassen und lokale Offline-Fähigkeit keine Anforderung ist. Replikation passt, wenn definierte Datenbestände vollständig an mehreren Standorten benötigt werden und Schreibzugriffe klar einem Standort zugeordnet sind. Ein Edge-Cache-Modell wird interessant, wenn ein großer gemeinsamer Datenbestand existiert, einzelne Standorte überwiegend mit einem Teil davon arbeiten und dennoch ein gemeinsamer Namespace sowie standortübergreifende Zusammenarbeit erforderlich sind.
Vier Fragen sollten vor der Entscheidung beantwortet sein:
- Wie groß ist der globale Datenbestand, und wie groß ist der lokale Working Set je Standort?
- Wie reagieren die eingesetzten Anwendungen auf Cache Misses und WAN-Latenz?
- Verändern Benutzer an unterschiedlichen Standorten dieselben Dateien – und wenn ja, ist ein Konfliktmechanismus akzeptabel oder wird echtes Locking benötigt? Welche Verzögerung bis zur Sichtbarkeit einer Änderung an anderen Standorten ist tolerierbar?
- Welche Funktionen müssen bei einem WAN-Ausfall weiterhin zur Verfügung stehen?
Frage 3 fällt in der Praxis am häufigsten die Vorentscheidung. Wird echtes standortübergreifendes Locking benötigt, scheiden DFS-R und Azure File Sync aus, unabhängig davon, wie attraktiv sie in Lizenz- und Betriebsfragen sonst wären.
Fazit
Edge File Services verschieben die zentrale Fragestellung verteilter File Services von der vollständigen Datenreplikation hin zur Datenlokalität. CTERA und Nasuni kombinieren lokale Edge-Systeme mit einem globalen Datenmodell und Mechanismen für standortübergreifende Zusammenarbeit. Azure File Sync bringt Cloud Tiering auf den vertrauten Windows File Server, verzichtet aber auf globales Locking. Microsoft DFS trennt logischen Namespace und Multi-Master-Replikation, wobei der Namespace-Teil auch in modernen Architekturen seinen Platz behält. NetApp FlexCache löst dieselbe Aufgabe innerhalb eines Origin-/Cache-Modells mit eigenen Kohärenz- und Locking-Mechanismen.
Keine dieser Architekturen beseitigt die physikalischen Eigenschaften eines WAN. Sie entscheiden unterschiedlich darüber, welche Daten lokal liegen, wann Daten über das WAN transportiert werden und wie konkurrierende Zugriffe koordiniert werden. Wer diese drei Entscheidungen kennt, kann jedes Produkt einordnen, auch die hier nicht behandelten.
Aus unseren Projekten nehmen wir vor allem die Bedeutung der Planungsphase mit. Die Gesamtkapazität eines Filesystems sagt über die Dimensionierung eines Edge File Service fast nichts aus. Erst die Analyse des tatsächlichen Working Sets sowie des Änderungs- und Nutzungsverhaltens erlaubt ein belastbares Sizing. Edge Caching ist damit weniger eine Frage nach möglichst großer lokaler Storage-Kapazität als eine Frage nach der richtigen Datenlokalität.
Quellen
- CTERA Networks: Sizing. CTERA Knowledge Base. https://kb.ctera.com/v1/docs/sizing
- CTERA Networks: Managing Caching. CTERA Knowledge Base. https://kb.ctera.com/docs/managing-caching-3
- CTERA Networks: Manage File Locking for the Edge Filer. CTERA Knowledge Base. https://kb.ctera.com/docs/manage-file-locking-for-the-edge-filer-1
- CTERA Networks: CTERA Edge Filer. CTERA Knowledge Base. https://kb.ctera.com/docs/ctera-edge-filer-1
- CTERA Networks: Global File System. Produktinformation. https://www.ctera.com/technology/global-file-system/
- Nasuni: Cache Configuration. Nasuni-Dokumentation. https://docs.nasuni.com/v1/docs/cache-configuration
- Nasuni: Global File Lock (GFL). Nasuni-Dokumentation. https://docs.nasuni.com/v1/docs/global-file-locking
- Nasuni: Volumes Page. Nasuni-Dokumentation (Betriebsmodi des Global File Lock). https://docs.nasuni.com/docs/chapter-7-volumes-page
- Nasuni: Snapshot Processing. Nasuni-Dokumentation. https://docs.nasuni.com/docs/snapshot-processing
- Nasuni: Volume Architecture Data Propagation Best Practices. Nasuni-Dokumentation. https://docs.nasuni.com/docs/volume-architecture-data-propagation-best-practices
- Nasuni: Global File Acceleration. Nasuni-Dokumentation. https://docs.nasuni.com/docs/global-file-acceleration
- Nasuni: UniFS – a true global file system. White Paper. https://info.nasuni.com/hubfs/Nasuni.com-assets/White-Papers/Nasuni--White-Paper--UniFS-True-Global-File-System.pdf
- Microsoft: DFS Namespaces overview in Windows Server. Microsoft Learn. https://learn.microsoft.com/en-us/windows-server/storage/dfs-namespaces/dfs-overview
- Microsoft: Distributed File System (DFS) Replication overview. Microsoft Learn. https://learn.microsoft.com/en-us/windows-server/storage/dfs-replication/dfs-replication-overview
- Microsoft: [MS-FRS2]: Distributed File System Replication Protocol. Microsoft Open Specifications. https://learn.microsoft.com/en-us/openspecs/windows_protocols/ms-frs2/3a81ed57-6be8-4e96-906d-4dc4beb5890e
- Microsoft: Planning for an Azure File Sync deployment. Microsoft Learn. https://learn.microsoft.com/en-us/azure/storage/file-sync/file-sync-planning
- Microsoft: Azure File Sync – Cloud Tiering overview. Microsoft Learn. https://learn.microsoft.com/en-us/azure/storage/file-sync/file-sync-cloud-tiering-overview
- NetApp: Supported and unsupported features for ONTAP FlexCache volumes. NetApp ONTAP Documentation. https://docs.netapp.com/us-en/ontap/flexcache/supported-unsupported-features-concept.html
- NetApp: ONTAP FlexCache write-back architecture. NetApp ONTAP Documentation. https://docs.netapp.com/us-en/ontap/flexcache-writeback/flexcache-write-back-architecture.html
Welche Entscheidung steht bei Ihnen an?
Sie möchten eine bestehende Infrastruktur bewerten, eine neue Architektur planen oder eine konkrete technische Fragestellung klären? Sprechen Sie mit uns über Ihre Anforderungen.
Spezialist für moderne Dateninfrastruktur
