
WISSEN > ENTERPRISE STORAGE -> CYBER RESILIENCE ENTERPRISE STORAGE
Schutz- und Recovery-Mechanismen im Storage-Layer
Autor: Dirk Neumann Geschäftsführer ASSISTRA Cloud Services GmbH 17.08.2026
Cyber Resilience im Enterprise Storage
Das sollten Sie mitnehmen:
- Backup ≠ Cyber Resilience
Eine Datenkopie nützt nur, wenn ein Angreifer sie nicht gemeinsam mit den Produktionsdaten erreichen kann.
- Drei Zugriffsebenen
Datenpfad, Management Plane und Data Protection Plane sind getrennte Angriffswege mit jeweils anderen Folgen.
- Snapshots sind abhängig
Sie referenzieren die Quelldaten und ersetzen deshalb keine unabhängige Recovery Copy.
- Immutability braucht ein Rollenmodell
Entscheidend ist, wer die Schutzfrist eines Recovery Points aufheben darf.
- Erkennung ohne Wiederherstellung genügt nicht
Ohne Verfahren zur Bestimmung eines sauberen Zustands bleibt der Alarm folgenlos.

Inhaltsverzeichnis
- Cyber Resilience ist mehr als Datensicherung
- Drei Ebenen, drei Angriffspfade
- Snapshots: schneller Recovery Point, aber nicht automatisch Cyber-Schutz
- Immutability schützt den Recovery Point
- Administrative Isolation wird zur eigenen Schutzschicht
- Replikation ist nicht automatisch eine Recovery-Lösung
- Isolation: Die Failure Domain verkleinern
- Air Gap ist kein einheitlicher Begriff
- Angriffserkennung im Storage
- Detection ohne Recovery reicht nicht
- Crash-consistent ist nicht automatisch application-consistent
- RPO und RTO verändern die Architektur
- Eine mehrstufige Storage-Architektur
- Die entscheidenden Fragen bei der Architekturplanung
- Fazit
- Quellen
Ransomware-Schutz wird häufig mit Endpoint Security, Backup oder Malware-Erkennung verbunden. In einer Enterprise-Storage-Architektur stellt sich jedoch eine zusätzliche Frage: Was passiert mit den Daten, wenn ein legitim angebundener Host kompromittiert wurde und der Angreifer über reguläre I/O-Pfade auf den Storage zugreifen kann?
Ein Storage-System kann nicht grundsätzlich zwischen einer legitimen Änderung und einer durch Ransomware ausgelösten Änderung unterscheiden. Besitzt ein Server Schreibrechte auf ein Volume oder eine LUN, werden seine Schreiboperationen zunächst als autorisierte I/O verarbeitet.
Cyber Resilience im Enterprise Storage beginnt deshalb nicht bei einem einzelnen Sicherheitsmechanismus. Entscheidend ist eine Architektur aus Erkennung, geschützten Recovery Points, administrativer Isolation und einem definierten Wiederherstellungspfad.
Cyber Resilience ist mehr als Datensicherung
Backup und Cyber Resilience verfolgen nicht exakt dasselbe Ziel. Eine Datensicherung erzeugt zusätzliche Datenkopien, aus denen sich Daten nach Verlust oder Beschädigung wiederherstellen lassen. Cyber Resilience betrachtet darüber hinaus, ob diese Kopien nach einer Kompromittierung noch verfügbar, vertrauenswürdig und technisch nutzbar sind.
NIST SP 800-209 behandelt Storage Security deshalb unter anderem über die Bereiche Data Protection, Isolation, Restoration Assurance und Encryption. Wie sehr sich der normative Fokus in Richtung Wiederherstellbarkeit verschiebt, zeigt die laufende Revision des Dokuments: Der Entwurf zu Rev. 1 gliedert den Bedrohungsteil neu und ergänzt dabei zwei Schwerpunkte, darunter „Compromised Data Resilience/Protection". Dieser adressiert ausdrücklich Bedrohungen sekundärer Datenbestände und des Prozesses, der diese Bestände überhaupt erst erzeugt.
Die entscheidende Frage lautet daher nicht nur, ob eine Kopie der Daten existiert. Sie lautet, ob ein Angreifer, der Teile der Produktionsumgebung kontrolliert, auch diese Kopie zerstören oder manipulieren kann. Damit wird die Failure Domain zum zentralen Architekturmerkmal.
Drei Ebenen, drei Angriffspfade
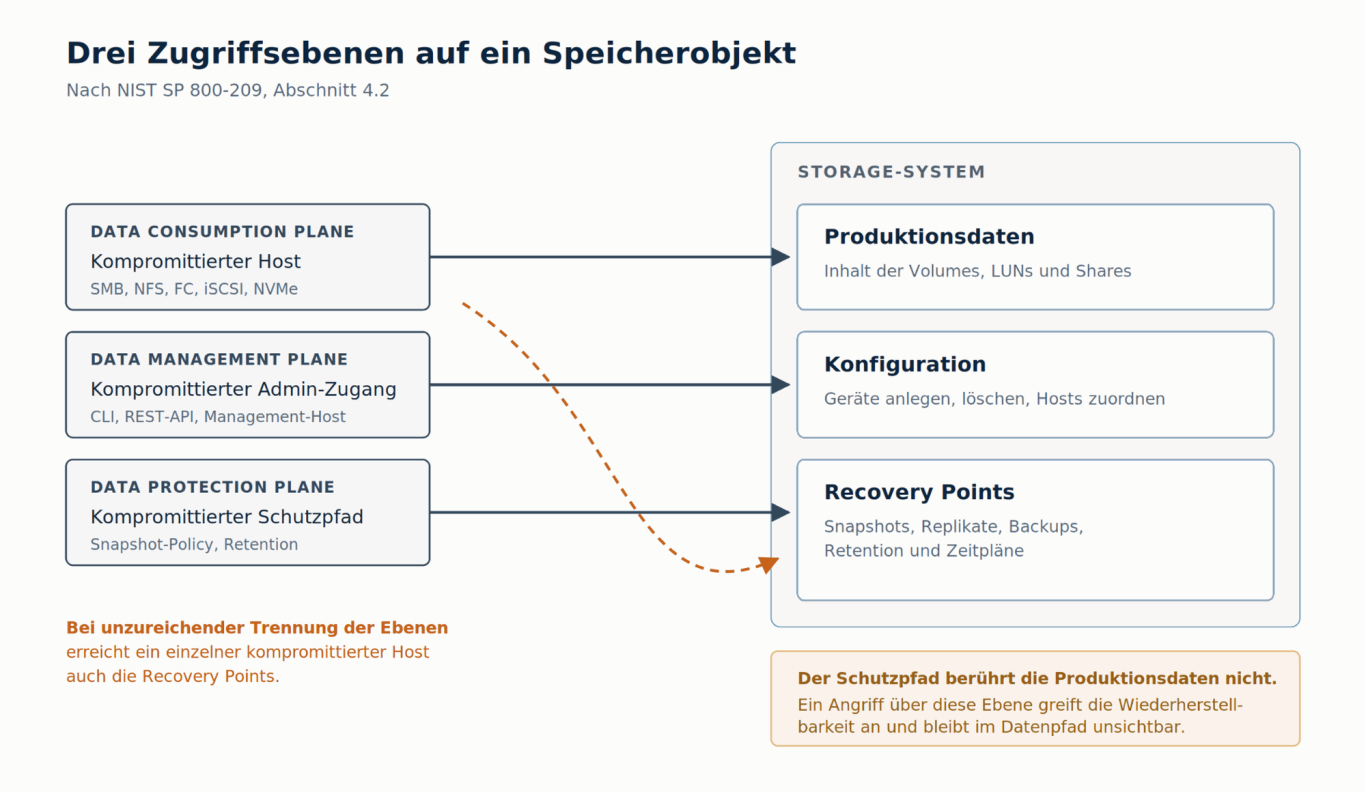
NIST SP 800-209 unterscheidet in Abschnitt 4.2 nicht zwei, sondern drei Ebenen, über die ein Speicherobjekt erreichbar ist. Der Data Consumption Plane umfasst die Zugriffsprotokolle, die I/O-Operationen selbst und die physischen wie logischen Netzwerkverbindungen, über die sie laufen. Der Data Management Plane umfasst Protokolle, Operationen und Netzwerkzugriffe, mit denen ein Gerät erzeugt, gelöscht, konfiguriert oder einem Host zugeordnet wird. Der Data Protection Plane umfasst Replikation, Snapshot, Backup und Archivierung.
Diese Dreiteilung stellt die entscheidende Frage präziser als eine reine Trennung von Daten- und Managementzugriff, denn sie erlaubt, den Grad der Separation zwischen den Ebenen zu bewerten. NIST beschreibt die Folgen unzureichender Trennung ausdrücklich: Sind Consumption und Protection Plane schlecht getrennt, kann ein Angreifer, der einen dem Gerät zugeordneten Host kontrolliert, nicht nur dessen Inhalt beschädigen, sondern auch Kopien und Sicherungen. Bei schlechter Trennung zwischen Consumption und Management Plane kann er weitere Speichergeräte erreichen. Als Einflussgrößen der Separation nennt NIST unter anderem Layer-2-Trennung über VLANs, getrennte IP-Subnetze, ACLs, die Managementoperationen auf dem Consumption Plane unterbinden, sowie getrennte Benutzer und Rollen je Ebene.
Angriff über den Datenpfad
Ein kompromittierter Server besitzt regulären Zugriff auf Storage. Bei Block Storage kann ein Host beispielsweise über Fibre Channel, iSCSI oder NVMe auf bereitgestellte Block Devices zugreifen. Die darüber liegende Dateisystem- und Anwendungslogik befindet sich auf dem Host. Ransomware kann deshalb Daten verändern, obwohl das Storage-System selbst nicht kompromittiert wurde. Der Storage Controller sieht dabei gültige Schreiboperationen eines autorisierten Initiators.
Bei File Storage ist die Situation anders. Hier verarbeitet das Storage-System beziehungsweise der File Service Dateioperationen über Protokolle wie SMB oder NFS und verfügt damit über eine andere Sicht auf die Zugriffe.
Angriff über die Management Plane
Davon getrennt ist eine Kompromittierung der administrativen Storage-Ebene. Über privilegierte Managementzugänge können, abhängig vom jeweiligen System und den eingeräumten Berechtigungen, wesentlich weitreichendere Operationen möglich sein als über den normalen Datenpfad. Deshalb reicht es nicht, nur Produktionsdaten gegen Veränderungen durch Hosts zu schützen. Auch die Recovery-Infrastruktur selbst muss gegen administrative Kompromittierung abgesichert werden.
Angriff über den Data Protection Plane
Getrennt von beiden liegt der Zugriff auf die Schutzmechanismen selbst. Wer Snapshot-Zeitpläne, Retention-Einstellungen oder Replikationsbeziehungen verändern kann, greift die Wiederherstellbarkeit an, ohne die Produktionsdaten zu berühren. Der Angriff wird auf dem Datenpfad nicht sichtbar und hinterlässt in den Produktionsdaten zunächst keine Spur.
Cyber Resilience muss alle drei Pfade berücksichtigen.
Snapshots: schneller Recovery Point, aber nicht automatisch Cyber-Schutz
Snapshots gehören zu den wichtigsten Recovery-Mechanismen moderner Enterprise-Storage-Systeme. Sie bilden einen Datenbestand zu einem definierten Zeitpunkt logisch ab und können dadurch eine schnelle Rückkehr zu einem früheren Zustand ermöglichen. Ihre Existenz allein macht ein Storage-System jedoch noch nicht ransomware-resilient.
Entscheidend ist die technische Abhängigkeit des Snapshots von den Produktionsdaten. NIST SP 800-209 beschreibt dieses Verhalten in Abschnitt 2.11.5 ausdrücklich. Ein Snapshot ist dort eine speichereffiziente Form der Point-in-Time-Kopie, die lediglich die gegenüber einem definierten Zeitpunkt veränderten Datenanteile speichert, bezogen auf die Quelldaten. Ist die Quelle nicht verfügbar, sind die Snapshots häufig ebenfalls nicht nutzbar. Ein Snapshot ist damit ein Recovery Point, aber nicht zwangsläufig eine unabhängige Datenkopie.
Für die Architektur müssen deshalb mehrere Begriffe getrennt werden. Ein Snapshot, ein unveränderbarer Snapshot, eine unabhängige Recovery Copy, ein Backup und ein Air Gap beschreiben unterschiedliche Schutzeigenschaften. Sie lassen sich nicht gegeneinander austauschen.
Immutability schützt den Recovery Point
Ein nächster Schutzmechanismus besteht darin, Recovery Points nach ihrer Erstellung gegen Veränderung oder Löschung zu sperren. Der entscheidende Unterschied zu einem normalen Snapshot liegt nicht darin, dass die Daten zwangsläufig anders gespeichert werden. Entscheidend ist, welche Operationen auf dem Recovery Point nach seiner Erstellung noch zulässig sind.
Damit entsteht eine weitere Frage: Wer darf die Schutzfunktion aufheben? NIST beantwortet sie über die Kontrollanforderung DP-SS-R4. Die Konfiguration des Datenschutzes einschließlich Backup, Point-in-Time-Kopien und Replikation soll zentral verwaltet und vom Data Consumption Plane getrennt werden. Server und Clients dürfen ihre eigene Datenschutzkonfiguration nicht verändern. Ein Recovery Point, dessen Schutzperiode von demselben Host aus aufgehoben werden kann, der die Produktionsdaten schreibt, erfüllt diese Anforderung nicht.
Ist ein Recovery Point zwar gegen normale Hosts geschützt, kann aber über dieselbe kompromittierte administrative Ebene gelöscht oder seine Retention verändert werden, bleibt eine gemeinsame Failure Domain bestehen. Immutability muss deshalb immer zusammen mit dem jeweiligen Berechtigungs- und Administrationsmodell betrachtet werden. Die Aussage „immutable" allein beschreibt noch keine vollständige Cyber-Resilience-Architektur.
Administrative Isolation wird zur eigenen Schutzschicht
Klassische Hochverfügbarkeit und Cyber Resilience adressieren unterschiedliche Fehlerklassen. Zwei Controller können gegen den Ausfall eines Controllers schützen. Zwei Storage-Systeme an unterschiedlichen Standorten können gegen bestimmte Standortausfälle schützen. Ein Cyberangriff überschreitet dagegen administrative Grenzen.
Verwenden Produktions- und Recovery-System dieselben privilegierten Identitäten, dieselben Managementsysteme oder dieselben administrativen Zugriffspfade, kann die physische Trennung der Systeme allein unzureichend sein.
NIST formuliert die notwendige Rollentrennung in AC-SS-R20 konkret. Die Berechtigungen für Datenverwaltung, etwa das Anlegen und Zuordnen eines Volumes, und für Datensicherung, etwa das Konfigurieren, Anhalten und Löschen von Backups, sollen unterschiedlichen Rollen zugewiesen werden. Ebenso sollen sich die Berechtigungen für Datenverwaltung und Host-Administration unterscheiden. Die Begründung ist explizit: Wer einen Host oder eine Host-Administratorrolle übernimmt, soll die zugehörigen Datenbestände, Backups und Replikate nicht ohne Weiteres kompromittieren können.
Eine Cyber-Resilience-Architektur muss deshalb nicht nur fragen, wo sich die Daten befinden, sondern auch, über welche Identitäten, Managementpfade und Systeme sie verändert oder gelöscht werden können. Damit werden Management Plane und Identity Infrastructure Teil der Storage-Architektur.
Replikation ist nicht automatisch eine Recovery-Lösung
Storage-Replikation erhöht die Verfügbarkeit von Daten, löst aber ein grundsätzliches Problem nicht: Sie repliziert Änderungen. Werden Produktionsdaten durch einen kompromittierten Host verändert und diese Änderungen anschließend auf das Zielsystem übertragen, kann auch die replizierte Datenkopie betroffen sein.
Das bedeutet nicht, dass Replikation für Cyber Resilience ungeeignet ist. Sie erfüllt nur eine andere Funktion. Für Cyber Recovery muss festgelegt werden, welche Recovery Points auf dem Ziel erhalten bleiben und welche Änderungen nicht mehr auf bereits geschützte Zustände durchschlagen dürfen.
NIST adressiert die Replikationsbeziehung selbst als Angriffsfläche. AC-SS-R6 verlangt, Vertrauensbeziehungen zur Replikation zwischen Arrays zu deaktivieren, wenn keine gemeinsamen replizierten Volumes bestehen, und die wechselseitigen Rechte andernfalls auf die tatsächlich gemeinsam genutzten Volumes zu begrenzen. DP-SS-R5 fordert zusätzlich, dass das Schutzniveau des Primärsystems auf das Zielsystem übertragen wird. Beides verkleinert die gemeinsame Failure Domain, ersetzt aber nicht den Mechanismus, der einen früheren vertrauenswürdigen Zustand erhält.
Eine resiliente Architektur kann Replikation verwenden. Sie benötigt darüber hinaus jedoch einen Weg zurück zu einem Zustand, den der Angreifer nicht mehr erreichen konnte.
Isolation: Die Failure Domain verkleinern
Die Schutzwirkung nimmt zu, wenn Recovery-Daten von den Komponenten getrennt werden, über die Produktionsdaten kompromittiert werden können.
Eine vereinfachte Schutzkette beginnt bei den Produktionsdaten und führt über den Snapshot zum geschützten, unveränderbaren Recovery Point. Von dort geht sie weiter zu einer separaten Recovery Copy und schließlich zu einer Recovery-Umgebung, die administrativ und netzwerktechnisch von der Produktion getrennt ist.
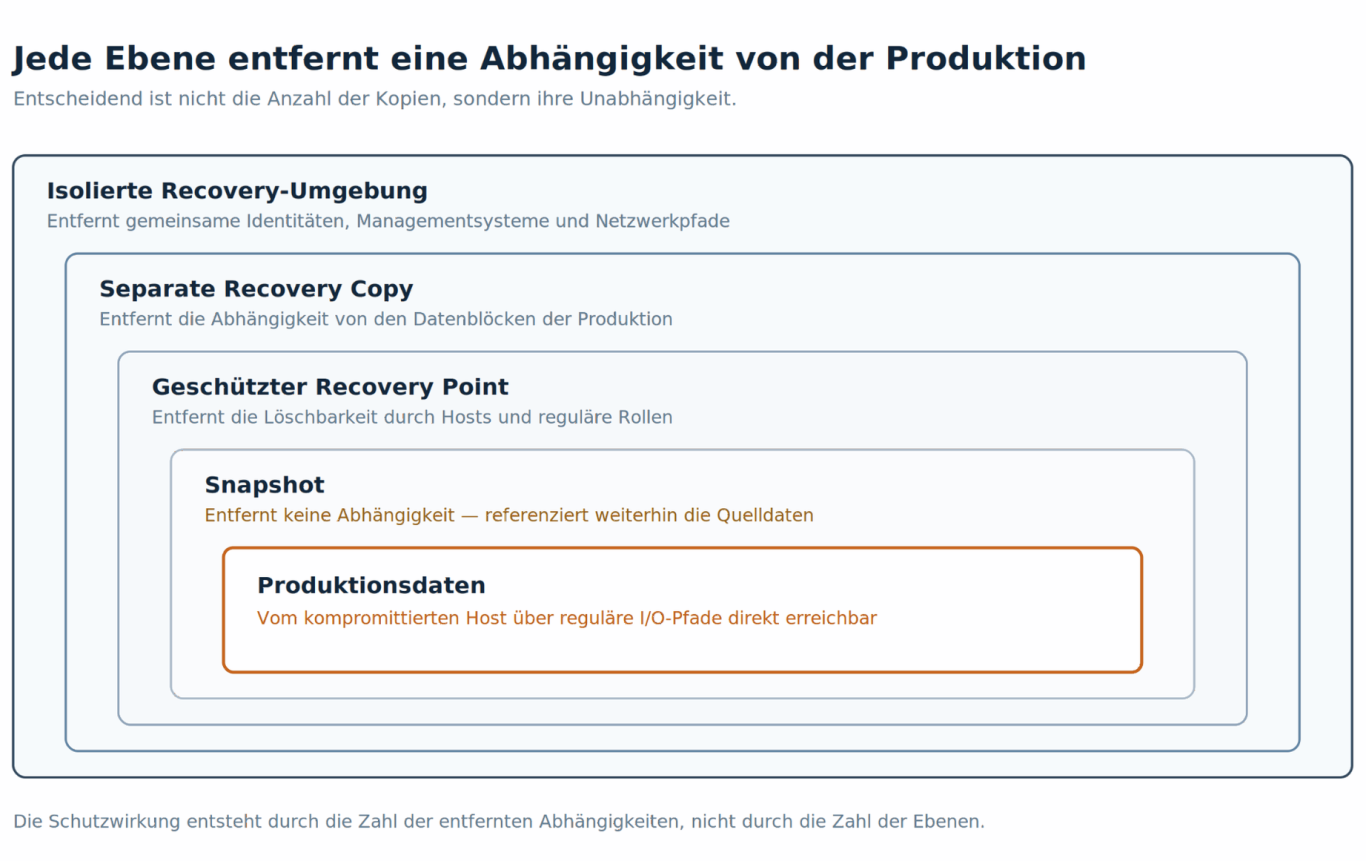
Dabei handelt es sich nicht einfach um mehrere Kopien derselben Art. Jede Ebene soll eine zusätzliche Abhängigkeit von der Produktionsumgebung entfernen. Die entscheidende Größe ist deshalb nicht die Anzahl der Kopien, sondern deren Unabhängigkeit.
Air Gap ist kein einheitlicher Begriff
Der Begriff Air Gap wird in Storage-Architekturen unterschiedlich verwendet. NIST SP 800-209 beschreibt eine strikte Air-Gap-Implementierung als vollständige physische und netzwerktechnische Separation. Gleichzeitig weist NIST darauf hin, dass Storage-Technologien auch weniger strikte Isolationsmechanismen als Air-Gapping bezeichnen, etwa Systeme, deren Datenports nur während definierter Synchronisationsfenster geöffnet werden. Diese Architekturen besitzen unterschiedliche Sicherheitseigenschaften.
Bei einem physischen Air Gap besitzt das Recovery-System keine permanente physische oder netzwerktechnische Verbindung zur Produktionsumgebung. Das maximiert die Isolation, erschwert aber die automatisierte Übertragung aktueller Recovery Points.
Bei zeitweiser Isolation wird eine Verbindung nur während definierter Zeitfenster hergestellt. Damit lassen sich Daten automatisiert übertragen. Während des Verbindungsfensters existiert jedoch ein Kommunikationspfad zwischen den Systemen.
Bei logischer Isolation wird der Zugriff über Netzwerksegmentierung, getrennte Credentials, Berechtigungsmodelle oder Storage-interne Schutzmechanismen eingeschränkt. Eine solche Architektur kann erhebliche Schutzwirkung besitzen, entspricht aber nicht einer vollständigen physischen Trennung.
Zu fragen, ob ein System einen Air Gap besitzt, führt deshalb nicht weit. Technisch präziser ist die Frage, welche Kommunikations- und Administrationspfade zwischen Produktion und Recovery bestehen und wann sie verfügbar sind.
Angriffserkennung im Storage
Neben dem Schutz vorhandener Recovery Points integrieren Enterprise-Storage-Systeme zunehmend Mechanismen zur Erkennung ungewöhnlicher Veränderungen. Dabei muss zwischen verschiedenen Beobachtungsebenen unterschieden werden.
Endpoint-Security sieht Prozesse, Benutzer und Betriebssystemaktivitäten. Ein File Service kann Dateioperationen und, abhängig von Architektur und Protokoll, weitere Dateimetadaten beobachten. Ein Block-Storage-System sieht dagegen primär I/O auf Blockebene. Die verschiedenen Ebenen besitzen damit unterschiedliche Informationen über denselben Angriff.
Storage-seitige Erkennung sollte deshalb nicht als Ersatz für Endpoint- oder Security-Monitoring betrachtet werden. Sie stellt einen zusätzlichen Beobachtungspunkt im Datenpfad dar. Welche Parameter tatsächlich analysiert werden und welche Reaktionen daraus abgeleitet werden können, ist produktspezifisch und muss anhand der jeweiligen Herstellerimplementierung bewertet werden.
Detection ohne Recovery reicht nicht
Eine Alarmmeldung allein stellt keine Daten wieder her. Die eigentliche Cyber-Resilience-Kette führt von der Erkennung über Containment und die Identifikation eines geeigneten Recovery Points zur Wiederherstellung, deren Validierung und schließlich zur Rückkehr in den Produktivbetrieb.
Dabei entsteht ein schwieriges Problem: Welcher Recovery Point ist tatsächlich sauber? Der zeitlich jüngste Snapshot muss nicht der richtige sein. Befand sich der Angreifer bereits vor der Erkennung im System oder wurden Daten schon vorher manipuliert, kann auch ein jüngerer Recovery Point kompromittierte Daten enthalten.
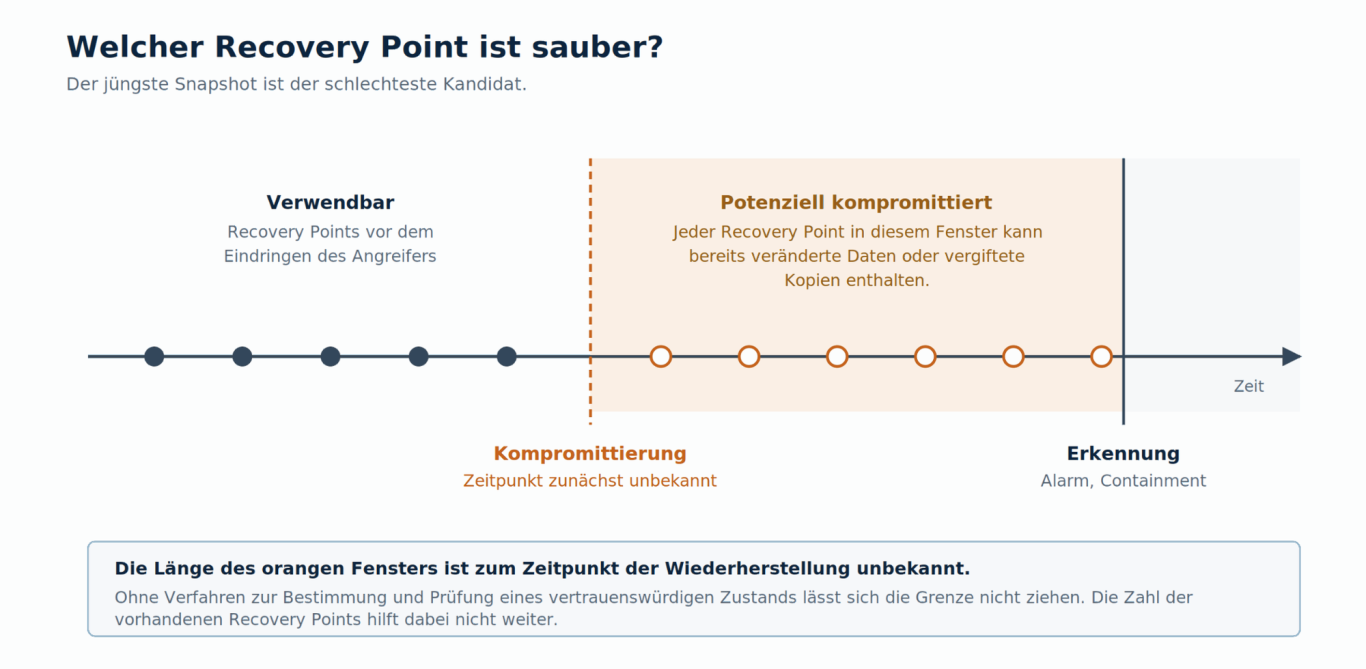
NIST SP 800-209 beschreibt in Abschnitt 3.2.4, warum diese Frage schwer zu beantworten ist. Lassen sich vorhandene Kopien nicht kompromittieren, besteht eine wirksame Angriffsstrategie darin, den Sicherungsprozess selbst zu stören und künftige Kopien schrittweise zu vergiften. Ist genügend Zeit vergangen, kann der Angreifer die Primärdaten angreifen im Wissen, dass die verbleibenden nutzbaren Kopien zu alt sind. Eine zweite Variante zielt auf Sicherungen von Betriebssystem-Images, Softwarepaketen, Firmware oder Quellcode-Repositories, sodass beim Wiederaufbau einer Umgebung Teile der Schadsoftware zurückkehren.
NIST SP 1800-11 beschreibt Wiederherstellung nach Ransomware und anderen zerstörerischen Ereignissen entsprechend als Rückkehr zu einem identifizierten letzten bekannten guten Zustand. Die Recovery-Architektur benötigt somit nicht nur genügend Wiederherstellungspunkte, sondern auch Verfahren, mit denen sich ein vertrauenswürdiger Zustand bestimmen und überprüfen lässt.
Crash-consistent ist nicht automatisch application-consistent
Auch ein technisch intakter Snapshot garantiert nicht, dass eine Anwendung unmittelbar daraus wieder gestartet werden kann. Ein Storage-System kann den Zustand seiner Blöcke zu einem bestimmten Zeitpunkt konsistent erfassen. Anwendungen besitzen jedoch eigene Zustände, etwa Transaktionen, Datenbank-Logs oder Daten, die sich noch im Arbeitsspeicher befinden.
Deshalb muss zwischen Storage- beziehungsweise Crash-Konsistenz und Application Consistency unterschieden werden. Für die Recovery-Planung ist das entscheidend. Ein Recovery Point kann auf Storage-Ebene vollständig vorhanden sein und trotzdem zusätzliche Recovery-Schritte der Anwendung benötigen. Cyber Resilience endet daher nicht an der Grenze des Storage Arrays.
RPO und RTO verändern die Architektur
Cyber Resilience besitzt einen direkten Zusammenhang mit RPO und RTO. Die Häufigkeit geschützter Recovery Points beeinflusst, wie weit im schlimmsten Fall zurückgegangen werden muss. Eine höhere Frequenz verkürzt die zeitlichen Abstände zwischen verfügbaren Recovery Points, erhöht aber abhängig von der Implementierung den Bedarf an Kapazität, Metadaten und Management.
Das RTO hängt wiederum nicht nur davon ab, wie schnell Daten gelesen werden können. Relevant sind ebenso das Datenvolumen, die Art des Recovery-Verfahrens, die verfügbare Storage- und Netzwerkbandbreite, der Grad der Parallelisierung, die notwendige Validierung, die Wiederherstellung abhängiger Infrastruktur und das Applikations-Recovery.
Ein mehrere hundert Terabyte großes Volume vollständig zu kopieren und einen vorhandenen Snapshot beziehungsweise Clone unmittelbar bereitzustellen sind architektonisch unterschiedliche Recovery-Verfahren. Deshalb sollte eine Cyber-Resilience-Architektur nicht nur festlegen, welche Daten geschützt werden, sondern auch, wie sie im Ernstfall wieder produktiv bereitstehen.
Eine mehrstufige Storage-Architektur
Aus den einzelnen Mechanismen lässt sich ein mehrstufiges Modell ableiten.
Am Anfang steht der Schutz der Produktion. Zugriffskontrolle, Segmentierung und Absicherung der Management Plane reduzieren die Angriffsfläche. Darauf folgt die Erkennung, bei der Storage- und externe Security-Systeme unterschiedliche Hinweise auf ungewöhnliche Datenveränderungen liefern.
Die dritte Stufe bilden die Recovery Points selbst. Snapshots und andere Point-in-Time-Kopien erhalten frühere Datenzustände. Immutability sichert diese Zustände ab, indem sie deren nachträgliche Veränderung innerhalb der definierten Schutzperiode erschwert oder verhindert.
Isolation trennt anschließend die Failure Domains administrativ, logisch, netzwerktechnisch oder physisch. Sie reduziert die Wahrscheinlichkeit, dass ein einzelner kompromittierter Zugriffspfad Produktion und Recovery gleichzeitig erreicht. Am Ende steht die Wiederherstellung, bei der ein identifizierter vertrauenswürdiger Datenzustand in einer kontrollierten Umgebung zurückgeholt und validiert wird.
Keine dieser Ebenen ersetzt die anderen. Cyber Resilience entsteht aus ihrem Zusammenspiel.
Die entscheidenden Fragen bei der Architekturplanung
Für die Bewertung eines Enterprise-Storage-Systems reichen Fragen nach Performance, Kapazität und Verfügbarkeit nicht aus.
Zu den Recovery Points gehört zu klären, wie Wiederherstellungspunkte erzeugt werden, wie lange sie aufbewahrt werden und ob sie von Produktionsdaten oder Produktionsmetadaten abhängen. Bei der Immutability ist entscheidend, wer einen geschützten Recovery Point löschen oder dessen Retention verändern kann.
Für Management Plane und Isolation stellt sich die Frage, welche administrativen Identitäten Zugriff auf Produktion und Recovery besitzen und welche Netzwerk-, Management- und Datenpfade beide Umgebungen verbinden. Bei der Erkennung ist zu klären, welche Ereignisse die Storage-Schicht tatsächlich erkennen kann und auf welcher Datengrundlage.
Für die Wiederherstellung selbst sind mehrere Punkte zu prüfen: ob Recovery Points lediglich storage- beziehungsweise crash-consistent oder auch mit der Anwendung koordiniert sind, wie ein Recovery Point nach einem Angriff bereitgestellt wird, wie sich feststellen lässt, dass der ausgewählte Zustand nicht bereits kompromittiert ist, und ob nicht nur die Sicherung, sondern auch der tatsächliche Recovery-Prozess die Anforderungen an RPO und RTO erfül
Fazit
Cyber Resilience verändert die Betrachtung von Enterprise Storage. Ein hochverfügbares Storage-System kann gegen Hardware- oder Komponentenfehler ausgelegt sein und dennoch keine ausreichende Isolation gegen einen Cyberangriff besitzen. Ebenso kann ein System zahlreiche Snapshots vorhalten, ohne dass daraus unabhängige Recovery Copies entstehen.
Die zentrale Architekturfrage lautet deshalb nicht, wie viele Kopien der Daten existieren. Sie lautet, welche Abhängigkeiten zwischen Produktion und Recovery bestehen und welche davon ein Angreifer gleichzeitig kontrollieren kann.
Snapshots, Immutability, Replikation, Angriffserkennung und Air-Gap-Technologien erfüllen dabei unterschiedliche Aufgaben. Erst wenn Recovery Points gegen die relevanten Angriffspfade geschützt, ausreichend isoliert und innerhalb eines definierten Recovery-Prozesses wiederherstellbar sind, entsteht aus Data Protection eine Cyber-Resilience-Architektur.
Quellen
National Institute of Standards and Technology (NIST): Security Guidelines for Storage Infrastructure, NIST Special Publication 800-209, Oktober 2020, DOI 10.6028/NIST.SP.800-209.
National Institute of Standards and Technology (NIST): Security Guidelines for Storage Infrastructure, NIST SP 800-209 Rev. 1, Initial Public Draft, 22. Juli 2026, DOI 10.6028/NIST.SP.800-209r1.ipd. Kommentierungsfrist bis 8. September 2026; zum Zeitpunkt dieses Artikels Entwurf, nicht finale Revision.
National Institute of Standards and Technology (NIST): Guide for Cybersecurity Event Recovery, NIST Special Publication 800-184, Dezember 2016, DOI 10.6028/NIST.SP.800-184.
National Institute of Standards and Technology (NIST): Data Integrity: Recovering from Ransomware and Other Destructive Events, NIST Special Publication 1800-11, September 2020, DOI 10.6028/NIST.SP.1800-11.
Welche Entscheidung steht bei Ihnen an?
Sie möchten eine bestehende Infrastruktur bewerten, eine neue Architektur planen oder eine konkrete technische Fragestellung klären? Sprechen Sie mit uns über Ihre Anforderungen.
Spezialist für moderne Dateninfrastruktur
