
WISSEN > ENTERPRISE STORAGE > ENTERPRISE STORAGE ARCHITEKTUR
Architekturansätze und ihre Unterschiede
Autor: Dirk Neumann Geschäftsführer ASSISTRA Cloud Services GmbH 17.08.2026
Enterprise Storage
Das sollten Sie mitnehmen:
- Dual Controller bündelt Storage-Funktionen in einer Plattform.
Entscheidend sind Write-Absicherung, Controller-Ressourcen und die Grenzen des vorgesehenen Ausbaus.
- Scale-out erweitert mehr als Kapazität.
Der Vorteil entsteht dort, wo zusätzliche Nodes auch die für den Workload nötige Verarbeitung mitbringen.
- Distributed Storage vergrößert die Failure Domain.
Datenverteilung, Cluster-Software und Netzwerk werden Bestandteil von Verfügbarkeit und Recovery.
- Disaggregation entkoppelt Ressourcen.
NVMe-oF ermöglicht neue Datenpfade, ersetzt aber weder Data Protection noch Failure Handling.
- Der Workload entscheidet, welcher Unterschied zählt.
Performance, Wachstum, Verfügbarkeit und Betriebsmodell bestimmen gemeinsam die passende Architektur.

Inhaltsverzeichnis
- 1. Dual Controller und Scale-up: eine integrierte Storage-Plattform
- 2. Scale-out: zusätzliche Nodes bringen zusätzliche Ressourcen
- 3. Distributed und Software-defined Storage: der Cluster wird zum Storage-System
- 4. Recovery: entscheidend ist nicht nur, was ausfallen darf
- 5. Disaggregierte Architekturen: Compute und Storage entkoppeln
- Die vier Architekturansätze im Vergleich
- Wachstum kann die Entscheidung verändern
- Architektur ist die Grundlage der Produktauswahl
- Fazit
- Quellen
Enterprise-Storage-Systeme wirken auf den ersten Blick oft austauschbar. Sie stellen Block- oder File Storage bereit, bieten Snapshots und Replikation, verwenden Flash-Medien und versprechen hohe Verfügbarkeit. Technisch stehen dahinter jedoch grundlegend unterschiedliche Architekturen.
Ein klassisches Enterprise Array verarbeitet I/O über redundante Controller. Scale-out-Systeme verteilen Verarbeitung und Kapazität auf mehrere Nodes. Bei Software-defined Storage stellt eine Softwareschicht die Storage-Funktionen über einen Cluster bereit. Disaggregierte Ansätze entkoppeln Compute und Storage noch stärker voneinander.
Relevant werden diese Unterschiede, sobald ein System wächst, ein Controller ausfällt oder Daten rekonstruiert werden müssen. Dann entscheidet die Architektur darüber, welche Ressourcen beteiligt sind und wie sich das System verhält.
Dual Controller und Scale-up: eine integrierte Storage-Plattform
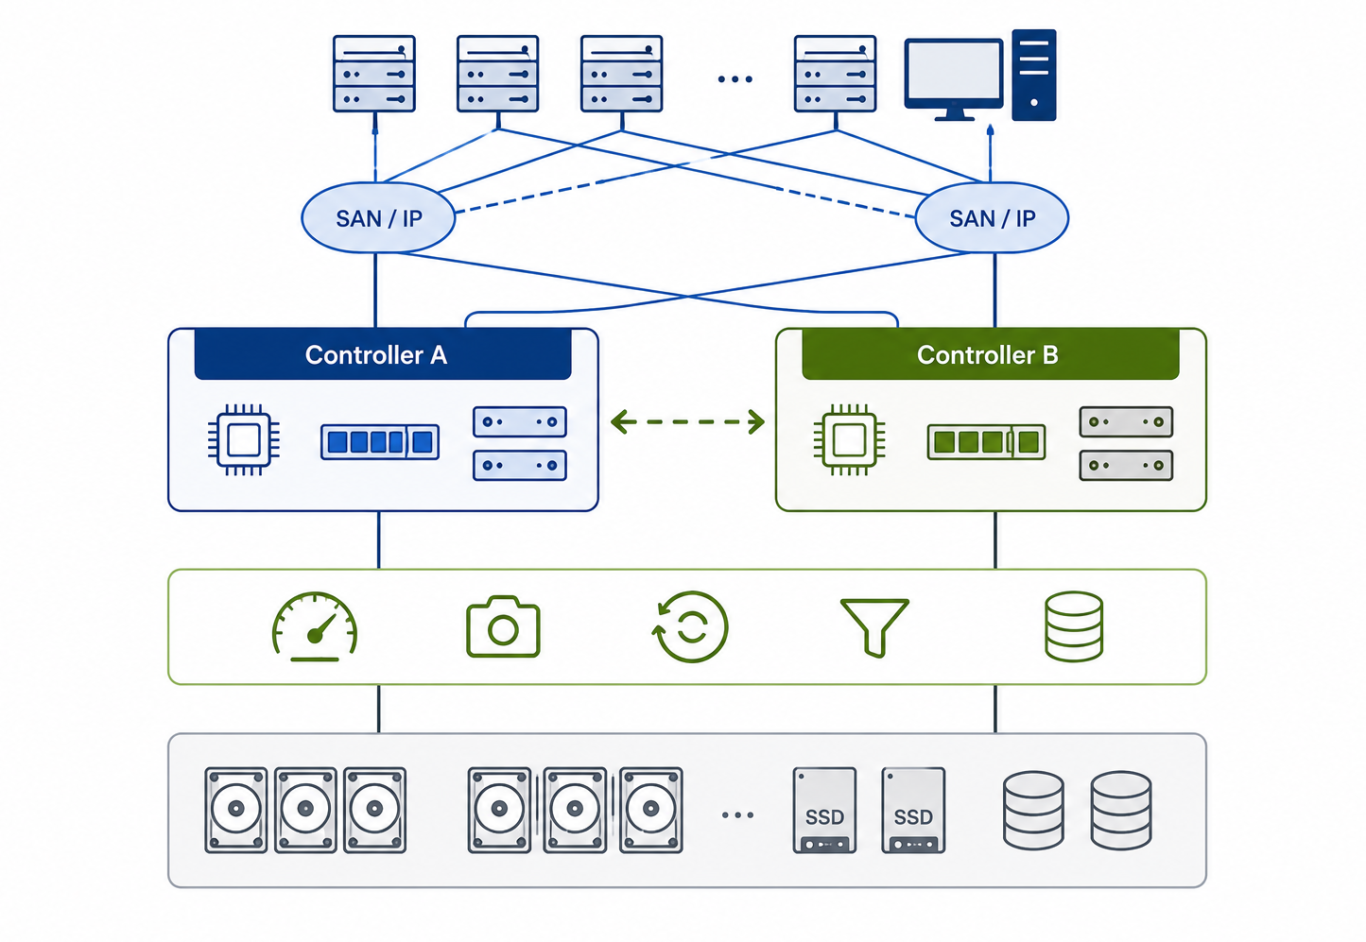
Die klassische Enterprise-Storage-Architektur besteht aus redundanten Controllern und den dahinterliegenden Storage-Ressourcen. Server greifen über ein SAN oder ein IP-Netzwerk auf die Controller zu, dort werden die I/Os verarbeitet, und dahinter liegen Cache, Data Services und die Storage-Medien.
Die Controller stellen die zentralen Funktionen bereit: Cache, Snapshots, Replikation, Datenreduktion. Kapazität wächst innerhalb der vom System vorgesehenen Grenzen durch zusätzliche Laufwerke oder Enclosures. Die Stärke dieses Ansatzes liegt in der engen Integration. Datenpfad, Cache, Hochverfügbarkeit und Data Services werden innerhalb einer definierten Plattform koordiniert, und der Hersteller verantwortet das Zusammenspiel.
Was geschieht mit einem Write?
Warum die Controller-Architektur relevant ist, zeigt sich am Schreibpfad.
Ein Storage-System sollte einen Schreibvorgang nicht als persistent bestätigen, solange die einzige aktuelle Kopie ausschließlich in flüchtigem Speicher liegt. Enterprise-Systeme verwenden deshalb Mechanismen, um bestätigte Writes gegen definierte Fehler abzusichern. Die konkrete Umsetzung unterscheidet sich zwischen den Herstellern. Bei HA-Architekturen wird Write Cache beziehungsweise NVRAM häufig zwischen den Controllern gespiegelt. NetApp dokumentiert für ONTAP-HA-Paare ein solches Verfahren: Änderungen werden auch im NVRAM des Partner-Nodes protokolliert, bevor sie später auf persistenten Storage geschrieben werden.
Für die Bewertung eines Dual-Controller-Systems sind deshalb konkretere Fragen wichtiger als die Angabe „Active-Active". Wann wird ein Write bestätigt? Wo ist er zu diesem Zeitpunkt abgesichert? Und wie verändert sich der Datenpfad, wenn ein Controller ausfällt?
Dazu gehört auch die Performance im Fehlerfall. Übernimmt ein Controller zusätzliche Aufgaben, müssen seine Ressourcen die verbleibende Last verarbeiten können.
Scale-up hat mehrere Dimensionen
Bei Scale-up wird die vorhandene Plattform erweitert. Dabei lohnt sich die Unterscheidung zwischen Kapazität und Verarbeitung.
Zusätzliche Medien erhöhen die Kapazität und können zusätzliche Backend-Parallelität bereitstellen. Controller, Cache, Frontend-Ports und interne Verbindungen wachsen dagegen nicht zwangsläufig im gleichen Verhältnis mit. Ein Storage-System kann deshalb noch erhebliche Kapazitätsreserven besitzen, während eine andere Systemressource für einen bestimmten Workload längst zum begrenzenden Faktor geworden ist.
Die Frage bei Scale-up lautet damit nicht nur, wie viele Terabyte in das System passen. Ebenso wichtig ist, welche Ressourcen bis zur maximalen Ausbaustufe zur Verfügung stehen.
Scale-out: zusätzliche Nodes bringen zusätzliche Ressourcen
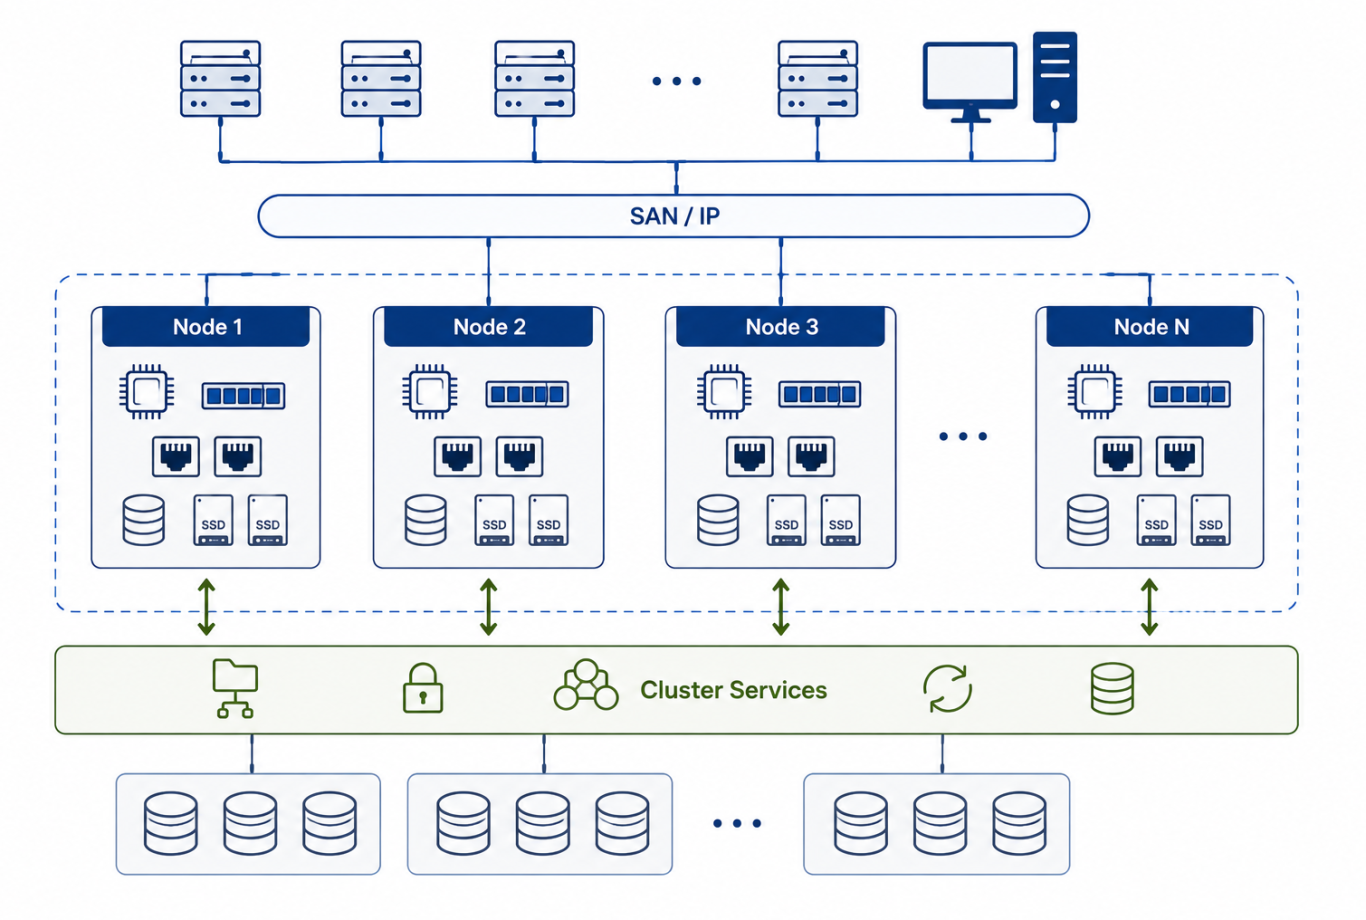
Scale-out verändert dieses Modell. Das System wächst nicht nur durch zusätzliche Medien, sondern durch weitere Nodes beziehungsweise Controller. Ein zusätzlicher Node kann – abhängig von der Implementierung – CPU, Memory, Netzwerk und Storage gemeinsam bereitstellen. Kapazität und Verarbeitungsleistung wachsen dann zusammen.
Der Architekturvorteil entsteht allerdings nicht dadurch, dass sich Nodes hinzufügen lassen. Relevant ist, welche Ressourcen mit jedem Node tatsächlich mitwachsen.
Was bleibt gemeinsam?
Auch ein Scale-out-System benötigt Koordination. Datenplatzierung, Clusterzustand, Fehlerbehandlung und Metadaten müssen über mehrere Komponenten hinweg verwaltet werden. Daraus ergibt sich eine Frage, die bei jedem Vergleich gestellt werden sollte: Was ist tatsächlich verteilt, und was bleibt eine gemeinsam genutzte oder anders skalierende Ressource? Ein System kann seinen Datenpfad horizontal verteilen, während bestimmte Metadaten- oder Koordinationsfunktionen einem anderen Skalierungsmodell folgen.
Bei Scale-out File Systems kommen weitere Aufgaben hinzu. Die SNIA nennt in ihrem Überblick zur Scale-Out-File-System-Architektur unter anderem Namespace-Konsistenz, Distributed Locking und Datenreplikation als typische Herausforderungen, sobald viele Compute-Nodes gleichzeitig zugreifen.
Scale-out bedeutet deshalb nicht automatisch lineare Performance-Skalierung. Es bedeutet zunächst, dass sich Systemressourcen horizontal hinzufügen lassen. Wie effizient diese genutzt werden, hängt von der konkreten Architektur ab.
Distributed und Software-defined Storage: der Cluster wird zum Storage-System
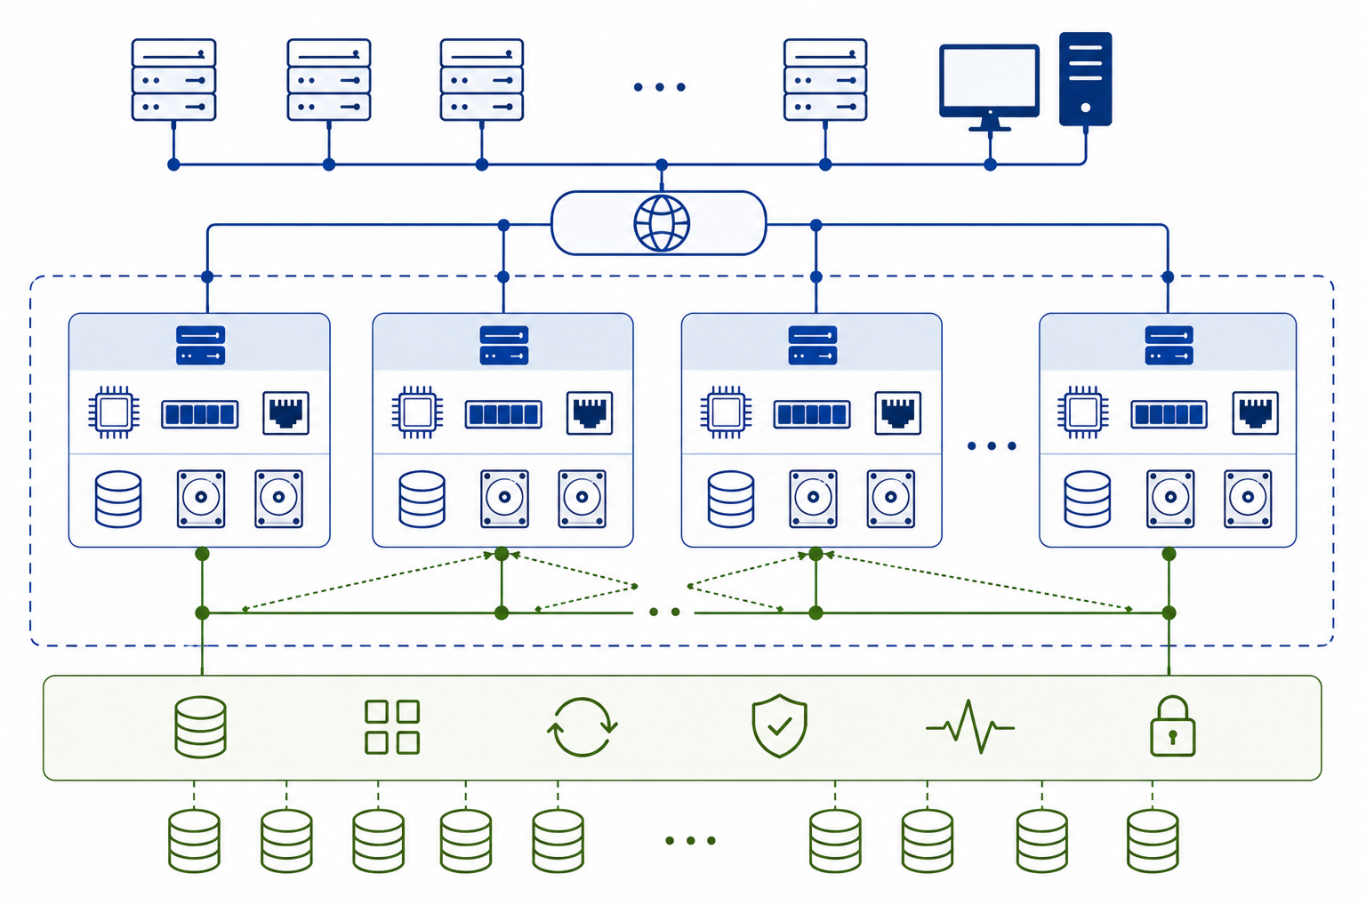
Distributed beziehungsweise Software-defined Storage verlagert Storage-Funktionen in eine Software-Schicht, die mehrere Nodes zu einem gemeinsamen System verbindet. Jeder Node bringt CPU, Memory, Netzwerk und Storage-Medien ein, und die Summe dieser Nodes bildet den Cluster.
Damit verändert sich eine wesentliche Eigenschaft: Das Netzwerk zwischen den Nodes wird selbst zum Bestandteil der Storage-Architektur. Das betrifft nicht nur den produktiven Datenverkehr, sondern auch Datenverteilung, Rebalancing und Recovery.
Aus dem Laufwerk wird eine größere Failure Domain
Bei einer klassischen RAID-Betrachtung steht der Ausfall einzelner Medien im Vordergrund. In einer verteilten Architektur stellt dagegen ein kompletter Node eine relevante Failure Domain dar. Mit ihm fallen gleichzeitig mehrere Laufwerke, Rechenressourcen und Netzwerkverbindungen aus.
Die Daten müssen deshalb so über das System verteilt werden, dass die vorgesehenen Fehlerfälle toleriert werden. Dafür kommen Replikation oder Erasure Coding infrage. Bei Replikation werden zusätzliche vollständige Kopien gespeichert. ErasureCoding erzeugt stattdessen zusätzliche Redundanzinformationen, aus denen sich verlorene Daten rekonstruieren lassen, solange ausreichend Fragmente vorhanden sind.
Erasure Coding reduziert gegenüber mehrfacher vollständiger Replikation die benötigte redundante Kapazität. Dafür wird die Rekonstruktion selbst zu einem wichtigen Bestandteil der Architektur.
Hardware und Lifecycle laufen auseinander
Neben dem Datenpfad verändert sich noch etwas, das im Betrieb schnell relevant wird.
Bei einer Appliance definiert der Hersteller die Node-Hardware, testet die Ausbaustufen und liefert Firmware und Storage-Software als gemeinsamen Lifecycle. Bei Software-defined Storage sind diese Ebenen getrennt. Node-Zusammenstellung, Netzwerkdesign und Dimensionierung liegen beim Betreiber, Hardware- und Software-Lifecycle laufen unabhängig voneinander. Das erweitert die Gestaltungsfreiheit erheblich und verlagert gleichzeitig Verantwortung – für die Auslegung ebenso wie für die Fehlerdiagnose, die im Zweifel über zwei Supportwege läuft.
Recovery: entscheidend ist nicht nur, was ausfallen darf
Die Aussage, ein System toleriere den Ausfall eines Nodes, beschreibt nur einen Teil des Fehlerverhaltens. Nach dem Ausfall muss das System den vorgesehenen Protection-Zustand wiederherstellen.
Bei Erasure-Coded Storage müssen dafür mehrere verbliebene Daten- und Redundanzfragmente gelesen werden. Daraus werden die fehlenden Informationen rekonstruiert und anschließend wieder auf geeignete Ressourcen geschrieben. Recovery beansprucht damit gleichzeitig Storage-I/O, CPU und Netzwerk.
Genau dieser Zusammenhang ist ein eigenes Forschungsgebiet. Arbeiten zu Repair-Verfahren bei Erasure-Coded Distributed Storage untersuchen unter anderem, wie sich der für eine Rekonstruktion notwendige Netzwerk- und I/O-Aufwand reduzieren lässt.
Für einen Architekturvergleich sollten deshalb zwei Fragen getrennt werden. Availability: Bleiben Daten und Services während eines definierten Fehlers verfügbar? Recovery: Wie stellt das System anschließend den vorgesehenen Redundanzzustand wieder her?
Ein System kann während eines Fehlers vollständig verfügbar bleiben und dennoch erhebliche Ressourcen für die anschließende Rekonstruktion benötigen. Für den IT-Betrieb ist deshalb nicht nur die tolerierte Failure Domain relevant, sondern auch, wie Recovery und produktiver Workload dieselben Ressourcen nutzen.
Disaggregierte Architekturen: Compute und Storage entkoppeln
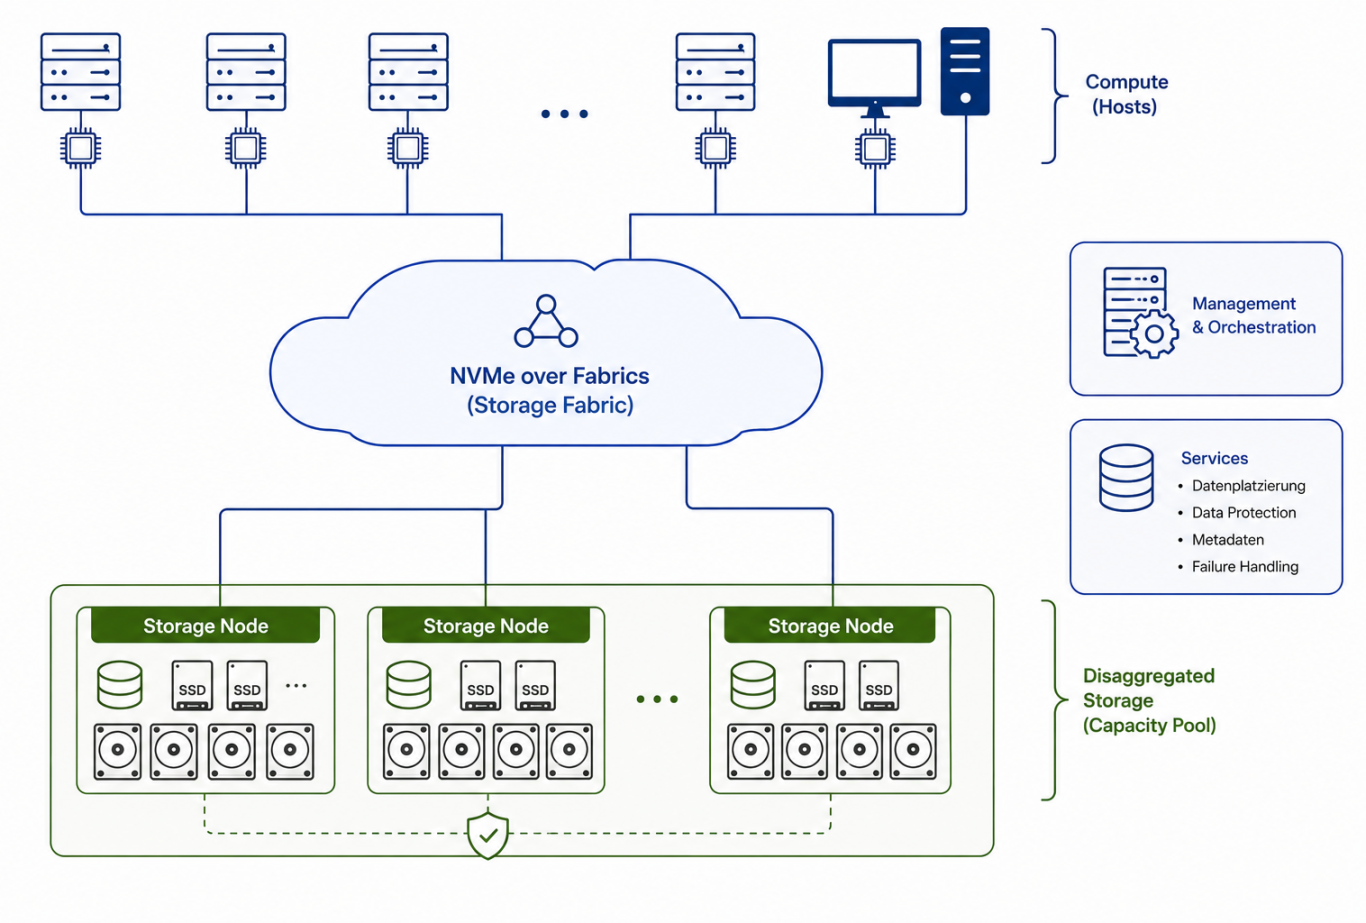
Ein weiterer Ansatz trennt Compute und Storage stärker voneinander. Zwischen beiden liegt eine Fabric, und Storage-Kapazität und Compute-Ressourcen lassen sich dadurch unabhängiger voneinander bereitstellen und skalieren.
NVMe over Fabrics ist eine Technologie, die solche Architekturen ermöglicht. NVMe-Kommandos werden dabei über eine Fabric zwischen Host und Storage transportiert. Seit NVMe 2.0 sind die entsprechenden Funktionen Bestandteil der modularisierten NVMe-Spezifikationsfamilie.
Eine vollständige Storage-Architektur ist NVMe-oF damit noch nicht. Es löst die Frage des Datenpfads zwischen Initiator und Storage Target. Datenplatzierung, Data Protection, Metadaten und Failure Handling müssen weiterhin von der Storage-Architektur bereitgestellt werden.
NVMe gegen Fibre Channel?
Auch die häufige Gegenüberstellung von NVMe und Fibre Channel greift zu kurz. NVMe beschreibt Command Sets und Queuing-Mechanismen, Fibre Channel ist eine Fabric-Technologie. NVMe kann über Fibre Channel transportiert werden, daneben existieren NVMe/TCP und NVMe/RDMA.
Die eigentliche Frage lautet deshalb: Welchen Weg nimmt ein I/O vom Server bis zum persistenten Medium? Ein moderneres Frontend-Protokoll kann Teile dieses Pfades effizienter gestalten. Die Gesamtlatenz wird aber weiterhin durch Controller-Verarbeitung, Data Services, interne Kommunikation und die Storage-Medien beeinflusst.
Die Architektur muss zum Workload passen
Diese unterschiedlichen Datenpfade erklären, warum ein Storage-System nicht allein anhand seiner maximalen IOPS bewertet werden sollte.
Ein Datenbank-Workload mit kleinen und häufig synchronen I/Os stellt andere Anforderungen als große sequenzielle Datenströme. Virtualisierung wiederum führt viele unterschiedliche Workloads auf einer gemeinsamen Plattform zusammen.
Bei latenzsensitiven Anwendungen ist die entscheidende Frage deshalb nicht, welches System den höchsten Durchsatz erreicht. Ein Array kann seine Spitzenwerte bei hoher Queue Depth und großen Blöcken ausweisen und gleichzeitig bei kleinen synchronen Schreibvorgängen mit Queue Depth 1 eine Latenz liefern, die die Anwendung nicht toleriert. Beide Werte stammen aus demselben System und beschreiben unterschiedliche Betriebspunkte. Für eine Datenbank, deren Commit auf den Write Acknowledge wartet, ist der zweite Wert der relevante.
Bei solchen Workloads muss deshalb der gesamte Pfad betrachtet werden.
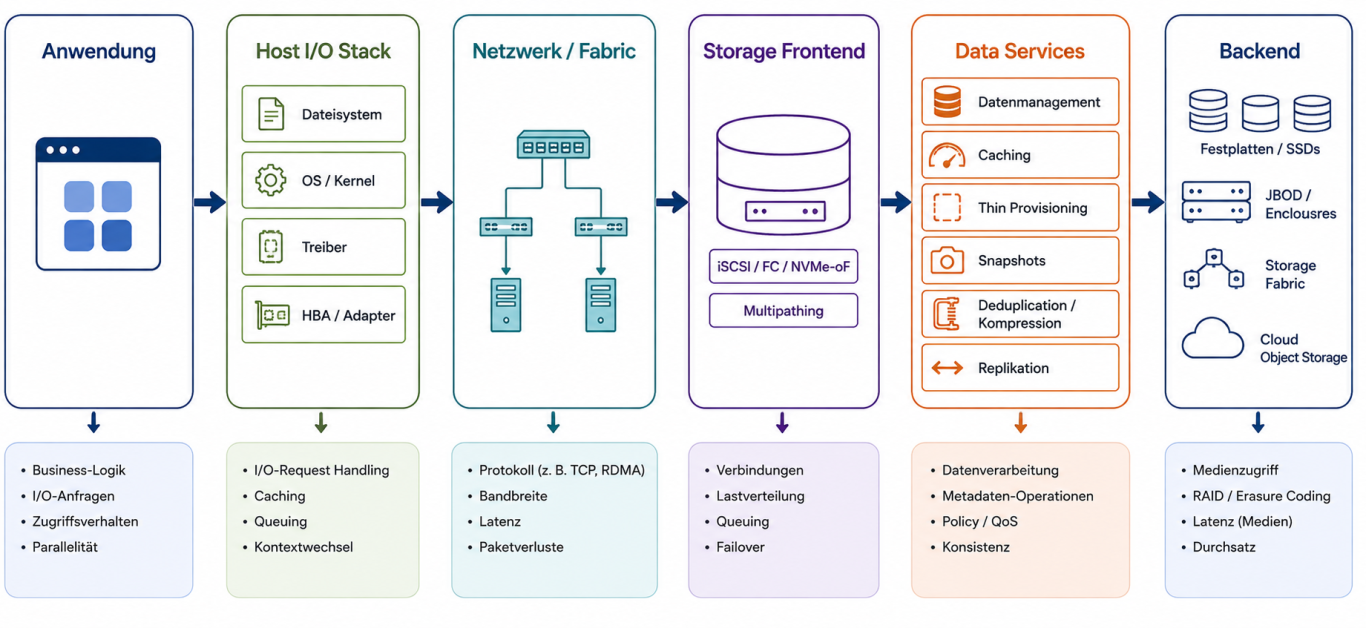
Erst dann lässt sich beurteilen, wo eine relevante Latenz tatsächlich entsteht.
Die vier Architekturansätze im Vergleich
Die Tabelle ist bewusst kein Ranking. Jeder Ansatz löst bestimmte Anforderungen auf unterschiedliche Weise. Welche dieser Unterschiede im konkreten Fall relevant werden, hängt vom Workload und von der erwarteten Entwicklung der Umgebung ab.
Grundprinzip
Eine Dual-Controller-Plattform integriert alle Storage-Funktionen in einem vom Hersteller definierten System. Ein Scale-out Array erweitert dieses Modell um herstellerdefinierte Nodes innerhalb einer getesteten Ausbaumatrix. Software-defined Storage löst die Storage-Software von der Hardware und betreibt sie auf weitgehend frei wählbaren Nodes. Disaggregierte Architekturen trennen Compute und Storage über eine Fabric.
Datenpfad
Bei Scale-up wird I/O controllerzentriert verarbeitet. Scale-out verteilt die Verarbeitung über mehrere Nodes. Bei Software-defined Storage übernimmt eine Cluster-Software den Datenpfad. In disaggregierten Umgebungen führt der Weg über die Fabric zu den Storage-Ressourcen.
Skalierung
Eine Scale-up-Plattform wächst innerhalb definierter Systemgrenzen. Ein Scale-out Array wächst bis zur unterstützten Clustergröße. Ein SDS-Cluster wächst mit der Hardware, die der Betreiber auslegt. Disaggregierte Architekturen erlauben es, Compute und Storage unabhängiger voneinander zu erweitern.
Hardware und Lifecycle
Bei Scale-up und Scale-out liefert der Hersteller Hardware, Firmware und Storage-Software als gemeinsamen Lifecycle. Bei Software-defined Storage laufen Hardware- und Software-Lifecycle getrennt, und die Auslegung liegt beim Betreiber. In disaggregierten Umgebungen hängt das Bild von den eingesetzten Fabric- und Storage-Komponenten ab.
Failure Domains
Bei einer klassischen Plattform sind es Medien, Shelves und Controller. Ein Scale-out Array bringt Nodes und Cluster-Komponenten hinzu. Bei Software-defined Storage werden Nodes und Netzwerk zu wesentlichen Faktoren. In disaggregierten Umgebungen kommen Fabric, Targets und Backend hinzu.
Recovery und Metadaten
Eine integrierte Plattform stellt den Protection-Zustand innerhalb des Systems wieder her und verwaltet Metadaten selbst. Bei Scale-out ist beides implementationsabhängig verteilt. Bei Software-defined Storage ist das Netzwerk Teil des Recovery-Pfads, und Metadaten sind wesentlicher Bestandteil des Clusterdesigns. In disaggregierten Umgebungen hängt das Recovery von der Protection-Architektur ab, und Metadaten sind häufig stärker vom Datenpfad getrennt.
Wachstum kann die Entscheidung verändern
Eine Architekturentscheidung gilt nicht für den Tag der Inbetriebnahme, sondern für die Ausbaustufen, die über die Laufzeit des Systems tatsächlich erreicht werden.
Dabei ist die Kapazitätsgrenze selten der Punkt, an dem eine Plattform zuerst an ihre Grenzen kommt. Vorher verschiebt sich in der Regel ein Verhältnis: Cache zu Nutzkapazität, Controller-Ressourcen zu I/O-Last, Frontend-Bandbreite zur Anzahl der angebundenen Hosts. Ein System kann seine maximale Kapazität also noch längst nicht erreicht haben, während der für den konkreten Workload begrenzende Faktor bereits erreicht ist.
Ein zweiter Effekt kommt über die Medien selbst. Mit wachsender Laufwerkskapazität steigt die Datenmenge, die nach einem Ausfall rekonstruiert werden muss, während die dafür verfügbare Bandbreite nicht im gleichen Maß mitwächst. Das verlängert das Zeitfenster, in dem das System mit reduziertem Schutzniveau arbeitet. Wächst eine Umgebung über mehrere Generationen von Medien hinweg, verändert sich damit auch das Risikoprofil einer zuvor als ausreichend bewerteten Protection-Konfiguration.
Das führt zu einer anderen Betrachtung der Storage-Planung
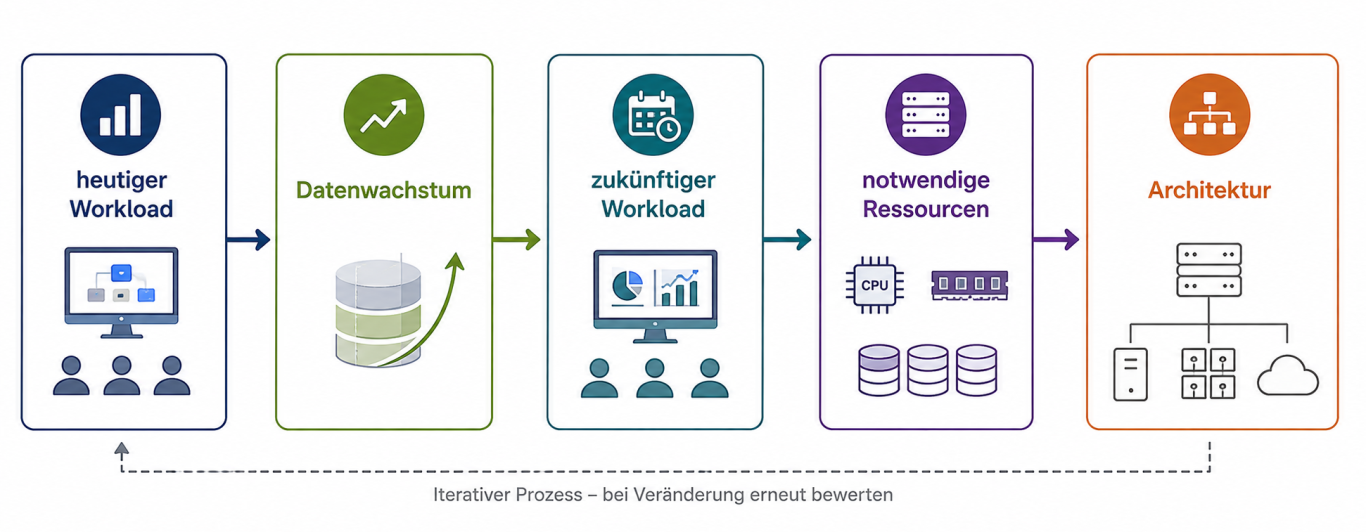
Bei moderatem und gut planbarem Wachstum kann eine integrierte Scale-up-Plattform die Anforderungen über die gesamte Laufzeit erfüllen. Wenn Kapazität und Verarbeitungsanforderungen dagegen gemeinsam stark wachsen, verschiebt sich die Bewertung in Richtung eines Modells, bei dem beide Ressourcen zusammen erweitert werden können.
Architektur ist die Grundlage der Produktauswahl
Die Unterschiede zwischen den Ansätzen zeigen, warum sich Enterprise Storage nicht sinnvoll über eine einzelne Kennzahl auswählen lässt. Bei einem System ist der geschützte Write-Pfad entscheidend. Bei einem anderen steht die horizontale Skalierung im Mittelpunkt. Für eine verteilte Plattform werden Failure Domains und Recovery-Verhalten wichtiger, bei latenzkritischen Anwendungen der I/O-Pfad.
Genau hier setzen wir mit unserem Serviceansatz an: ASSESS, DESIGN, DELIVER, OPERATE.
Im Assessment betrachten wir bestehende Infrastruktur, Workloads, Performance-Anforderungen und Wachstum. Daraus leiten wir im Design die passende Architektur ab. Erst anschließend dimensionieren und vergleichen wir konkrete Systeme. Der Architekturansatz wird damit nicht von einem Hersteller oder einem aktuellen Technologietrend vorgegeben, sondern von den Anforderungen der Umgebung.
Die Produktauswahl ist das Ergebnis der Architekturentscheidung, nicht ihr Ausgangspunkt.
Fazit
Die Unterschiede zwischen den Ansätzen zeigen, warum sich Enterprise Storage nicht sinnvoll über eine einzelne Kennzahl auswählen lässt. Bei einem System ist der geschützte Write-Pfad entscheidend. Bei einem anderen steht die horizontale Skalierung im Mittelpunkt. Für eine verteilte Plattform werden Failure Domains und Recovery-Verhalten wichtiger, bei latenzkritischen Anwendungen der I/O-Pfad.
Genau hier setzen wir mit unserem Serviceansatz an: ASSESS, DESIGN, DELIVER, OPERATE.
Im Assessment betrachten wir bestehende Infrastruktur, Workloads, Performance-Anforderungen und Wachstum. Daraus leiten wir im Design die passende Architektur ab. Erst anschließend dimensionieren und vergleichen wir konkrete Systeme. Der Architekturansatz wird damit nicht von einem Hersteller oder einem aktuellen Technologietrend vorgegeben, sondern von den Anforderungen der Umgebung.
Die Produktauswahl ist das Ergebnis der Architekturentscheidung, nicht ihr Ausgangspunkt.
Quellen
Storage Networking Industry Association (SNIA): The Scale-Out File System Architecture Overview, Webcast, 28. Februar 2019.
NVM Express: NVM Express Base Specification, aktuelle Spezifikationsfamilie.
NVM Express: NVMe over Fabrics und aktuelle Transport-Spezifikationen für PCIe, RDMA und TCP.
NetApp: ONTAP High-Availability Pairs, technische Dokumentation zu NVRAM und HA-Verhalten.
Rashmi et al.: A Solution to the Network Challenges of Data Recovery in Erasure-coded Distributed Storage Systems, USENIX HotStorage, 2013.
Lin et al.: Boosting Full-Node Repair in Erasure-Coded Storage, USENIX ATC, 2021.
Welche Entscheidung steht bei Ihnen an?
Sie möchten eine bestehende Infrastruktur bewerten, eine neue Architektur planen oder eine konkrete technische Fragestellung klären? Sprechen Sie mit uns über Ihre Anforderungen.
Spezialist für moderne Dateninfrastruktur
