
WISSEN > GLOBAL FILESYSTEM > GLOBAL FILE SYSTEM ARCHITEKTUREN
Globale Filesysteme - eine Architekturübersicht.
Autor: Dirk Neumann Geschäftsführer ASSISTRA Cloud Services GmbH 17.08.2026
Globale Daten. Lokale Performance.
Das sollten Sie mitnehmen:
- Der Datenpfad entscheidet, nicht der Produktname
Wo File-Protokoll, Metadaten, Cache und Nutzdaten verarbeitet werden, unterscheidet die Architekturen.
- Bandbreite löst das Latenzproblem nicht
Aus Sicht eines entfernten Standorts bleibt jeder zentrale File Service remote — auch in der Cloud.
- Lokaler File Service ≠ lokale Daten
Replikation hält überall den vollständigen Bestand vor; Edge-Architekturen speichern nur, was gebraucht wird.
- Zusammenarbeit ist eine eigene Entscheidung
Keine Architektur sperrt Dateien standortübergreifend von selbst: Bei DFS-R gewinnt der letzte Schreibvorgang, Sync-Modelle erzeugen Konfliktkopien, Global File Systems locken gezielt pro Ordner.
- Souveränität endet nicht beim Speicherort
Plattform, Identitäten, Management und Rechtsrahmen gehören dazu; Datenresidenz ist nur ein Teilaspekt.

Inhaltsverzeichnis
- Die Ansätze im Überblick
- Zentraler File Service: einfach, aber distanzempfindlich
- Verteilte File Server: die Daten kommen zum Standort
- Cloud File Services: der zentrale Dienst zieht um
- Cloud plus lokaler Cache: Annäherung an das Edge-Modell
- Global File System: zentraler Bestand, lokale File Services
- Aus einem Projekt: weltweite Fileserver ablösen
- Fünf Fragen für die Einordnung
- Was bleibt
Unternehmen mit mehreren Standorten stehen bei File Services vor einem Zielkonflikt, der sich nicht wegdiskutieren lässt: Die Daten sollen zentral verwaltet werden, weil alles andere im Betrieb teuer wird. Die Anwender erwarten trotzdem an jedem Standort einen Zugriff, der sich anfühlt wie ein Laufwerk im Nebenraum.
Es gibt mehrere Wege, diesen Konflikt aufzulösen. Sie unterscheiden sich vor allem in drei Punkten: wo die Daten liegen, wo der File Service bereitgestellt wird und wie die Architektur mit geografischer Distanz umgeht.
Die Ansätze im Überblick
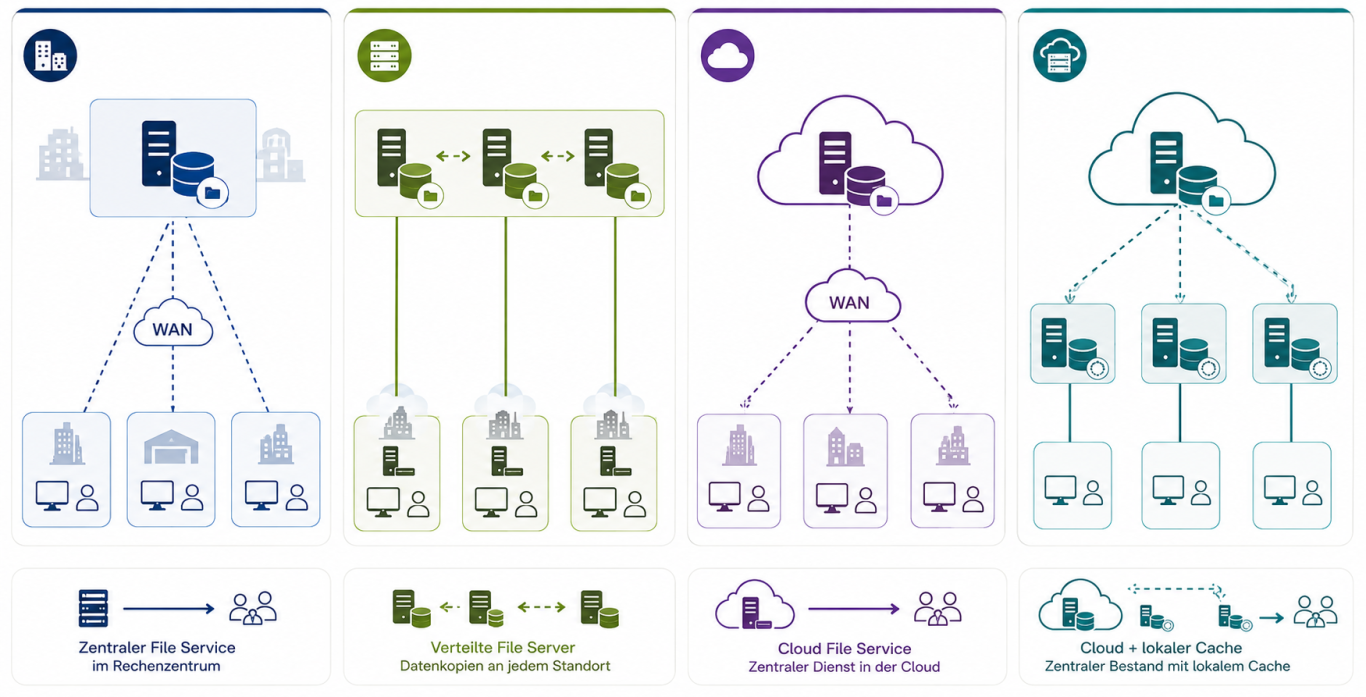
Wo liegen die Daten?
Beim zentralen File Server oder NAS vollständig im eigenen Rechenzentrum. Bei verteilten File Servern existiert an jedem Standort eine vollständige Kopie des Bestands. Cloud File Services legen die Daten beim Provider ab. Ein Cloud File Service mit Sync-Ebene hält den maßgeblichen Bestand zentral und ergänzt ihn um lokale Kopien. Bei Global File Systems liegt der Bestand zentral, während lokale Caches nur den benötigten Ausschnitt vorhalten.
Wo läuft der Fileservice?
Beim zentralen Modell im Rechenzentrum; alle anderen Standorte greifen über das WAN darauf zu. Verteilte File Server stellen den Dienst lokal bereit, auf eigener Hardware je Standort. Cloud File Services verlagern ihn zum Provider, erreichbar über WAN und Internet. Sync-Modelle nutzen lokale Windows Server als Zugriffspunkt. Global File Systems stellen mit dem Edge Filer einen vollwertigen lokalen File Service bereit.
Wie geht die Architektur mit Distanz um?
Zentrale Dienste tragen die WAN-Strecke im normalen Zugriffspfad; WAN-Optimierung mildert das ab, ist aber eine separate Komponente. Replikation nimmt die Strecke aus dem Zugriffspfad und verlagert sie in den Abgleich. Cloud File Services verhalten sich wie zentrale Dienste an einer anderen Adresse. Sync-Modelle reduzieren Remote-Zugriffe über lokal vorgehaltene Daten. Global File Systems bringen Caching und WAN-Optimierung selbst mit.
Was passiert bei gleich-zeitigem Zugriff
Nur beim zentralen File Service stehen die SMB-Mechanismen unmittelbar am maßgeblichen Datenbestand zur Verfügung. Bei DFS-Replikation gibt es kein verteiltes Locking; bei Kollisionen gewinnt der zuletzt geschriebene Stand. Cloud File Services stellen das Protokoll weiterhin zentral bereit. Sync-Modelle sperren nicht standortübergreifend und legen Konfliktkopien an. Global File Systems lösen Konflikte auf und locken gezielt pro Ordner.
Wo liegt der Aufwand?
Zentrale Dienste bleiben vom WAN abhängig und brauchen über Distanz zusätzliche Komponenten. Replikation verlagert den Aufwand in den Betrieb verteilter Kopien und die Konfliktbehandlung. Cloud File Services verbinden WAN-Abhängigkeit mit der Frage nach digitaler Souveränität. Sync-Modelle fügen eine Ebene hinzu, ohne die Cloud-Abhängigkeit aufzuheben. Global File Systems sind architektonisch am komplexesten und erfordern mehr Betriebswissen.
Was die Kategorie nicht verrät
Zwei Produkte derselben Kategorie können sich im Betrieb deutlich unterschiedlich verhalten, und zwei Produkte aus verschiedenen Kategorien lösen manchmal dasselbe Problem. Entscheidend ist deshalb nicht die Einordnung, sondern der Datenpfad: Was passiert zwischen dem Doppelklick am Arbeitsplatz und dem Schreiben auf dem Storage, und wo werden File-Protokoll, Metadaten, Cache und Nutzdaten verarbeitet?
Produktnamen helfen bei der Einordnung wenig. Entscheidend ist der Datenpfad, also die schlichte Frage: Was passiert eigentlich zwischen dem Doppelklick am Arbeitsplatz und dem Lesen oder Schreiben der Daten auf dem Storage?
Zentraler File Service: einfach, aber distanzempfindlich
Die klassische Variante ist schnell beschrieben. Fileserver oder NAS stehen im Rechenzentrum, alle anderen Standorte greifen über das WAN darauf zu.
Das hat einen unterschätzten Vorteil: Der File Service bleibt an einer Stelle. Bei SMB stehen damit auch die Mechanismen, mit denen konkurrierende Zugriffe koordiniert werden – Locks, Oplocks, Leases –, direkt am maßgeblichen Datenbestand zur Verfügung. Niemand muss etwas nachbauen.
Zum Problem wird die Entfernung. Und zwar nicht in erster Linie die Bandbreite: Eine dickere Leitung verkürzt keine Wege. Anwendungen, die viele voneinander abhängige Dateioperationen ausführen, warten bei jedem Schritt auf die Antwort der Gegenstelle. Was im LAN unter der Wahrnehmungsschwelle bleibt, summiert sich über eine WAN-Strecke zu spürbaren Wartezeiten.
Die klassische Gegenmaßnahme heißt WAN-Optimierung. Solche Systeme arbeiten mit Caching, Datenreduktion und Protokolloptimierung und können die Auswirkungen einer langen Strecke deutlich abmildern. Sie sind allerdings eine zusätzliche Komponente, die beschafft, betrieben und im Fehlerfall auch verstanden werden will.
Solange Netzwerkbedingungen und Anwendungen zur Architektur passen, bleibt der zentrale Ansatz attraktiv. Mit jeder weiteren Zeitzone steigt jedoch der Aufwand, akzeptable Zugriffszeiten sicherzustellen.
Verteilte File Server: die Daten kommen zum Standort
Der zweite Ansatz dreht das Prinzip um. Nicht der Zugriff wandert zu den Daten, sondern Kopien der Daten wandern zu den Standorten.
Microsoft DFS ist das bekannteste Beispiel. DFS Namespaces legt einen logischen Namespace über mehrere File Server, DFS Replication gleicht die Bestände zwischen ihnen ab. Für den Anwender ist das Ergebnis angenehm: lokaler File Service, lokale Daten, keine WAN-Latenz im normalen I/O-Pfad.
Der Preis dafür steht auf einem anderen Blatt. Die Organisation betreibt nun mehrere Datenkopien, die konsistent bleiben müssen — und Microsoft macht aus den Grenzen dieses Modells kein Geheimnis. Ein verteiltes Locking über die Server hinweg gibt es nicht; es existiert eigene Dokumentation, die das ausdrücklich als fehlendes Merkmal beschreibt. Bei kollidierenden Änderungen entscheidet der zuletzt geschriebene Stand, die unterlegene Fassung landet in einem versteckten Ordner für Konflikte und Löschungen. Die Empfehlung dazu ist in der offiziellen FAQ eindeutig: DFS Replication soll nicht dort eingesetzt werden, wo mehrere Anwender gleichzeitig dieselben Dateien auf verschiedenen Servern bearbeiten. Der Best Practices Analyzer formuliert es noch direkter — für Zusammenarbeit in Echtzeit ist der Dienst nicht gedacht.
Das deckt sich mit dem, was uns Kunden gerade aus größeren DFS-R-Umgebungen berichtet haben: erheblicher Aufwand rund um die Replikation, wiederholt Situationen, in denen der Replikationszustand geprüft und manuell eingegriffen werden musste. Das ist keine allgemeingültige Aussage über jede Installation. Es beschreibt aber präzise den Trade-off dieses Modells: Lokale Daten senken die WAN-Abhängigkeit, dafür wird die Replikation zur Daueraufgabe — und die Koordination gleichzeitiger Zugriffe bleibt organisatorisch zu lösen, nicht technisch.
Cloud File Services: der zentrale Dienst zieht um
Mit Cloud File Services verlagert man den zentralen File Service aus dem eigenen Rechenzentrum zu einem Provider. Microsoft Azure Files etwa stellt verwaltete SMB- und NFS-Freigaben bereit, ohne dass jemand Server pflegen muss.
Architektonisch ändert sich dadurch weniger, als der Wechsel des Betriebsmodells vermuten lässt. Sitzt der Anwender an einem entfernten Standort, liegt weiterhin ein Netzwerk zwischen ihm und dem File Service. Aus Sicht der Latenz ist ein Cloud-Dienst schlicht ein zentraler Dienst an einer anderen Adresse.
Hinzu kommt eine strategische Frage, die in europäischen Organisationen inzwischen fast immer gestellt wird. Microsoft hat mit der EU Data Boundary weitreichende Zusagen zur Speicherung und Verarbeitung bestimmter Kundendaten innerhalb der EU und EFTA gemacht und dokumentiert zugleich begrenzte Ausnahmen, in denen Daten diese Grenze verlassen können.
Für eine Architekturentscheidung reicht deshalb die Frage nach dem Rechenzentrum nicht aus. Genauso wichtig ist, wer Plattform, Identitäten, Management, Servicebetrieb und den rechtlichen Rahmen kontrolliert. Datenresidenz ist ein Teilaspekt digitaler Souveränität, nicht ihr Synonym.
Cloud plus lokaler Cache: Annäherung an das Edge-Modell
Cloud-Dienste lassen sich mit lokalen Komponenten kombinieren. Azure File Sync verfolgt dieses Prinzip: Eine SMB-Dateifreigabe in Azure Files hält den zentralen Datenbestand, registrierte Windows Server an den Standorten dienen als lokaler Cache. Mit dem optionalen Cloud Tiering bleiben nur die häufig genutzten Dateien lokal liegen; der Namespace bleibt vollständig sichtbar und durchsuchbar, und beim Öffnen einer ausgelagerten Datei wird der Inhalt transparent nachgeladen.
Damit nähert sich die Architektur funktional einem Edge-Modell an – zentrale Datenhaltung, lokaler File Service, lokale Daten nach Bedarf. Anders als bei vollständiger Replikation muss nicht jeder Standort den kompletten Bestand speichern.
Für die standortübergreifende Zusammenarbeit ist allerdings eine Eigenschaft wichtig, die in Produktvergleichen regelmäßig untergeht: Ein Locking über Standorte hinweg gibt es hier nicht. Microsoft dokumentiert stattdessen eine bewusst einfache Konfliktauflösung. Ändern zwei Anwender dieselbe Datei auf verschiedenen Servern, bleiben beide Fassungen erhalten, und die zuletzt geschriebene Änderung behält den ursprünglichen Namen. Hinzu kommt, dass Änderungen, die direkt an der Azure-Dateifreigabe vorgenommen werden, unter Umständen bis zu 24 Stunden brauchen, bis der Dienst sie überhaupt bemerkt. Für Ablagen mit klarer Standortzuordnung ist beides unproblematisch. Für Teams, die parallel an denselben Dateien arbeiten, ist es ein Architekturmerkmal, das man vorher kennen sollte.
Die lokale Ebene löst allerdings nicht die Abhängigkeit von der übergeordneten Plattform. Wer Anforderungen an digitale Souveränität hat, muss die gesamte Service- und Control-Plane betrachten, nicht nur den physischen Speicherort der Dateien.
Global File System: zentraler Bestand, lokale File Services
Global-File-System-Architekturen gehen den Schritt zu Ende. Sie verbinden einen gemeinsamen Namespace und einen zentralen Datenbestand mit Edge Services an den Standorten.
Der Anwender greift per SMB auf einen lokalen Edge Filer zu. Was er aktuell braucht, liegt im lokalen Cache; alles andere wird bei Bedarf nachgeladen. Daraus folgt die eigentlich interessante Trennung: Der File Service ist lokal, ohne dass die Daten vollständig lokal gespeichert sein müssen.
Bei CTERA kommt ein Aspekt hinzu, der in der Diskussion oft untergeht. Die Plattform dokumentiert neben Intelligent Caching eine integrierte WAN Optimization, unter anderem Source-based Deduplication auf den Edge-Systemen. Der Unterschied zum klassischen Fileserver mit vorgeschaltetem WAN-Optimizer ist damit kein gradueller: Edge File Service, Cache und WAN-Optimierung sind Teil derselben Architektur statt drei Produkte von drei Herstellern.
Bleibt die Frage nach der Zusammenarbeit, die beim Azure-Modell offen benannt wurde und hier genauso beantwortet gehört. Der Standardmechanismus ist auch bei CTERA nicht global-strikt. Innerhalb eines Standorts gilt strikte Konsistenz, standortübergreifend arbeitet die Plattform mit eventual consistency und löst kollidierende Änderungen über Konfliktdateien auf. Für Fälle, in denen das nicht tragfähig ist – CTERA nennt selbst CAD-Dateien und Tabellenkalkulationen aus Engineering, Media und Finance –, lässt sich Global File Locking einschalten. Konfiguriert wird es pro Cloud Folder und wirkt dann über alle angebundenen Edge Filer hinweg: Öffnet ein Anwender eine Datei, verweigert die Plattform allen anderen den schreibenden Zugriff, bis das Lock wieder frei ist. Zwei Einschränkungen sollte man dabei kennen. Die Funktion greift für eine definierte Liste von Dateitypen, nicht für beliebige Inhalte, und sie setzt eine entsprechende Lizenzierung des Portals voraus.
Das ist ein bewusster Entwurf und kein Versäumnis. Striktes Locking über alle Standorte hinweg kostet Antwortzeit, und die wenigsten Ablagen brauchen es. Für eine Architekturbewertung folgt daraus trotzdem eine präzisere Frage: nicht, ob eine Plattform Global File Locking beherrscht, sondern für welche Ordner und Dateitypen es im eigenen Fall tatsächlich aktiv wäre.
Ebenso wichtig ist der Datenpfad. Ist der direkte Modus für den Storage Node im Portal aktiviert, laufen die Nutzdaten zwischen Edge Filer und angebundenem Object Storage, ohne den zentralen Portal-Server zu passieren. Das Portal übernimmt dann Management- und Metadatenfunktionen und autorisiert den Bucket-Zugriff, statt den Edge-Systemen dauerhafte Zugangsdaten für den Storage zu hinterlegen. Beim Einsatz von Cloud Object Storage ist das relevanter, als es zunächst klingt – der Standort der Management-Plattform sagt eben nichts darüber aus, welchen Weg große Dateiübertragungen tatsächlich nehmen.
Aus einem Projekt: weltweite Fileserver ablösen
Bei einem Kunden haben wir eine weltweit verteilte Windows-Fileserver-Landschaft durch eine Global-File-System-Architektur ersetzt. Ausschlaggebend waren Kosten und Managementaufwand der bestehenden Struktur, nicht die Performance.
Im Betrieb zeigte sich dann etwas, das die ursprüngliche Annahme relativierte. Bei den dort genutzten Workloads – Office-Dokumente ebenso wie CAD-Dateien – musste der vollständige Datenbestand an keinem Standort lokal vorliegen. Verzeichnis- und Dateiinformationen waren durchgängig verfügbar, Inhalte wurden beim Zugriff geladen und anschließend lokal vorgehalten. Auch größere Dateien ließen sich in den eingesetzten Anwendungen auf diesem Weg sinnvoll nutzen.
Die richtige Frage lautet also selten „zentral oder dezentral?“. Sie lautet: Welche Informationen und welche Daten muss ein bestimmter Workload wirklich lokal vorfinden?
Fünf Fragen für die Einordnung
Für eine erste Bewertung genügen meist fünf Fragen, und sie lassen sich in jedem Herstellergespräch stellen.
Wo liegt der maßgebliche Datenbestand – zentral, in der Cloud oder verteilt in mehreren Kopien? Daraus ergibt sich das Betriebsmodell. Wo endet das File-Protokoll? Ein lokaler SMB-Dienst verhält sich grundlegend anders als SMB über eine WAN-Strecke. Wie gelangen benötigte Daten an den Standort – per Remote-Zugriff, per Replikation oder on demand? Wie werden standortübergreifende Zugriffe auf dieselbe Datei koordiniert – und für welche Ordner und Dateitypen gilt das jeweils? Und schließlich, die aufschlussreichste Frage: Was passiert ohne WAN? Die Antwort darauf legt offen, welche Abhängigkeiten eine Architektur wirklich hat.
Was bleibt
Mehr Bandbreite löst das Latenzproblem nicht automatisch, und WAN-Optimierung als Nachrüstung bringt in klassischen Architekturen eine weitere Komponente ins Spiel. Vollständige Replikation ermöglicht lokalen Zugriff, verlangt dafür aber den dauerhaften Betrieb verteilter Kopien. Und ein zentraler Cloud File Service bleibt aus Sicht eines entfernten Standorts genau das, was er ist: ein Remote File Service.
Moderne Edge-Architekturen trennen Datenhaltung und Datenzugriff. Ein zentraler Bestand lässt sich mit lokalen File Services, intelligentem Caching und WAN-Optimierung so kombinieren, dass die Anwender lokale Performance sehen, während die Organisation zentral verwaltet.
Wer eine globale File-Architektur bewertet, sollte deshalb weniger auf Kategorien und Produktnamen achten als darauf, wo File-Protokoll, Metadaten, Cache, Nutzdaten und Management tatsächlich verarbeitet werden. Und bei der Frage nach digitaler Souveränität gilt: Der Speicherort der Dateien ist nur der erste von mehreren relevanten Punkten.
Welche Entscheidung steht bei Ihnen an?
Sie möchten eine bestehende Infrastruktur bewerten, eine neue Architektur planen oder eine konkrete technische Fragestellung klären? Sprechen Sie mit uns über Ihre Anforderungen.
Spezialist für moderne Dateninfrastruktur
