
WISSEN > GLOBAL FILESYSTEM -> GLOBAL FILESYSTEM DIMENSIONIEREN
Autor: Dirk Neumann Geschäftsführer ASSISTRA Cloud Services GmbH 17.08.2026
Global File System richtig dimensionieren
Warum Working Set, Dateianzahl und WAN-Pfad über die Edge-Kapazität entscheiden.
Das sollten Sie mitnehmen:
- Zentraler Datenbestand und Edge-Kapazität sind zwei verschiedene Größen.
Entscheidend für einen Standort ist nicht der globale Namespace, sondern der dort tatsächlich genutzte Anteil.
- Das Working Set ersetzt die pauschale Cache-Quote.
Prozentwerte können eine Startannahme liefern, aber keine Analyse der lokalen Datennutzung.
- Vor der Dimensionierung steht das Share-Inventar.
Datenvolumen, Dateianzahl, Dateigrößen, Alter und letzte Zugriffe tragen weiter als die reine Gesamtkapazität.
- Pinning und Metadaten sind eigenständige Kapazitätsgrößen.
Dauerhaft lokale Inhalte und ein lokal gehaltener Namespace belegen Platz neben dem dynamischen Cache.
- Dimensionierung ist ein iterativer Prozess.
Wer das reale Working Set vorab nicht kennt, sollte Messung und spätere Erweiterung von vornherein einplanen.

Global Filesystem dimensionieren
Inhaltsverzeichnis
- Warum die Gesamtdatenmenge nicht genügt
- Am Anfang steht das Share-Inventar
- Das Working Set bestimmt den Cache
- Ein Cache braucht Reserve
- Dateianzahl und Metadaten als eigene Planungsgröße
- Data Pinning oder Metadata Pinning?
- Das WAN gehört zur Dimensionierung
- Benutzerzahl ist nur ein indirekter Parameter
- Was Herstellerangaben zur Cache-Größe leisten
- ASSISTRA-Praxiserfahrung: 150 TB zentral bedeuten nicht 150 TB am Edge
- Share Inventory vor Cache Sizing
- Von Data Pinning zu Metadata Pinning
- Ein belastbarer Dimensionierungsprozess
- Fazit
- Quellen
in Global File System trennt die Größe des zentral verwalteten Datenbestands von der Kapazität, die an einem einzelnen Standort tatsächlich lokal bereitstehen muss. Genau diese Trennung macht die Dimensionierung anspruchsvoller als bei einem klassischen lokalen Fileserver.
Ein Standort mit Zugriff auf 100 TB zentral verwaltete Daten benötigt nicht zwangsläufig 100 TB lokalen Storage. Umgekehrt lässt sich aus der Zahl der Benutzer allein nicht zuverlässig ableiten, wie groß ein Edge Cache sein muss. Entscheidend sind unter anderem das lokale Working Set, die Zahl und Größenverteilung der Dateien, die Änderungsrate, dauerhaft lokal benötigte Daten sowie die verfügbare WAN-Verbindung.
Die Dimensionierung sollte deshalb nicht mit einer Appliance-Größe beginnen, sondern mit einer Bestandsaufnahme der Daten und ihrer tatsächlichen Nutzung.
Dieser Beitrag verwendet den CTERA Edge Filer durchgehend als dokumentierte Referenzimplementierung, weil dessen Caching-, Pinning- und Sizing-Verhalten öffentlich beschrieben ist. CTERA gehört zum Lösungsportfolio von ASSISTRA. Wir legen das offen, weil die technischen Beispiele in diesem Artikel überwiegend aus der Dokumentation eines Herstellers stammen, mit dem wir geschäftlich verbunden sind. Alle produktspezifischen Angaben sind als solche gekennzeichnet und nicht als allgemeine Eigenschaften von Global File Systems zu verstehen
Warum die Gesamtdatenmenge nicht genügt
Bei einem klassischen Fileserver befinden sich Namespace und Dateiinhalte typischerweise auf dem lokalen Storage. Bei einem Edge-basierten Global File System kann dagegen ein wesentlich größerer zentraler Datenbestand sichtbar sein, während nur ein Teil der Dateiinhalte lokal gespeichert wird.
Am Beispiel des CTERA Edge Filer beschreibt die Herstellerdokumentation ein Caching-Modell, bei dem Dateien in der Cloud liegen und nur bei Bedarf lokal gespeichert werden. Nicht lokal vorgehaltene Inhalte werden durch Stubs repräsentiert, die nur wenig Speicherplatz belegen. Lokal vorhandene Dateien bezeichnet CTERA als Hot Files, in der Cloud verbliebene als Cold Files. Länger nicht genutzte Inhalte werden nach einer Eviction Policy wieder entfernt und hinterlassen erneut einen Stub. Gepinnte Dateien bleiben dagegen lokal und werden nicht evicted.
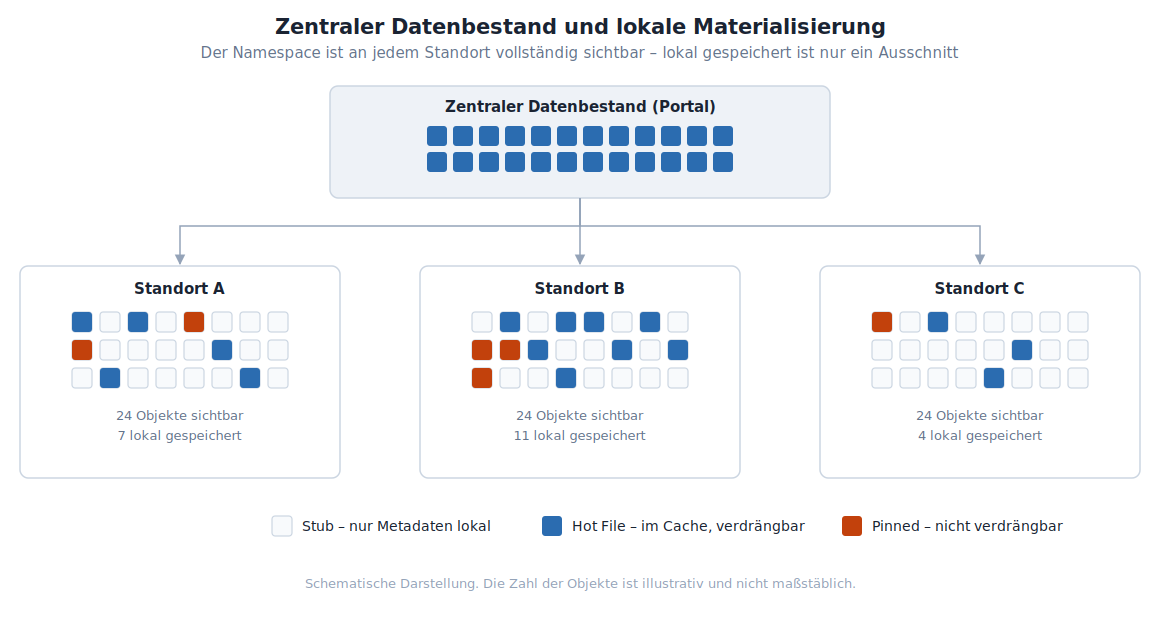
Damit entstehen mindestens drei unterschiedliche Kapazitätsgrößen:
Diese Größen dürfen nicht gleichgesetzt werden.
Ein 150-TB-Namespace bedeutet daher weder, dass jeder Standort 150 TB Cache benötigt, noch dass ein bestimmter Prozentsatz davon grundsätzlich ausreichend wäre.
Das Working Set bestimmt den Cache
Als Working Set kann im Kontext eines Global File Systems der Teil des Datenbestands betrachtet werden, der innerhalb eines relevanten Zeitraums tatsächlich aktiv benötigt wird.
Als Planungsmodell lässt sich die erforderliche lokale Kapazität aus drei Summanden zusammensetzen: dem aktiven Working Set, den dauerhaft lokal vorzuhaltenden Daten und einer betrieblichen Reserve. Das ist keine allgemeingültige Produktformel. Sie macht vielmehr deutlich, welche Größen getrennt betrachtet werden müssen.
Besonders wichtig ist die Unterscheidung zwischen dynamischem Cache und Pinning. Dynamisch gecachte Daten können bei Kapazitätsdruck wieder verdrängt werden. Gepinnte Inhalte müssen dagegen dauerhaft lokal Platz finden. Bei CTERA bleiben Dateien in gepinnten Ordnern auf dem Edge Filer und werden nicht evicted. Steigt der Umfang gepinnter Daten, reduziert sich entsprechend der Kapazitätsspielraum für das dynamische Working Set.
Ein Cache braucht Reserve
Die nutzbare Kapazität sollte nicht mit der nominellen Cache-Kapazität gleichgesetzt werden.
Bei der von CTERA dokumentierten Standardkonfiguration beginnt die Eviction, sobald die Belegung ein High Watermark von 75 Prozent der Gesamtkapazität des Edge Filer erreicht. Anschließend werden Dateien entfernt, bis ein Low Watermark von 65 Prozent unterschritten ist. Die Auswahl erfolgt nach dem Zeitpunkt des letzten Zugriffs in Gruppen, beginnend mit der ältesten; sie richtet sich ausdrücklich nach Tagen und nicht nach Dateigröße. Nicht evicted werden Dateien in gepinnten Ordnern, aktuell geöffnete Dateien und Dateien, die noch nicht zum Portal synchronisiert wurden.
Die verbleibende Differenz ist kein ungenutzter Puffer, sondern eingeplant. CTERA beschreibt die oberhalb des High Watermark liegenden 25 Prozent als Reserve für Schreibspitzen, die auf diese Weise mit LAN-Geschwindigkeit angenommen werden können.
Das hat eine wichtige Konsequenz für die Planung: Ein Cache, dessen nominelle Größe gerade dem erwarteten Working Set entspricht, besitzt keinen ausreichenden Spielraum für Eviction, Schreibspitzen und nicht verdrängbare Daten.
Dateianzahl und Metadaten als eigene Planungsgröße
Terabyte allein sind keine ausreichende Dimensionierungsgröße. 10 TB aus wenigen sehr großen Dateien stellen für Metadaten und Namespace eine andere Situation dar als 10 TB aus Millionen kleiner Dateien. CTERA berücksichtigt deshalb in der eigenen Sizing-Systematik ausdrücklich neben der physischen Datenmenge auch die Anzahl der Shares und Dateien.
Mit Metadata Pinning wird diese Trennung noch deutlicher. In der Dokumentation zur Version 7.13.x (EA) beschreibt CTERA, dass Metadaten einzelner Cloud Folder oder des gesamten Namespace auf dem Edge Filer gepinnt werden können. Als Nutzen nennt der Hersteller schnelleres Navigieren durch Ordnerstrukturen, schnellere Suchen sowie kürzere Ladezeiten für Anwendungen, die vor dem Öffnen von Dateien Verzeichnis-Scans durchführen. Voreingestellt ist, dass Metadaten nicht gepinnt werden.
Metadata Pinning benötigt selbst Speicherplatz und kann zusätzlichen Netzwerkverkehr erzeugen, etwa wenn viele Metadatenänderungen zu den einzelnen Edge Filern synchronisiert werden müssen. Zur Abschätzung des Platzbedarfs nennt CTERA eine durchschnittliche Metadatengröße von 4 KB je Datei, aus der sich der Bedarf als Produkt aus Dateianzahl und diesem Wert ergibt. Es handelt sich um eine Herstellerangabe für diese Implementierung und keine allgemeine Eigenschaft von Global File Systems.
Damit wird die Dateianzahl zu einer eigenständigen Planungsgröße neben dem Datenvolumen.
Die Voraussetzungen unterscheiden sich zwischen den Versionsständen. Die Dokumentation zur Referenzversion 7.11.x (GA) nennt Local Quota und das Next Generation File System als Bedingungen für Metadata Pinning. In der Fassung zu 7.13.x (EA) heißt es, Metadata Pinning werde automatisch umgesetzt, sobald Local Quotas implementiert sind. Wer diese Funktion einplant, sollte den Versionsstand der eingesetzten Umgebung deshalb konkret prüfen
Data Pinning oder Metadata Pinning?
Vollständiges Pinning und Metadata Pinning lösen unterschiedliche Anforderungen.
Beim vollständigen Pinning werden die Dateiinhalte lokal gehalten. CTERA beschreibt dies als Mittel, um Inhalte auch dann verfügbar zu halten, wenn der Edge Filer offline ist oder Cloud-Provider beziehungsweise Portal ausfallen. Der Hersteller weist zugleich darauf hin, dass es sinnvoll sein kann, alle Daten zu pinnen, sofern die lokal benötigte Datenmenge ohne Weiteres in die Appliance passt, weil dies das Verhalten eines regulären Fileservers reproduziert.
Metadata Pinning hält dagegen den Namespace lokal vor, während die eigentlichen Dateiinhalte weiterhin bedarfsgesteuert nachgeladen werden.
Für die Architekturentscheidung muss deshalb zunächst die eigentliche Anforderung geklärt werden. Muss der Dateiinhalt offline verfügbar sein, ist lokaler Datenbestand erforderlich. Geht es dagegen primär darum, Verzeichnisnavigation, Suchen oder Scan-Vorgänge lokal zu unterstützen, kann Metadata Pinning eine andere Architektur ermöglichen, sofern die konkrete Plattform dies unterstützt.
Diese Unterscheidung kann erheblichen Einfluss auf die benötigte Edge-Kapazität haben. Welche Rolle der Edge Filer im Gesamtaufbau übernimmt, beschreiben wir ausführlicher unter Edge File Services.
Das WAN gehört zur Dimensionierung
Ein Edge Cache reduziert WAN-Abhängigkeiten für bereits lokal vorhandene Daten. Er beseitigt die WAN-Verbindung aber nicht aus dem Datenpfad.
Cache Misses müssen Daten aus der zentralen Umgebung nachladen. Neue und geänderte Daten müssen in die zentrale Infrastruktur übertragen werden. Wie gut das funktioniert, hängt nicht allein von der nominellen Bandbreite ab.
RFC 6349 beschreibt eine Methodik zur Messung des tatsächlich erreichbaren TCP-Durchsatzes über einen Ende-zu-Ende-Pfad und benennt dafür als wesentliche Größen die Bottleneck Bandwidth, die Round-Trip Time, die Sende- und Empfangspuffer, das minimale TCP Receive Window und die Path MTU. Das Bandwidth-Delay Product, definiert als Produkt aus Kapazität des Datenpfads und Ende-zu-Ende-Verzögerung, bestimmt dabei die Puffergrößen, die für maximalen Durchsatz erforderlich sind. Das Dokument definiert darüber hinaus drei Kennzahlen zur Bewertung eines Pfads: das Verhältnis von tatsächlicher zu idealer Übertragungszeit, den Anteil nicht erneut übertragener Bytes sowie den Anstieg der RTT gegenüber dem Basiswert während der Übertragung. Als Orientierung nennt RFC 6349 zudem, dass Paketverluste von fünf Prozent oder Jitter von 150 ms eine belastbare Durchsatzmessung bereits verhindern können.
Der WAN-Bedarf eines Global File Systems setzt sich damit aus mehreren Anteilen zusammen: dem Nachladen bei Cache Misses, der Übertragung geänderter Daten, der Hintergrundsynchronisation und der initialen Datenbewegung bei der Migration. Auch dies ist ein konzeptionelles Modell und keine exakte Durchsatzformel.
Besonders kritisch kann die Änderungsrate sein. Werden lokal über längere Zeit mehr neue oder geänderte Daten erzeugt, als über den Datenpfad abgeführt werden können, wächst der noch zu synchronisierende Datenbestand.
CTERA beschreibt für die eigene Implementierung genau diesen Fall: Wird der freie Speicherplatz zu knapp, greift eine Drosselung. Benutzer können weiter schreiben, die Schreibgeschwindigkeit wird jedoch auf WAN-Geschwindigkeit reduziert, damit nicht mehr Daten geschrieben als in die Cloud ausgelagert werden. Als Situationen, in denen dies eintritt, nennt die Dokumentation die Migration großer Datenmengen und sehr starke Write Bursts, bei denen die für Schreibspitzen reservierten 25 Prozent aufgebraucht werden.
Die WAN-Dimensionierung sollte deshalb nicht allein auf einem Speedtest oder der nominellen Leitungskapazität beruhen. Relevant ist der End-to-End-Datenpfad unter dem vorgesehenen Workload.
Benutzerzahl ist nur ein indirekter Parameter
Die Zahl der Benutzer ist relevant, reicht allein aber ebenfalls nicht aus.
100 Benutzer, die überwiegend kleine Office-Dokumente bearbeiten, erzeugen ein anderes I/O- und Transferprofil als 100 Benutzer, die große Medien-, CAD- oder andere datenintensive Dateien verwenden.
Die Benutzerzahl muss deshalb mit weiteren Größen verknüpft werden: mit der Zahl der gleichzeitig aktiven Benutzer, mit dem Workload-Profil und daraus abgeleitet mit Datenmenge und Änderungsrate. Erst diese Kette ergibt ein belastbares Bild; die reine Kopfzahl tut es nicht.
Was Herstellerangaben zur Cache-Größe leisten
Plattformspezifische Vorgaben ersetzen keine Analyse, begrenzen aber den Lösungsraum.
Für die virtuellen Edge Filer der V-Serie koppelt CTERA die maximal nutzbare Kapazität an die Lizenz und nennt dazu jeweils eine empfohlene Höchstzahl an Benutzern:
CPU und RAM leitet CTERA aus der Lizenzklasse ab und nennt als Mindestempfehlung ein Viertel der Lizenznummer als Zahl der vCPUs und die Hälfte als RAM in GB. Für eine EV32-Lizenz ergeben sich daraus 8 vCPUs und 16 GB RAM als Ausgangspunkt, der je nach Nutzung erhöht werden soll.
Interessanter für die Kapazitätsplanung sind zwei Untergrenzen. CTERA nennt für den Edge Filer eine Mindestkapazität von 2 TB oder 20 Prozent der maximal erwarteten Speichernutzung, je nachdem, welcher Wert größer ist. In den Anleitungen zur nachträglichen Erweiterung der Storage-Kapazität empfiehlt der Hersteller darüber hinaus, die Gesamtkapazität auf mindestens 20 Prozent des Global Name Space des Portals auszulegen.
Diese zweite Empfehlung verdient eine genauere Betrachtung, weil sie leicht missverstanden wird. Ihr Bezugspunkt ist der gesamte Namespace des Portals, nicht der einem Standort zugeordnete Share. Bei einem Namespace von 150 TB ergäbe eine wörtliche Anwendung eine Mindestkapazität von 30 TB je Edge Filer, auch für einen Standort, dessen relevanter Datenbestand nur 10 TB umfasst. Die Empfehlung wäre dann größer als die gesamte für diesen Standort relevante Datenmenge.
Wir lesen die Angabe deshalb als konservative Faustregel für Umgebungen, in denen alle Standorte auf denselben Datenbestand zugreifen, und nicht als Rechenvorschrift für Umgebungen mit klar getrennten standortspezifischen Shares. Die eigentliche Aussage bleibt in beiden Fällen dieselbe: Prozentwerte sind Startpunkte, keine Dimensionierung. Wer sie verwendet, sollte den Bezugspunkt kennen und die Annahme später gegen den realen Betrieb prüfen.
Die 2-TB-Untergrenze ist dagegen eine harte Angabe und in der Praxis der eigentlich wirksame Wert. Wer eine Startdimensionierung aus einem Prozentsatz ableitet, sollte prüfen, ob das Ergebnis diese Grenze überhaupt erreicht. Bei kleinen Shares oder niedrig angesetzten Quoten ist das regelmäßig nicht der Fall. Dann gilt der Mindestwert und nicht der Prozentwert.
ASSISTRA-Praxiserfahrung: 150 TB zentral bedeuten nicht 150 TB am Edge
Wie schwierig die Bestimmung des tatsächlichen Working Sets sein kann, zeigt ein von uns begleitetes Global-File-System-Projekt.
Der zentrale Datenbestand betrug rund 150 TB. Drei Standorte verwendeten unterschiedliche Shares mit theoretischen Datenbeständen von ungefähr 10 TB, 15 TB und 23 TB. Die Anwendungen bestanden überwiegend aus klassischen Office-Workloads.
Das entscheidende Problem bei der initialen Dimensionierung war nicht die Kenntnis der zentralen Kapazität. Diese war bekannt. Unbekannt war vielmehr, welcher Anteil der den Standorten zugeordneten Daten tatsächlich regelmäßig lokal verwendet wurde.
Wir setzten deshalb für die initiale Planung einen Cache in der Größenordnung von zehn Prozent der jeweiligen Share-Größe an, gemessen also am standortspezifischen Datenbestand und nicht am globalen Namespace. Diese zehn Prozent sind ausdrücklich keine allgemeine Empfehlung für Global File Systems und decken sich auch nicht mit der oben beschriebenen Herstellerfaustregel. Sie waren eine projektspezifische Startannahme unter den dort vorhandenen Rahmenbedingungen.
Die vom Hersteller dokumentierte Mindestkapazität von 2 TB blieb dabei als Untergrenze bestehen. Wo zehn Prozent der Share-Größe rechnerisch darunter geblieben wären, wurde nicht der Prozentwert, sondern der Mindestwert angesetzt. Der Prozentsatz diente also der Abschätzung der Größenordnung, nicht der Unterschreitung einer dokumentierten Untergrenze.
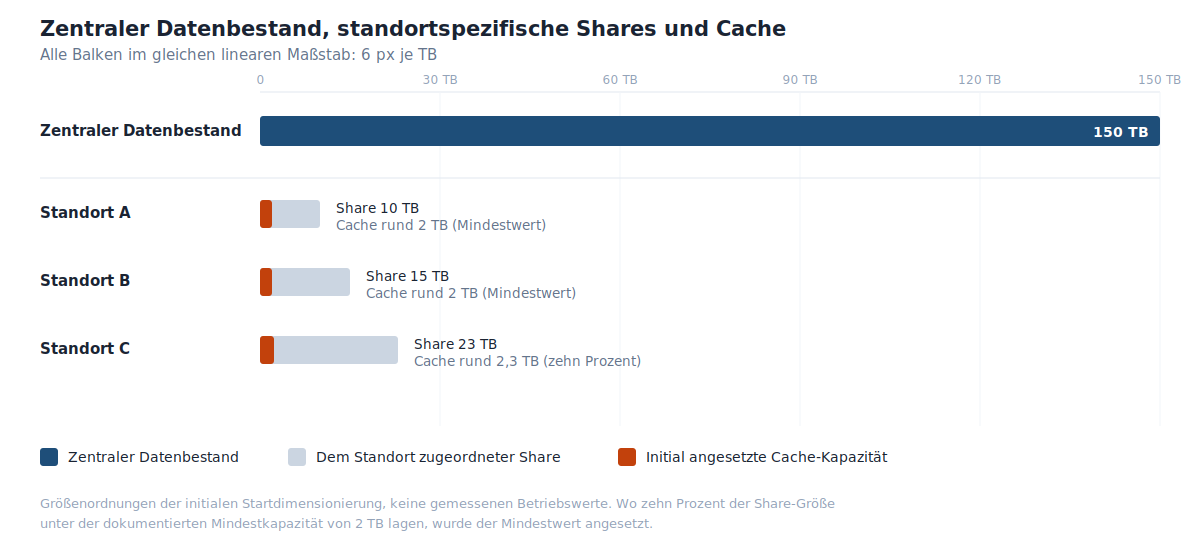
Ein wesentlicher Bestandteil dieser Entscheidung war die technische Möglichkeit zur späteren Anpassung. Die Edge Filer wurden als virtuelle Systeme unter Hyper-V betrieben. Zusätzliche Cache-Kapazität konnte damit bei Bedarf ergänzt werden. CTERA führt Hyper-V unter den unterstützten Plattformen und beschreibt für diese Umgebung sowohl die Erweiterung einer dynamisch wachsenden virtuellen Festplatte als auch das Hinzufügen weiterer Disks, wenn die vorhandene mit fester Größe angelegt wurde. Der Spielraum endet dabei jeweils an der Kapazitätsgrenze der eingesetzten Lizenz.
Damit wurde die Unsicherheit über das tatsächliche Working Set nicht durch eine vermeintlich exakte Vorhersage gelöst. Stattdessen wurde die Infrastruktur so geplant, dass eine initiale Annahme anhand des später beobachteten Betriebs korrigiert werden konnte.
Von Data Pinning zu Metadata Pinning
In einzelnen von uns begleiteten Projekten wurde Pinning eingesetzt, wenn bestimmte Daten lokal vorgehalten werden sollten.
Für Anforderungen, bei denen nicht die vollständigen Dateiinhalte permanent lokal benötigt werden, würden wir heute zusätzlich prüfen, ob Metadata Pinning die eigentliche Anforderung besser erfüllt. Das ist keine bloße Optimierung des Cache Sizing, sondern eine andere Architekturentscheidung. Data Pinning setzt voraus, dass der Dateiinhalt lokal vorhanden ist, und erzeugt entsprechenden lokalen Kapazitätsbedarf. Metadata Pinning hält Namespace und Metadaten lokal vor, während Dateiinhalte weiterhin bedarfsgesteuert geladen werden.
Vor dem Pinning sollte deshalb geklärt werden, ob tatsächlich Datenlokalität oder lediglich lokale Namespace-Verfügbarkeit benötigt wird. Wie unterschiedlich die Plattformen diese Mechanismen umsetzen, zeigt unser Beitrag:
Ein belastbarer Dimensionierungsprozess
Aus den technischen Abhängigkeiten und unseren Projekterfahrungen ergibt sich ein mehrstufiger Ansatz.
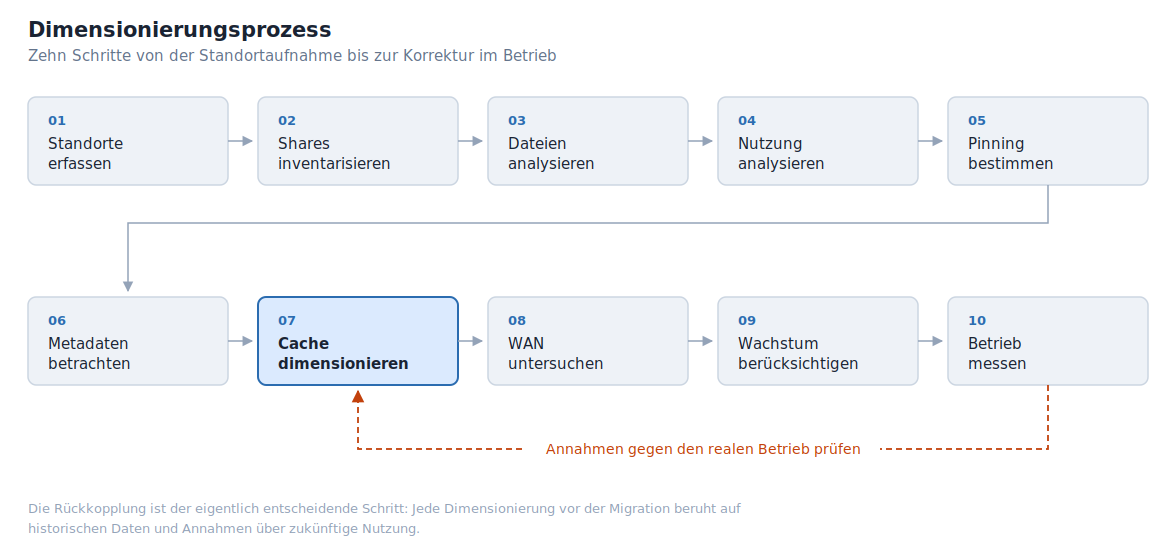
Der letzte Schritt ist entscheidend. Eine Dimensionierung vor der Migration basiert zwangsläufig auf historischen Daten und Annahmen über zukünftige Nutzung. Deshalb sollte nach der Inbetriebnahme überprüft werden, ob Cache-Belegung, Eviction, Pinning und tatsächliche Zugriffe dem Planungsmodell entsprechen.
Typische Fehlansätze
„Wir haben 100 TB Daten, also brauchen wir 100 TB Edge Storage."
Damit würde das zentrale Datenvolumen mit dem lokalen Working Set gleichgesetzt. Das widerspricht gerade dem Grundprinzip einer Caching-Architektur.
„Zehn Prozent Cache reichen."
Dafür gibt es keine allgemeingültige Grundlage. Zehn Prozent können, wie im beschriebenen Projekt, eine begründete und korrigierbare Startannahme sein. Bei einem anderen Workload können sie zu viel oder deutlich zu wenig sein. Dasselbe gilt im Übrigen für die vom Hersteller genannten 20 Prozent, deren Bezugspunkt zudem ein anderer ist. Hinzu kommt, dass jeder Prozentwert an der dokumentierten Mindestkapazität endet: Unterschreitet das Ergebnis diese Grenze, ist der Prozentsatz nicht die Dimensionierung.
„Wir dimensionieren nach Benutzerzahl."
Die Benutzerzahl sagt allein wenig über Working Set, Dateigrößen und Änderungsrate aus.
„Wir pinnen sicherheitshalber alles."
Damit nähert sich die benötigte lokale Kapazität wieder dem vollständigen Datenbestand an. Das kann technisch sinnvoll sein und wird vom Hersteller sogar empfohlen, wenn die lokal benötigten Daten ohne Weiteres in die Appliance passen. Es verändert aber das Kapazitätsmodell grundlegend.
„Die WAN-Leitung hat genügend Mbit/s."
Die nominelle Bandbreite allein beschreibt weder den tatsächlich erreichbaren End-to-End-Durchsatz noch die Auswirkung von RTT, TCP-Verhalten, Cache Misses und Änderungsrate.
Fazit
Die Dimensionierung eines Global File Systems ist keine einfache Kapazitätsrechnung.
Der zentrale Datenbestand definiert die Größenordnung der gesamten Datenplattform. Für den einzelnen Standort sind dagegen vor allem das lokale Working Set, dauerhaft benötigte Daten, Dateianzahl und Metadaten, Workload, Änderungsrate sowie der WAN-Datenpfad entscheidend.
Gerade das Working Set ist vor einer Migration häufig nicht exakt bekannt. Unsere Erfahrung zeigt deshalb einen pragmatischen Weg: Shares zunächst inventarisieren, eine technisch begründete Startdimensionierung festlegen, ausreichend Reserve und Erweiterbarkeit vorsehen und die Annahmen anschließend anhand der realen Nutzung überprüfen.
Das Beispiel mit 150 TB zentralem Datenbestand und deutlich kleineren standortspezifischen Shares zeigt zugleich, warum eine pauschale Cache-Quote nicht zur allgemeinen Regel werden darf. Das gilt für die zehn Prozent aus einem konkreten Projekt ebenso wie für die 20 Prozent aus einer Herstelleranleitung. Die entscheidende Frage lautet nicht, welcher Prozentsatz der Gesamtdaten lokal gespeichert werden soll, sondern welche Daten ein Standort tatsächlich wann benötigt und welche Konsequenzen daraus für Cache, Metadaten und Netzwerk entstehen.
Quellen
- CTERA Networks: Sizing, CTERA Knowledge Base, Produktdokumentation CTERA Edge Filer. Sizing-Parameter, Portal-Mengengrenzen sowie Beschreibung der Legacy Filesystem Discovery und des Discovery Reports. Abruf: 8. September 2026. kb.ctera.com/v1/docs/sizing
- CTERA Networks: Managing Caching, CTERA Knowledge Base, Produktdokumentation CTERA Edge Filer, Administrator Guide. Caching-Modell, Stubs, Hot und Cold Files, Streaming, Eviction mit High und Low Watermark sowie Drosselung bei Kapazitätsengpässen. Die Seite weist keine Versionsangabe aus. Abruf: 8. September 2026. kb.ctera.com/docs/managing-caching-3
- CTERA Networks: Pin Folders so that Files are Always Available Locally, CTERA Knowledge Base, Produktdokumentation CTERA Edge Filer, Administrator Guide. Vollständiges lokales Pinning und Verhalten nicht gepinnter Dateien. Abruf: 8. September 2026. kb.ctera.com/docs/pinning-folders-so-that-files-are-always-available-locally-5-1
- CTERA Networks: Pin Metadata, CTERA Knowledge Base, Produktdokumentation CTERA Edge Filer, Version 7.13.x (EA). Anwendungsfälle des Metadata Pinning, Platzbedarf mit der Angabe von 4 KB je Datei sowie Hinweis auf zusätzlichen Netzwerkverkehr. Abruf: 8. September 2026. kb.ctera.com/docs/pinning-the-metadata-1-1
- CTERA Networks: Pin Metadata, CTERA Knowledge Base, Produktdokumentation CTERA Edge Filer, Version 7.11.x (GA). Voraussetzungen Local Quota und Next Generation File System, Standardverhalten ohne Metadaten-Download. Abruf: 8. September 2026. kb.ctera.com/docs/pinning-the-metadata
- CTERA Networks: V Series, CTERA Knowledge Base, Produktdokumentation CTERA Edge Filer, Version 7.11.x (GA), Technical Specifications. Lizenzklassen mit maximaler Kapazität und empfohlener Benutzerzahl, Mindestkapazität, unterstützte Plattformen sowie CPU- und RAM-Empfehlungen. Abruf: 8. September 2026. kb.ctera.com/docs/v-series-5-1-1
- CTERA Networks: Increasing Available CTERA Edge Filer Storage (Except for H series Edge Filers), CTERA Knowledge Base, Produktdokumentation CTERA Edge Filer, Administrator Guide. Verfahren zur Erweiterung der Storage-Kapazität einschließlich Hyper-V sowie die Empfehlung von mindestens 20 Prozent des Portal Global Name Space. Abruf: 8. September 2026. kb.ctera.com/docs/increasing-available-ctera-edge-filer-storage-except-for-h-series-edge-filers-2-1
- IETF: Constantine, B.; Forget, G.; Geib, R.; Schrage, R.: RFC 6349 – Framework for TCP Throughput Testing, August 2011. Bandwidth-Delay Product, Round-Trip Time, Bottleneck Bandwidth, TCP Receive Window sowie die Kennzahlen Transfer Time Ratio, TCP Efficiency und Buffer Delay. doi.org/10.17487/RFC6349
Welche Entscheidung steht bei Ihnen an?
Sie möchten eine bestehende Infrastruktur bewerten, eine neue Architektur planen oder eine konkrete technische Fragestellung klären? Sprechen Sie mit uns über Ihre Anforderungen.
Spezialist für moderne Dateninfrastruktur
