
WISSEN > ENTERPRISE STORAGE > HYBRID CLOUD PLANEN
Wie lokale Storage-Systeme, Cloud Storage, Caching, WAN und Recovery zusammenspielen
Autor: Dirk Neumann Geschäftsführer ASSISTRA Cloud Services GmbH 17.08.2026
Hybrid Cloud Storage: Datenpfade, Performance und Recovery richtig planen
Das sollten Sie mitnehmen:
- Datenpfad statt Speicherort
Entscheidend ist nicht, wo Daten liegen, sondern ob der normale I/O einer Anwendung das WAN durchlaufen muss.
- Working Set ≠ sichtbarer Datenbestand
Die nötige Cache-Kapazität richtet sich nach den regelmäßig genutzten Daten, nicht nach dem gesamten Namensraum.
- Write-back verändert das Failure Model
Bestätigte Schreibvorgänge liegen zeitweise nur lokal vor und brauchen Journal, Retry und Recovery.
- Replikation ≠ Backup
Repliziert wird auch das Unerwünschte; Schutz entsteht erst durch Versionierung, Unveränderbarkeit und getrennte Administration.
- RPO ≠ RTO
Eine kontinuierliche Replikation sagt nichts darüber aus, wie lange der Rücktransport großer Datenmengen dauert.

Inhaltsverzeichnis
- Was Hybrid Cloud Storage bedeutet
- Drei Modelle, die nicht dasselbe leisten
- Der Datenpfad entscheidet über die Performance
- Warum Caching eine zentrale Rolle spielt
- Reads sind einfacher als Writes
- File, Block und Object sind keine austauschbaren Ebenen
- Konsistenz wird zum Distributed-Systems-Problem
- Das WAN ist Bestandteil des Storage-Systems
- Replikation ist nicht gleich Backup
- RPO und RTO müssen getrennt geplant werden
- Kapazität ist nicht Performance
- Failure Domains bewusst trennen
- Kosten entstehen nicht nur durch gespeicherte Terabyte
- Die zentrale Frage: Wo liegt der aktive Datenpfad?
- Fazit
- Quellen
Storage-Infrastrukturen müssen heute zwei Anforderungen gleichzeitig bedienen. Anwendungen erwarten vorhersehbare Performance. Gleichzeitig sollen Kapazitäten flexibel wachsen, Daten geografisch geschützt und Cloud-Dienste eingebunden werden.
Hybrid Cloud Storage löst das nicht mit einem einzigen System. Die Architektur verbindet unterschiedliche Storage-Domänen und legt fest, welche Daten wo liegen, über welchen Pfad sie erreichbar sind und wie sie sich zwischen den Domänen bewegen.
Darin liegt der entscheidende Punkt. Eine Verbindung zwischen lokalem Storage und Cloud Storage ergibt noch keine funktionierende Hybridarchitektur. Es kommt auf Datenplatzierung, Datenbewegung, Konsistenz, Latenz, Failure Handling und Recovery an.
Was Hybrid Cloud Storage bedeutet
NIST definiert eine Hybrid Cloud als Verbindung von mindestens zwei eigenständigen Cloud-Infrastrukturen, etwa Private und Public Cloud, die technisch so gekoppelt sind, dass Daten oder Anwendungen zwischen ihnen portierbar bleiben.
In der Praxis wird der Begriff Hybrid Cloud Storage breiter verwendet. Gemeint sind meist Architekturen, in denen lokale Infrastruktur mit extern bereitgestellten Storage-Ressourcen zusammenarbeitet. Vereinfacht sieht der Aufbau so aus:
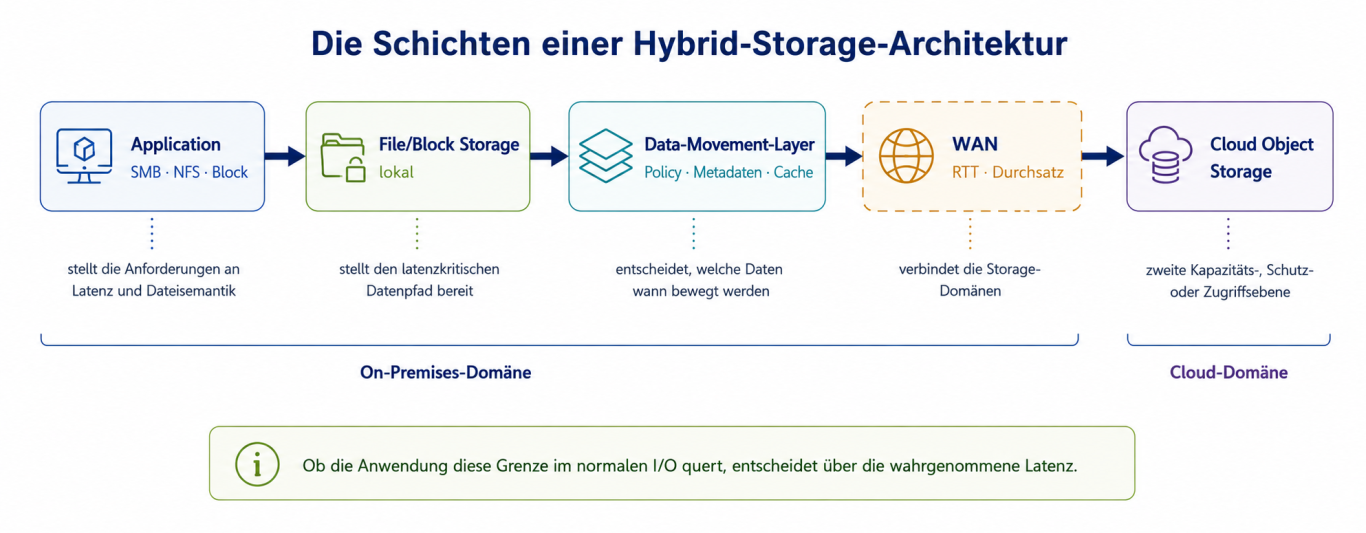
Jede Schicht erfüllt eine eigene Aufgabe. Die Domänengrenze verläuft im WAN.
Der lokale Storage stellt gegebenenfalls den latenzkritischen Datenpfad bereit. Eine Software- oder Storage-Schicht entscheidet über die Datenbewegung. Das Netzwerk verbindet die Domänen, und der Cloud Storage bildet eine zweite Kapazitäts-, Schutz- oder Zugriffsebene.
Damit verschiebt sich die Frage. Nicht der Speicherort ist relevant, sondern welche Funktion ein Speicherort innerhalb des Gesamtsystems übernimmt.
Drei Modelle, die nicht dasselbe leisten
Unter demselben Begriff verbergen sich technisch sehr unterschiedliche Ansätze.
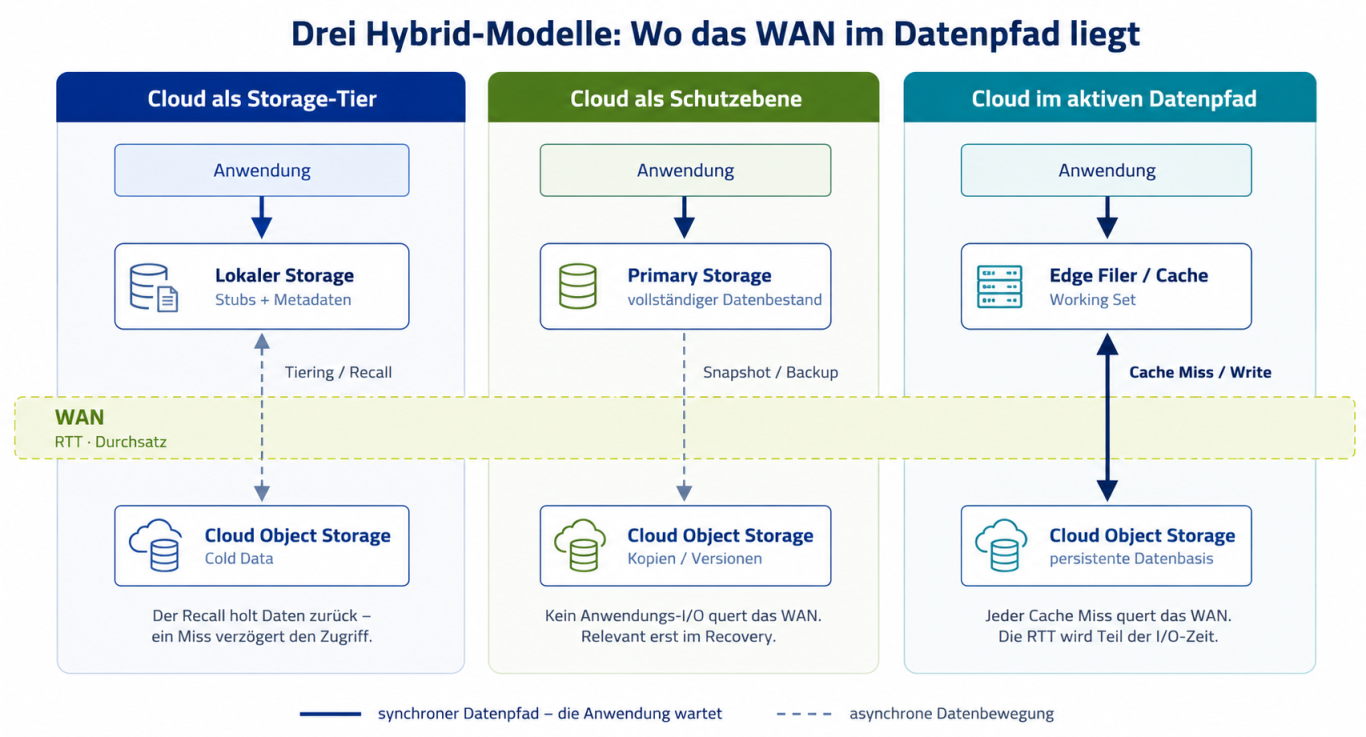
Dieselben Komponenten, drei verschiedene Architekturen. Entscheidend ist, ob und wie der Datenpfad das WAN quert.
Cloud als zusätzlicher Storage-Tier
Der aktive Datenbestand liegt zunächst lokal. Abhängig von Regeln oder ihrem Zustand wandern Daten auf eine externe Ebene: Hot Data bleibt lokal, Cold Data geht in die Cloud. Eine lokale Metadaten- oder Stub-Struktur sorgt dafür, dass ausgelagerte Daten weiterhin im Namespace erscheinen. Greift jemand später darauf zu, müssen sie gegebenenfalls zurückgeholt werden.
Aus der Kapazitätsfrage wird damit eine Frage der Data Placement Policy. Wann darf ein Datenblock oder Objekt die lokale Performance-Ebene verlassen? Das Alter einer Datei reicht als Kriterium selten aus. Letzter Zugriff, Änderungsfrequenz, Dateityp, Wiederherstellungsanforderungen und die verfügbare lokale Kapazität spielen ebenso hinein.
Cloud als Schutz- und Recovery-Ebene
Ein anderes Modell hält die aktiven Daten vollständig On-Premises und überträgt nur zusätzliche Kopien in die Cloud, erzeugt über Snapshots, Backups oder Replikation. Cloud Storage liegt dann nicht im normalen I/O-Pfad der Anwendung.
Das hat eine wichtige Konsequenz. Die WAN-Latenz beeinflusst den Zugriff auf die Primärdaten nicht. Netzwerk- und Cloud-Performance werden erst relevant, sobald Daten übertragen oder wiederhergestellt werden müssen. Genau deshalb gehören RPO und RTO hier getrennt betrachtet. Ein sehr kleines RPO sagt nichts darüber aus, wie schnell mehrere hundert Terabyte nach einem Ausfall wieder produktiv bereitstehen.
Cloud im aktiven Datenpfad
Technisch anspruchsvoller sind Architekturen, in denen lokale Komponenten und Cloud Storage gemeinsam einen logischen Storage Service bilden. Der Client greift auf einen lokalen Cache oder Edge Filer zu, die persistente Datenbasis liegt auf einem entfernten Object Storage. Häufig genutzte Daten bleiben lokal verfügbar.
Damit wird die lokale Komponente Bestandteil der Konsistenz- und Failure-Architektur des Gesamtsystems, nicht bloß ein Gateway. Cache-Kohärenz, Metadatenverwaltung, Locking, der Umgang mit Dirty Data, das Write-back-Verhalten, Konfliktbehandlung sowie Reconnect und Synchronisation nach WAN-Ausfällen müssen sauber definiert sein.
Was wir in Projekten sehen
Die drei Modelle verteilen sich in unserer Projektpraxis sehr ungleich.
Im klassischen Enterprise-Storage-Umfeld haben wir die Cloud-Ebene nahezu ausschließlich als Schutzebene eingesetzt. Die Primärdaten bleiben im Rechenzentrum, in die Cloud gehen Kopien. Das folgt aus der Bauart dieser Systeme: Ihr Datenpfad ist auf lokale Latenz ausgelegt. Eine entfernte Ebene lässt sich daneben stellen, aber nur schwer dazwischen schieben.
Bei Global-File-System-Projekten sieht das anders aus. Dort haben mehrere Kunden die Cloud als Bestandteil des aktiven Datenpfads genutzt. Das ist keine Frage der Vorliebe, sondern eine Folge der Architektur. Ein Global File System bringt Edge-Schicht, Cache, verteiltes Locking und globale Metadatenverwaltung von vornherein mit. Der Object Storage im Hintergrund ist dort kein nachträglich angebauter Tier, sondern die vorgesehene persistente Datenbasis. Was im ersten Modell eine Erweiterung wäre, ist hier der Normalfall.
Das Tiering-Modell begegnet uns derzeit vor allem in Gesprächen, und der Auslöser ist selten technisch. Die deutlich gestiegenen Preise für Storage-Kapazität verschieben die Rechnung für Archivbestände, die einmal geschrieben und über Jahre kaum gelesen werden. Genau dort liegt allerdings auch die Prüffrage: Ob das Modell trägt, hängt daran, ob die Daten wirklich kalt bleiben oder ob Recalls den Zugriff regelmäßig ausbremsen.
Der Datenpfad entscheidet über die Performance
Bei jeder Hybridarchitektur steht eine Frage am Anfang: Muss eine Anwendung für ihren normalen I/O auf die entfernte Storage-Ebene zugreifen?
Wenn jeder synchrone I/O den WAN-Pfad durchläuft, wird die Netzwerkdistanz Bestandteil der I/O-Latenz. Vereinfacht lässt sich die wahrgenommene Latenz als L_total ≈ L_local + L_network + L_remote + L_protocol betrachten, mit Termen für lokale Verarbeitung, Netzwerk, entfernte Verarbeitung und Protokollaufwand.
Das ist kein Performance-Modell eines konkreten Systems. Es verdeutlicht aber eine fundamentale Abhängigkeit: Mehr Bandbreite beseitigt die Auswirkungen der Round-Trip-Latenz nicht. Ein 10-Gbit/s-WAN beschleunigt große sequenzielle Transfers erheblich. Eine Anwendung, die viele voneinander abhängige synchrone Operationen ausführt, bleibt trotzdem durch die Round-Trip-Time begrenzt. Bandbreite und Latenz lösen unterschiedliche Probleme.
Warum Caching eine zentrale Rolle spielt
Ein lokaler Cache hält den entfernten Datenpfad aus den häufigen Zugriffen heraus. Bei einem Read Hit bedient der Cache den Client direkt. Bei einem Read Miss muss die Anfrage bis zum Cloud Storage und wieder zurück. Je höher die Hit-Rate, desto kleiner der Anteil der Reads, der die entfernte Ebene tatsächlich erreicht.
Die Cache-Größe allein bestimmt die Effektivität allerdings nicht. Entscheidend ist die Working-Set-Größe des Workloads. Sieht ein Standort 100 TB, heißt das nicht, dass 100 TB lokal liegen müssen. Werden im Arbeitsalltag nur 5 TB regelmäßig verwendet, bedient ein deutlich kleinerer Cache einen großen Teil der Reads lokal. Umgekehrt hilft auch ein großer Cache wenig, wenn der Workload kontinuierlich auf wechselnde Datenbestände zugreift.
Sichtbarer Datenbestand, Working Set und benötigte Cache-Kapazität sind deshalb drei verschiedene Größen. Sie gehören in der Architekturplanung getrennt behandelt.
Reads sind einfacher als Writes
Anspruchsvoll wird Caching beim Schreiben.
Bei Write-through gilt eine Änderung erst als abgeschlossen, wenn sie auch auf der nachgelagerten Ebene geschrieben wurde. Der Client wartet, bis das entfernte Storage bestätigt hat. Das erleichtert bestimmte Konsistenzanforderungen, koppelt die Write-Latenz aber eng an den entfernten Datenpfad.
Bei Write-back bestätigt die lokale Ebene den Write sofort und überträgt die Daten anschließend. Die wahrgenommene Latenz sinkt. Gleichzeitig entsteht ein Zeitraum, in dem bestätigte Daten ausschließlich oder überwiegend lokal vorliegen. Das System braucht dann persistente lokale Journale, einen Schutz für Dirty Data, eine definierte Reihenfolge der Writes, Retry-Mechanismen, ein Recovery nach Abstürzen und eine Konfliktbehandlung.
Write-back ist damit keine reine Performance-Optimierung. Es verändert das Failure Model des Systems.
File, Block und Object sind keine austauschbaren Ebenen
Hybrid Cloud Storage verbindet regelmäßig unterschiedliche Storage-Modelle. Lokale Anwendungen sprechen SMB, NFS, Fibre Channel, iSCSI oder NVMe. Cloud Storage wird dagegen meist über Object APIs angesprochen. Damit treffen zwei Semantiken aufeinander.
Ein File System arbeitet mit Verzeichnissen, Dateien, Attributen und je nach Implementierung mit File Locking oder POSIX-artigen Semantiken. Ein Object Store organisiert Daten über Objects in Buckets und stellt API-basierte Operationen bereit. Amazon dokumentiert für S3 starke Read-after-write-Konsistenz für PUT- und DELETE-Operationen sowie atomare Updates eines einzelnen Keys. Zu einem POSIX- oder SMB-Dateisystem wird S3 dadurch nicht.
Die Hybrid-Storage-Schicht muss die Lücke schließen und File-Semantik über einen Metadaten-Layer auf Object-Semantik abbilden. Dazu gehören Namespace-Verwaltung, File Metadata, Locking, ACL-Mapping und Konfliktbehandlung. Eine Architektur lässt sich deshalb nicht allein anhand des darunterliegenden Object Storage beurteilen.
Konsistenz wird zum Distributed-Systems-Problem
Sobald dieselben logischen Daten von mehreren Orten verändert werden können, entsteht ein klassisches Problem verteilter Systeme. Ändern zwei Standorte während einer Netzwerkunterbrechung dieselbe Datei, existieren nach dem Reconnect zwei divergierende Versionen. Das System braucht eine definierte Konfliktstrategie: exklusives Locking, Single-Writer-Regeln, Versionierung, Konfliktkopien oder eine anwendungsspezifische Auflösung.
Keine dieser Strategien ist universell richtig. Entscheidend ist, welche Konsistenzsemantik die Anwendung benötigt und welches Verhalten während einer Netzwerkpartition akzeptabel bleibt. Die Mechanismen dahinter – verteiltes Locking, SMB Oplocks und Leases, NFSv4 Delegations – haben wir im Beitrag zu Global File Systems ausführlich behandelt.
Das WAN ist Bestandteil des Storage-Systems
Bei Hybrid Storage ist das Netzwerk keine bloße Verbindung zwischen zwei Systemen. Es beeinflusst Durchsatz, Latenz, Synchronisationsdauer, Cache-Miss-Verhalten, Replikationsverzug und Recovery-Zeit gleichermaßen.
Für einen idealisierten kontinuierlichen Transfer gilt als theoretische Untergrenze: Transferzeit ≥ Datenmenge / nutzbarer Durchsatz. Schon 100 TB über eine dauerhaft voll nutzbare 1-Gbit/s-Verbindung brauchen rechnerisch mehr als neun Tage. Protokoll-Overhead, konkurrierender Traffic und Retransmissions sind darin nicht berücksichtigt.
Daran zeigt sich der Unterschied zwischen normalem Betrieb und Recovery. Eine Hybridarchitektur überträgt im Tagesgeschäft womöglich nur eine geringe Änderungsrate und kommt mit moderater WAN-Kapazität aus. Nach einem vollständigen Verlust der lokalen Daten muss sie dagegen sehr große Datenmengen zurücktransportieren. Die Recovery-Architektur gehört deshalb gegen das Recovery Dataset dimensioniert, nicht gegen die tägliche Änderungsrate.
Replikation ist nicht gleich Backup
Eine zweite Storage-Domäne erhöht die Cyber Resilience nicht automatisch. Werden Änderungen synchron oder asynchron repliziert, gelangen auch unerwünschte Änderungen auf die Zielseite. Das gilt konzeptionell ebenso für Löschungen und logische Beschädigungen, sofern die Replikationsarchitektur sie übernimmt.
Schutz entsteht erst durch zusätzliche Mechanismen: Versionierung, Snapshots, unveränderbare Kopien, Object Lock, getrennte administrative Sicherheitsdomänen und unabhängige Recovery Copies.
Auch die interne Redundanz eines Cloud-Dienstes darf nicht mit Backup verwechselt werden. Cloud-Anbieter replizieren Daten innerhalb ihrer Infrastruktur, um definierte Availability- und Durability-Eigenschaften zu erreichen. Microsoft unterscheidet bei Azure Storage zwischen lokaler, zonaler und geografischer Redundanz, wobei geografische Kopien asynchron entstehen können. Redundanz schützt gegen bestimmte Infrastrukturfehler. Eine unabhängige historische Kopie ersetzt sie nicht.
RPO und RTO müssen getrennt geplant werden
Hybrid Storage ermöglicht eine geografisch entfernte Datenkopie. Ein kurzes RTO folgt daraus nicht.
RPO beschreibt den maximal tolerierbaren Datenverlust, gemessen in Zeit. RTO beschreibt die angestrebte Zeit bis zur Wiederherstellung eines funktionsfähigen Dienstes. Eine Architektur kann kontinuierlich replizieren und ein sehr kleines RPO erreichen. Wenn für die Wiederaufnahme des Betriebs anschließend ein großer Datenbestand über eine begrenzte WAN-Verbindung zurücklaufen muss, bleibt das RTO trotzdem erheblich.
Deshalb gehört bereits ins Design die Frage, ob Daten für das Recovery vollständig zurückkopiert werden müssen oder ob der Betrieb direkt beziehungsweise teilweise auf der entfernten Datenbasis wieder anlaufen kann. Für das tatsächliche Recovery ist das oft wichtiger als die Geschwindigkeit der laufenden Replikation.
Kapazität ist nicht Performance
Ein häufiger Denkfehler setzt Storage-Kapazität mit Storage-Performance gleich.
Cloud Storage stellt Kapazität bereit, ohne dass jemand lokale Disk Shelves oder Arrays installieren muss. Daraus folgt nicht, dass ein bestehender Workload seine lokale Performance unverändert aus der Cloud bezieht. Kapazität beantwortet, wie viele Daten gespeichert werden können. Durchsatz beantwortet, wie viele Daten pro Zeiteinheit übertragen werden. IOPS beantworten, wie viele Operationen verarbeitet werden. Latenz beantwortet, wie lange eine einzelne Operation dauert.
Diese Eigenschaften hängen von unterschiedlichen Komponenten ab. Eine Hybridarchitektur kann nahezu unbegrenzte externe Kapazität besitzen und trotzdem am WAN-Durchsatz oder an der Latenz hängen.
Failure Domains bewusst trennen
Der Nutzen einer hybriden Architektur hängt daran, ob tatsächlich unabhängige Failure Domains entstehen. Zu betrachten sind mindestens das lokale Storage-System, das lokale Rechenzentrum, die WAN-Verbindung, die Cloud-Region, der Cloud-Service, der Identity Provider, die Management Plane und die administrativen Accounts.
Zwei physisch getrennte Datenkopien können trotzdem eine gemeinsame administrative Failure Domain besitzen, wenn beide ausschließlich über dieselbe kompromittierte Identitätsinfrastruktur kontrolliert werden. Physische und administrative Trennung sind zwei verschiedene Eigenschaften.
Kosten entstehen nicht nur durch gespeicherte Terabyte
Ein Vergleich von €/TB On-Premises gegen €/TB Cloud greift zu kurz. Relevant ist der gesamte Lebenszyklus der Daten, vom Schreiben über das Speichern, Replizieren und Lesen bis zum Retrieval und Löschen.
Je nach Cloud-Service entstehen Kosten durch gespeicherte Kapazität, Requests, Datenübertragung, Retrieval, zusätzliche Replikation und weitere Servicefunktionen. Auf der On-Premises-Seite stehen dem Hardware, Wartung, Rechenzentrum, Netzwerk, Administration und Kapazitätsreserven gegenüber.
Besonders wichtig ist die erwartete Datenbewegung. Ein Datenbestand, der einmal geschrieben und über Jahre kaum gelesen wird, hat ein völlig anderes Kostenprofil als dieselbe Kapazität mit hoher Änderungs- und Retrieval-Rate. Die entscheidende Größe lautet deshalb nicht nur, wie viele Terabyte gespeichert werden, sondern wie viele Terabyte sich bewegen – wann, wie häufig und in welche Richtung.
Die zentrale Frage: Wo liegt der aktive Datenpfad?
Viele Detailfragen lassen sich auf eine einzige Entscheidung zurückführen. Wo muss sich die aktuelle Arbeitskopie der Daten befinden, damit die Anwendung ihre Anforderungen erfüllt?
Latenzkritische aktive Daten gehören auf einen lokalen Performance-Layer, während die Cloud Schutz, Kapazität oder sekundäre Daten übernimmt. Große, überwiegend inaktive Bestände lassen sich über lokale Metadaten und einen Cache erschließen, mit der Cloud als Capacity Layer. Bei cloud-nativen Anwendungen kann Object Storage direkt Bestandteil des primären Datenpfads sein. Geografisch verteilte File-Workloads brauchen eine lokale Edge- oder Cache-Schicht, einen zentralen Storage Layer und zusätzliche globale Mechanismen für Metadaten, Konsistenz und Locking.
Hybrid Cloud Storage ist damit weniger eine Technologie als e
Fazit
Hybrid Cloud Storage verbindet unterschiedliche Storage-Domänen zu einer gemeinsamen Datenarchitektur. Der technische Nutzen entsteht nicht dadurch, dass ein lokales System Daten in eine Cloud übertragen kann, sondern durch die Aufteilung der Funktionen.
Wo befinden sich die aktiven Daten? Welche Zugriffe bleiben lokal? Wann wird das WAN Teil eines synchronen I/O? Was geschieht mit Writes während einer Netzwerkunterbrechung? Wie werden konkurrierende Änderungen behandelt? Und wie groß ist das Datenvolumen, das bei einem vollständigen Recovery tatsächlich über die Leitung muss?
Damit verschiebt sich die Architekturfrage von „On-Premises oder Cloud?" zu einer wesentlich präziseren: Welche Storage-Funktion gehört für welchen Datenbestand und welchen Workload auf welche Seite der Architektur? Erst wenn Datenpfad, Working Set, Konsistenz, Failure Domains, Recovery und Datenbewegung gemeinsam betrachtet werden, lässt sich beurteilen, ob eine hybride Architektur gegenüber rein lokalem oder rein cloudbasiertem Storage einen Vorteil bietet.
Quellen
Mell, Peter; Grance, Timothy: The NIST Definition of Cloud Computing. NIST Special Publication 800-145, National Institute of Standards and Technology, 2011. DOI: 10.6028/NIST.SP.800-145.
Amazon Web Services: Amazon Simple Storage Service User Guide – Amazon S3 Data Consistency Model. Aktuelle Online-Dokumentation, abgerufen am 24.08.2026.
Microsoft: Data Redundancy in Azure Files. Microsoft Learn, aktuelle Online-Dokumentation, abgerufen am 24.08.2026.
Welche Entscheidung steht bei Ihnen an?
Sie möchten eine bestehende Infrastruktur bewerten, eine neue Architektur planen oder eine konkrete technische Fragestellung klären? Sprechen Sie mit uns über Ihre Anforderungen.
Spezialist für moderne Dateninfrastruktur
