
WISSEN > ENTERPRISE STORAGE > CYBER RESILIENCE MARKTVERGLEICH
Wie moderne Storage-Architekturen Ransomware erkennen, Recovery Points schützen und Wiederherstellung absichern
Autor: Dirk Neumann Geschäftsführer ASSISTRA Cloud Services GmbH 17.08.2026
Cyber Resilience im Enterprise Storage Marktvergleich
Das sollten Sie mitnehmen:
- Detection ist nicht gleich Detection.
Inline-Erkennung im produktiven Write Path und Content-Analyse gespeicherter Kopien beantworten unterschiedliche Fragen.
- Immutable ist ein Etikett, keine Eigenschaft.
Entscheidend ist, welche Trust Domain eine aktive Retention noch aufheben kann.
- Isolation ist eine eigene Dimension.
Ein geschützter Snapshot im Produktionsarray teilt dessen Failure und Management Domain.
- Unveränderbarkeit beweist keine Datenintegrität.
Sie schützt einen Recovery Point erst ab dem Zeitpunkt seiner Erstellung.
- Automatische Response verschärft die False-Positive-Frage.
Je tiefer der ausgelöste Eingriff, desto teurer wird eine Fehlentscheidung.

Inhaltsverzeichnis
Teil I Grundlagen
- Warum ein Snapshot noch keine Cyber-Resilience-Architektur ist
- Zwei grundsätzlich verschiedene Detection-Probleme
Teil II Detection und Reponse
- NetApp ARP/AI: Detection im produktiven Storage-I/O
- HPE Alletra Storage MP B10000: Detection vor Data Reduction
- Hitachi VSP One Block: CyberSense verschiebt Detection in die Recovery-Ebene
- Huawei OceanCyber: Detection außerhalb des produktiven Write Path
- Proactive Defense und orchestrierter Air Gap
- Dell PowerMax: Anomalieerkennung über Reducibility und I/O-Muster
- Herstellervergleich: Wo greift die Architektur ein?
- Automatische Response erzeugt einen neuen Trade-off
Teil III — Recovery-Point-Schutz
- Immutability: Entscheidend ist nicht das Label, sondern die Trust Domain
- Vier Retention-Modelle in der Praxis
- Was passiert bei einem kompromittierten Administrator?
Teil IV Isolation und Validierung
Teil V Konsequenzen
Enterprise-Storage-Systeme sind längst nicht mehr nur passive Speicherziele. Aktuelle Plattformen integrieren Ransomware-Erkennung, unveränderbare Snapshots, administrative Schutzmechanismen und teilweise automatisierte Recovery- oder Isolationsprozesse direkt in die Storage-Architektur.
Hinter dem gemeinsamen Begriff Cyber Resilience verbergen sich dabei technisch sehr unterschiedliche Ansätze. Ein System untersucht den produktiven I/O-Strom auf Verschlüsselungsanomalien, ein anderes analysiert bereits erzeugte Recovery Points tiefgehend auf Datenkorruption. Ein immutable Snapshot kann gegen den normalen Storage-Administrator geschützt sein, während bei einer anderen Implementierung eine privilegierte Security-Rolle oder ein Hersteller-Support-Prozess die Retention außer Kraft setzen kann.
Ein sinnvoller Vergleich muss deshalb tiefer gehen als eine Feature-Matrix. Sechs Fragen entscheiden: Wo und anhand welcher Informationen wird ein Angriff erkannt? Was passiert nach einer Erkennung automatisch? Wie werden Wiederherstellungspunkte gegen Manipulation geschützt? Welche Trust Domain kann diesen Schutz außer Kraft setzen? Wie weit ist eine Recovery Copy technisch von der Produktion getrennt? Und wie wird festgestellt, welcher Datenzustand tatsächlich vertrauenswürdig ist?
Dieser Artikel untersucht diese Mechanismen anhand aktueller Implementierungen von NetApp, HPE, Hitachi Vantara, Huawei und Dell. Herstellerangaben dienen dabei als Quelle für die dokumentierte Implementierung, nicht als unabhängiger Nachweis überlegener Wirksamkeit.
Warum ein Snapshot noch keine Cyber-Resilience-Architektur ist
Ein Snapshot löst zunächst ein klassisches Data-Protection-Problem: Er stellt einen früheren logischen Datenzustand bereit. Für Cyber Resilience reicht das nicht. Kann ein Angreifer den Snapshot löschen? Kann ein kompromittierter Storage-Administrator dessen Retention verkürzen? Ist der Snapshot bereits mit verschlüsselten oder manipulierten Daten kontaminiert? Kann derselbe Angreifer auch die Replikation und damit die zweite Storage-Instanz administrieren? Und wie stellt man nach einem Angriff fest, welcher Recovery Point noch sauber ist?
Aus diesen Fragen ergeben sich vier Eigenschaften, die häufig vermischt werden, obwohl keine die andere impliziert. Eine Point-in-Time Copy bedeutet lediglich, dass ein bestimmter früherer Datenzustand vorhanden ist. Immutability bedeutet, dass dieser Zustand innerhalb einer definierten Retention nicht regulär verändert oder gelöscht werden kann. Isolation bedeutet, dass er sich zusätzlich in einer anderen Failure- beziehungsweise Trust Domain befindet und nicht permanent über denselben Daten- oder Administrationspfad erreichbar ist. Recovery Validation schließlich beantwortet die Frage, ob die enthaltenen Daten überhaupt für eine Wiederherstellung taugen — denn ein unveränderbarer Snapshot kann technisch perfekt geschützt und trotzdem wertlos sein, wenn die Kompromittierung bereits vor seiner Erstellung begonnen hat.
Cyber Resilience entsteht deshalb erst aus einer Kette:
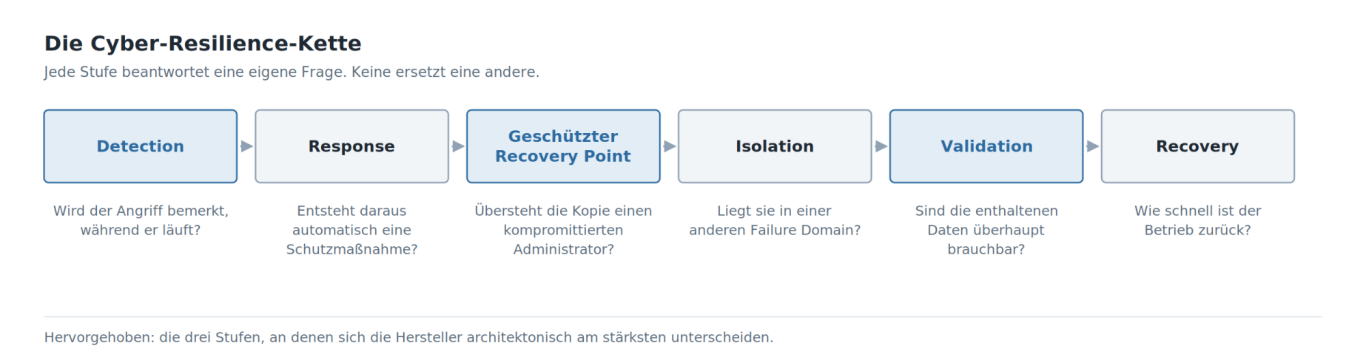
Die Hersteller setzen an unterschiedlichen Stellen dieser Kette an.
Zwei grundsätzlich verschiedene Detection-Probleme
Storage-basierte Ransomware-Erkennung zerfällt in zwei technisch unterschiedliche Aufgaben, die beide unter demselben Marketingbegriff auftreten.
Die erste Strategie versucht, einen Angriff während der Veränderung produktiver Daten zu erkennen. Der Weg führt vom Host über den Write I/O in die Storage-Detection, von dort zur Anomaliebewertung und zur Response. Das klassische Signal ist Entropie beziehungsweise die veränderte Komprimierbarkeit von Daten. Verschlüsselte Daten besitzen typischerweise eine andere statistische Struktur als unverschlüsselte Ausgangsdaten, und Systeme, die ohnehin Compression oder andere Data-Reduction-Verfahren durchführen, können solche Veränderungen auf Storage-Ebene beobachten. Der Vorteil liegt in der zeitlichen Nähe zum Angriff. Der Nachteil liegt in der begrenzten Semantik: Ein Block-Storage-System sieht Schreibzugriffe auf LBAs, nicht die Bedeutung der darüberliegenden Dateien, Datenbankseiten oder Applikationsobjekte.
Die zweite Strategie untersucht bereits erzeugte Kopien. Aus der Produktion entsteht ein Snapshot, dieser wird analysiert, das Ergebnis ist eine Korruptionsbewertung und daraus abgeleitet ein sauberer Wiederherstellungspunkt. Die Analyse kann hier deutlich tiefer gehen, weil sie nicht nur aktuelles I/O-Verhalten, sondern einen vollständigen definierten Datenzustand untersucht. Der Preis ist eine andere Detection Latency, denn die Erkennung hängt davon ab, wann ein Snapshot erzeugt und wann er analysiert wird.
Ein Beispiel macht den Unterschied greifbar. Um 10:00 Uhr entsteht Snapshot A, um 10:05 beginnt der Angriff, um 10:10 entsteht Snapshot B und um 10:20 Snapshot C. Eine Inline-Engine kann möglicherweise bereits zwischen 10:05 und 10:10 während der Schreibvorgänge eine Anomalie erkennen. Eine nachgelagerte Content-Analyse erkennt den Angriff später, kann dafür aber feststellen, dass A sauber ist, während B und C Korruption zeigen — und damit A als Recovery-Kandidaten bestimmen.
Die beiden Verfahren beantworten also unterschiedliche Fragen. Inline Detection fragt, ob gerade etwas passiert, das wie Ransomware aussieht. Recovery-Point-Validierung fragt, welcher gespeicherte Zustand noch vertrauenswürdige Daten enthält. Das erste Verfahren optimiert das Intervall zwischen Angriffsbeginn und Erkennung, das zweite die Sicherheit, mit der ein Wiederherstellungspunkt ausgewählt werden kann. Eine sehr schnelle Erkennung ohne validierbaren Recovery Point führt zu einer schwierigen Wiederherstellung; eine hervorragende Recovery-Point-Analyse erkennt einen Angriff möglicherweise erst, nachdem erhebliche Datenveränderungen stattgefunden haben. Beide Eigenschaften sind komplementär, und eine vollständige Architektur sollte beide berücksichtigen.
NetApp ARP/AI: Detection im produktiven Storage-I/O
NetApp integriert mit Autonomous Ransomware Protection with AI die Erkennung direkt in ONTAP. Das vortrainierte Modell schützt unmittelbar nach der Aktivierung, ohne die Lernphase des älteren ARP-Modells. Verfügbar ist ARP/AI für NAS-FlexVol-Volumes ab ONTAP 9.16.1, für SAN-FlexVol-Volumes ab 9.17.1 und für NAS-FlexGroup-Volumes ab 9.18.1.
Zwischen NAS und SAN besteht ein architektonisch wesentlicher Unterschied. Bei NAS kann ONTAP Informationen aus dem File-Workload berücksichtigen und mehrere forensische Signale gleichzeitig bewerten — Dateiinhalte, Header, Metadatensignaturen. Bei SAN sieht ONTAP nur die vom Host präsentierten Blockzugriffe, nicht die Semantik des darüberliegenden Host-Dateisystems. ARP/AI arbeitet dort deshalb mit einer Entropiebewertung und bestimmt in einer Evaluierungsphase von zwei bis vier Wochen, welche Entropiewerte für den jeweiligen Workload normal sind und welcher Encryption Threshold sinnvoll ist. Der Schutz ist während dieser Phase bereits aktiv, Erkennungen und Alarme sind möglich, während die Schwellenwerte entstehen.
Das illustriert eine generelle Grenze Storage-basierter SAN-Detection: Je weiter die Erkennung im Stack vom Dateisystem und der Applikation entfernt ist, desto stärker muss sie Angriffe aus statistischen Eigenschaften des I/O ableiten.
ARP/AI beschränkt sich nicht auf Alarmierung. Ab ONTAP 9.16.1 erzeugt das System Snapshots in Vier-Stunden-Intervallen unabhängig von einem konkreten Auslöser, zusätzlich bei bestätigtem Angriff einen Attack-Snapshot. Das Intervall ist über arw.snap.create.interval.hours konfigurierbar. Damit koppelt NetApp Detection und Recovery Point eng aneinander und löst insbesondere das Problem, möglichst nahe am Angriffszeitpunkt zusätzliche Wiederherstellungspunkte zu erhalten.
An dieser Stelle lohnt ein genauer Blick auf die Schutzwirkung. ARP/AI-Snapshots sind gesperrt und lassen sich nicht auf normalem Weg löschen. Regulär werden sie allerdings nur zwölf Stunden aufbewahrt, und markiert der Administrator einen Alarm nachträglich als False Positive, löscht ONTAP die gesperrte Kopie selbst. Das ist ein Workflow-Lock, keine Compliance-Retention. Für die spätere Frage nach der administrativen Trust Domain hat das erhebliche Konsequenzen. NetApp empfiehlt deshalb ab ONTAP 9.13.1 Multi-Admin Verification, sodass mindestens zwei authentifizierte Administratoren für die ARP-Konfiguration erforderlich sind.
Für die Wiederherstellung beschreibt NetApp mehrere Verfahren, darunter FlexClone, SnapRestore und einen hybriden Ansatz, bei dem zunächst auf einen als sauber betrachteten Snapshot zurückgegangen und anschließend einzelne Daten aus weiteren Quellen ergänzt werden. Eine vollständige Clean-Copy-Analyse ersetzt ARP/AI damit nicht. Die Unterscheidung bleibt wichtig: Eine erkannte Attacke ist kein Beweis für die Datenintegrität eines Recovery Points.
HPE Alletra Storage MP B10000: Detection vor Data Reduction
HPE verfolgt mit der data-adaptive ransomware detection ab ArcusOS 10.5.0, verfügbar seit dem dritten Quartal 2025, einen besonders klar dokumentierten Inline-Ansatz. Auf ein Volume geschriebene Daten werden stichprobenartig erfasst und von zwei unabhängigen Algorithmen mit dynamisch berechneten Triggern und Schwellenwerten auf Verschlüsselungsaktivität untersucht — und zwar bevor Deduplizierung oder laufwerksbasierte Verschlüsselung angewendet werden.
Diese Position im Datenpfad ist technisch relevant. Fände die Erkennung erst nach der Storage-internen Verschlüsselung statt, wäre eine Entropieanalyse der Nutzdaten praktisch wertlos, weil dann jeder Block wie verschlüsselt aussieht. Auch Data Reduction verändert die Repräsentation der ursprünglichen Daten. HPE setzt die Detection deshalb bewusst vor diese Transformationen.
Wird ein Angriff erkannt, folgen drei unmittelbare Aktionen: Das betroffene Volume wird als Degraded markiert, ein unveränderbarer Read-only-Snapshot für die forensische Untersuchung entsteht, und Alerts gehen unter anderem an Syslog, an die Data Services Cloud Console und, sofern Call Home aktiviert ist, an den HPE Support. Die Empfindlichkeit lässt sich als Low, Medium oder High konfigurieren, ebenso die Retention der bei einer Erkennung erzeugten Snapshots. HPE weist ausdrücklich darauf hin, dass eine höhere Empfindlichkeit die Wahrscheinlichkeit von False Positives erhöht. Detection Thresholds sind damit keine technischen Detailparameter, sondern bestimmen den Trade-off zwischen früher Erkennung und Fehlalarmrisiko.
Bemerkenswert ist vor allem, was HPE nicht behauptet. Das technische Whitepaper grenzt den Funktionsumfang ausdrücklich ein: Die Detection soll Datenverschlüsselung erkennen, ist aber weder Antivirus noch Ersatz für SIEM, XDR, SOAR oder eine Backup-Strategie. Vor allem ist sie nicht dafür ausgelegt, die Sauberkeit eines Recovery Points zu verifizieren. Der dokumentierte Remediation-Workflow sieht deshalb vor, einen Snapshot an eine Host Group zu exportieren und dort zu analysieren; ist dieser betroffen, müssen ältere Snapshots untersucht werden, bis ein geeigneter Wiederherstellungspunkt gefunden ist. HPE optimiert die Storage-Komponente also stark auf frühe Detection und überlässt die forensische Inhaltsanalyse bewusst anderen Ebenen.
Hitachi VSP One Block: CyberSense verschiebt Detection in die Recovery-Ebene
Bei Hitachi VSP One Block ist der Ansatz nahezu umgekehrt. Hitachi kombiniert unveränderbare Thin Image Advanced Safe Snap Recovery Points mit Ransomware Detection powered by CyberSense von Index Engines und beschreibt CyberSenseals AI-basierte Data-Integrity-Validation, die ransomware-bedingte Datenkorruption erkennt und saubere Produktionsdaten für die Wiederherstellung identifiziert.
Aus der Produktion entsteht ein TIA Safe Snap, dieser wird von CyberSense analysiert, das Ergebnis ist eine Korruptionsbewertung und daraus abgeleitet der letzte als sauber bewertete Zustand. CyberSense sitzt damit nicht an derselben Stelle wie HPEs Inline-Engine, und das Ziel ist ein anderes und in gewisser Weise ehrgeizigeres: nicht ob ein Angriff läuft, sondern welche Recovery Copy vertrauenswürdig ist. Hitachi und Index Engines dokumentieren dafür eine Full-Content- beziehungsweise Data-Integrity-Analyse mit zahlreichen Indikatoren.
Die beworbene Detection Accuracy von 99,99 Prozent stammt aus einer vom Hersteller referenzierten ESG-Validierung. Ohne vollständige Angaben zu Testdatensatz, Workloads und Fehlerraten lässt sich daraus keine allgemein gültige Erkennungswahrscheinlichkeit für beliebige Kundendaten ableiten.
Huawei OceanCyber: Detection außerhalb des produktiven Write Path
Huawei beschreibt eine Storage-nahe Erkennung über die OceanCyber Data Security Appliance. Analysiert werden Dateientropie und deren Veränderung, Wechsel von Dateitypen und Extensions, Änderungsraten, neu erzeugte, veränderte und gelöschte Dateien, Metadatenänderungen sowie Trends bei Größe, Typ, Namen und Menge. Diese Merkmale werden gegen ein aus historischen Daten aufgebautes Baseline-Modell bewertet. Die aktuelle öffentliche Dokumentation bestätigt Ransomware Detection für NAS-Dateisysteme, Air-Gap-Policy-Management, Security Response sowie Management und Recovery geschützter Kopien.
Architektonisch entscheidend ist der Zugriffspfad. OceanCyber verbindet sich über das Datennetz mit den Storage-Systemen, für die Analyse von NAS-Dateisystemen nennt Huawei NFSv3, und die chinesische Produktbeschreibung ergänzt SnapDiffals Technik zur Beschleunigung der snapshot-basierten Erkennung. Huawei selbst charakterisiert Ransomware Detection & Analysis als near-real-time beziehungsweise scheduled und grenzt sie damit ausdrücklich von der Echtzeiterkennung ab, die der Hersteller dem klassischen Antivirus zuordnet.
Damit ist klar, wo diese Engine im Stack sitzt. Eine separate Appliance, die Dateisysteme über NFSv3 liest, arbeitet nicht im produktiven Write Path. OceanCyber sollte deshalb nicht mit einer Inline-Engine wie der des B10000 gleichgesetzt werden, auch wenn beide unter dem Begriff Ransomware Detection auftreten. Der Vorteil dieser Position ist derselbe wie bei CyberSense: Die Analyse untersucht einen vollständigen Datenzustand statt eines I/O-Stroms und kann deshalb eine Aussage über die Verwendbarkeit einer Kopie treffen. Die genannten Werte von bis zu 50 TB/h Analyseleistung und 99,9 beziehungsweise, je nach lokalisierter Produktseite, 99,99 Prozent Erkennungsgenauigkeit bleiben Herstellerangaben ohne offengelegte Testmethodik.
Proactive Defense und orchestrierter Air Gap
Besonders relevant ist bei Huawei die Kopplung von Erkennung und Schutzarchitektur. Bei erkannter Ransomware kann das System den Air-Gap-Link proaktiv trennen, automatisch einen Secure Snapshot erzeugen und eine als sauber bewertete Kopie für die Wiederherstellung empfehlen.
Konzeptionell ist das ein deutlicher Unterschied. Bei einer klassischen Detection-Lösung lautet der Ablauf Detection, Alert, Administrator entscheidet. Hier verändert die Detection unmittelbar den Schutzpfad selbst. Damit gewinnt die Qualität der Erkennung zusätzlich an Bedeutung: Ein False Negative verhindert eine notwendige Isolation, ein False Positive löst umgekehrt einen produktionsrelevanten Schutzworkflow aus.
Der zugehörige Air Gap verdient eine präzise Beschreibung, weil der Begriff im Markt inflationär verwendet wird. Huawei betreibt eine separate Isolation Zone. Innerhalb eines definierten Replikationsfensters werden die benötigten Ports aktiviert, die Daten asynchron übertragen und die Ports anschließend wieder deaktiviert; für die Replikation sieht Huawei ein separates physisches Netzwerk beziehungsweise unabhängige Switches vor. Orchestriert wird das über OceanStor BCManager.
Das ist technisch von einer permanent online erreichbaren Replikationskopie zu unterscheiden, aber ebenso wenig identisch mit einem dauerhaft offline gelagerten Medium. Präziser ist deshalb: ein orchestrierter Air Gap mit zeitlich begrenzter Connectivity. Der entscheidende Sicherheitsparameter ist nicht die Kopie, sondern das Exposure Window:
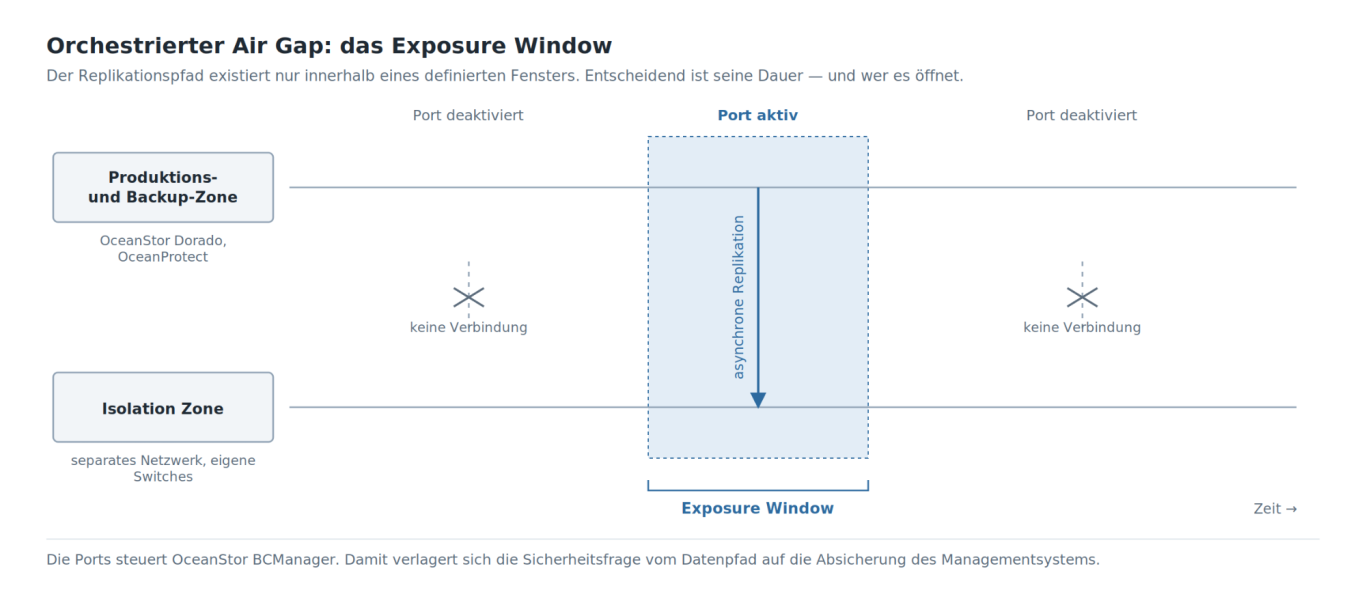
Je kürzer und stärker kontrolliert dieses Fenster ist, desto kürzer besteht der Replikationsdatenpfad zwischen den Security Domains. Die tatsächliche Widerstandsfähigkeit hängt allerdings davon ab, welche Managementpfade die Ports und die Air-Gap-Policy kontrollieren — und damit unmittelbar davon, wie gut BCManager selbst abgesichert ist. Ob ein kompromittiertes Managementsystem die Isolation Zone außerhalb des Replikationsfensters wieder verbinden kann, ist die entscheidende Frage an diese Architektur, und sie lässt sich aus dem öffentlich verfügbaren Material nicht abschließend beantworten.
Dell PowerMax: Anomalieerkennung über Reducibility und I/O-Muster
PowerMax verfolgt wiederum einen anderen Ansatz. Dell dokumentiert auf Device-Ebene eine Anomaly Detection, die ungewöhnliche I/O-Muster erkennt und dabei insbesondere Veränderungen der Data Reducibility und der I/O Patterns berücksichtigt. Weicht das Verhalten signifikant von der Baseline ab, steigt der Anomaly Score des Devices und ein Event entsteht. Der Zusammenhang mit Ransomware ist technisch nachvollziehbar: Verschlüsselung verändert die statistische Struktur und damit die Komprimierbarkeit vorhandener Daten.
Zusätzlich hatte Dell eine CloudIQ-basierte Ransomware Incident Detection dokumentiert, die zunächst zwei Wochen Daten benötigt, um einen erwarteten Bereich für Reducibility aufzubauen, und anschließend Abweichungen von dieser Baseline bewertet.
Für den aktuellen PowerMax-Stand ist allerdings sorgfältig zwischen dieser älteren CloudIQ-Architektur, der PowerMaxOS-internen Anomaly Detection und neueren Advanced-Ransomware-Detection-Funktionen zu unterscheiden. Die öffentlich zugängliche technische Dokumentation ist hinsichtlich des vollständigen internen Detection- und Response-Pfads derzeit weniger transparent als bei HPE oder NetApp. Aus Marketingaussagen zu Advanced Ransomware Detection sollte deshalb ohne zusätzliche technische Dokumentation nicht auf einen bestimmten Inline-, Snapshot- oder Content-Analysis-Algorithmus geschlossen
Herstellervergleich: Wo greift die Architektur ein?
Die Tabelle zeigt, warum die Aussage, ein System besitze Ransomware Detection, für eine Architekturentscheidung praktisch nichts aussagt.
NetApp ONTAP ARP/AI
Detection: Im produktiven I/O. File-Signale bei NAS, Block-Entropie bei SAN.
Response und Schutz der Kopie: Alert plus gesperrte ARP/AI-Snapshots. Schutz über Snapshot-Lock, Retention regulär zwölf Stunden.
Isolation und Validierung: Isolation nur über weitere Architektur. Clean-Point-Validierung begrenzt.
HPE Alletra MP B10000
Detection: Inline, vor Data Reduction und Drive Encryption. Verschlüsselungs- und Datenanomalien, zwei unabhängige Algorithmen.
Response und Schutz der Kopie: Degraded-Markierung, Alert-Snapshot, Alerts. Schutz über Virtual Lock mit Compliance Clock.
Isolation und Validierung: Clean-Room- und Remote-Architekturen möglich. Clean-Point-Validierung ausdrücklich einer separaten Analyse vorbehalten.
Hitachi VSP One Block mit CyberSense
Detection: Am geschützten Recovery Point. Full-Content- und Integritätsanalyse.
Response und Schutz der Kopie: Alert plus Recovery-Orchestrierung. Schutz über TIA Safe Snap.
Isolation und Validierung: Zusätzliche Architektur erforderlich. Clean-Point-Validierung zentraler Bestandteil.
Huawei OceanCyber und Dorado
Detection: Separate Appliance, snapshot-basiert, für NAS über NFSv3. Entropie, File- und Metadata-Trends gegen Baseline.
Response und Schutz der Kopie: Secure Snapshot plus Air-Gap-Trennung. Schutz über Secure Snapshot und WORM.
Isolation und Validierung: Orchestrierte Isolation Zone. Clean-Copy-Bewertung laut Hersteller.
Dell PowerMax
Detection: Auf Device- beziehungsweise Storage-Ebene. Reducibility und I/O Patterns.
Response und Schutz der Kopie: Events; weitergehende Automatisierung versionsabhängig. Schutz über Secure Snapshots.
Isolation und Validierung: Cyber-Recovery-Architekturen möglich. Clean-Point-Validierung öffentlich wenig dokumentiert.
Automatische Response erzeugt einen neuen Trade-off
Je stärker Detection mit automatischer Response gekoppelt wird, desto wichtiger werden False Positives. Führt eine Erkennung lediglich zu einem Alert, ist ein Fehlalarm zunächst ein Betriebsereignis. Erzeugt sie zusätzliche Snapshots, entstehen Kapazitätsverbrauch und Verwaltungsaufwand. Löst sie eine Isolation aus, kann eine Fehlentscheidung unmittelbar die Datenpfade der Schutzarchitektur verändern.
Eine technische Bewertung automatischer Response muss deshalb immer drei Aspekte gemeinsam betrachten: die Genauigkeit der Erkennung, die Eingriffstiefe der ausgelösten Maßnahme und die Möglichkeit kontrollierter manueller Intervention. Herstellerangaben zu Erkennungsraten reichen dafür nicht aus. Nötig wären nachvollziehbare Angaben zu Datensätzen, Workloads, Angriffsmustern, False Positives, False Negatives und Schwellenwerten — und genau die veröffentlicht derzeit kein Hersteller vollständig.
Immutability: Entscheidend ist nicht das Label, sondern die Trust Domain
Detection allein schützt keine Recovery Points. Der zweite große Architekturunterschied liegt deshalb in einer anderen Frage: Was passiert, wenn der Angreifer bereits vollständige Storage-Administratorrechte besitzt? Ein Snapshot ist aus Cyber-Resilience-Sicht erst dann wertvoll, wenn sein Schutz genau gegen diese administrative Kompromittierung Bestand hat.
Dabei lassen sich vier Modelle unterscheiden, die sicherheitstechnisch keineswegs gleichwertig sind. Bei einer storage-intern erzwungenen Retention verhindert eine Compliance Clock die Löschung unabhängig von normalen Administratorrechten. Bei einer separaten lokalen Security Trust Domain wird der Storage-Administrator blockiert, eine höher privilegierte Security-Rolle besitzt jedoch einen Override. Bei einem externen Break-Glass-Pfad kann die Kundenadministration die Retention nicht entfernen, wohl aber ein gesonderter Hersteller-Support-Prozess. Und schließlich gibt es Implementierungen, für die weder Kundenadministrator noch Support einen dokumentierten Weg besitzen, eine aktive Retention
Vier Retention-Modelle in der Praxis
Bei Hitachi VSP One Block schützt Thin Image Advanced Safe Snap die Snapshot-Daten über eine definierte Retention, und die relevante Eigenschaft ist dabei nicht bloße Read-only-Kennzeichnung. Während aktiver Retention lässt sich das geschützte TIA-Pair über die normalen Kundenadministrationsschnittstellen nicht löschen; die Retention kann verlängert, aber nicht regulär verkürzt oder deaktiviert werden. Der klassische Angriffspfad — Storage-Admin kompromittieren, Retention auf null setzen, Snapshot löschen — scheitert damit an der storage-internen Enforcement. Das ist deutlich stärker als reines RBAC, denn selbst ein für Local-Copy-Operationen autorisierter Administrator darf eine aktivierte Retention nicht zurückdrehen. Ob und in welcher Form Hitachi für außergewöhnliche Eingriffe einen Customer-Support-Pfad vorsieht, ist öffentlich nicht dokumentiert.
HPE Virtual Lock geht noch einen Schritt weiter und ist unter den hier betrachteten Implementierungen das strikteste dokumentierte Modell. Die für ein Volume oder eine Kopie gesetzte Retention kann nach dem Setzen weder reduziert noch entfernt werden. Durchgesetzt wird sie über eine Compliance Clock, die eine Umgehung durch Manipulation der Systemzeit oder der NTP-Server verhindert — ein Angriffsvektor, der bei zeitbasierten Schutzmechanismen sonst regelmäßig übersehen wird. Gesperrte Volumes und Snapshots lassen sich nicht löschen, auch nicht durch Super-User-Accounts und laut HPE auch nicht durch den eigenen Tech Support.
Damit entsteht bewusst ein betrieblicher Trade-off. Je weniger Override-Möglichkeiten existieren, desto größer wird die Bedeutung korrekter Retention- und Kapazitätsplanung. Eine versehentlich zu lang gewählte Retention ist dann kein Konfigurationsfehler mehr, der sich korrigieren lässt, sondern bindet Kapazität über den gesamten Zeitraum. Starke Immutability schützt eben nicht nur gegen den Angreifer, sondern auch gegen den Administrator, der seine eigene Fehlkonfiguration beheben möchte.
Bei Dell PowerStore und PowerMax liegt der interessante Aspekt an anderer Stelle. Eine geschützte Kopie muss nicht nur selbst unveränderbar sein, sondern auch unabhängig von der Policy, die sie erzeugt hat. Sonst genügte es, den Administrator zu kompromittieren, die Protection Policy zu entfernen und den Snapshot anschließend regulär zu löschen. Dell schließt diesen Umweg: Wird eine Secure-Snapshot-Regel gelöscht oder eine Policy von einer Ressource entfernt, bleiben die bereits erzeugten Secure Snapshots geschützt und lassen sich bis zum Ablauf nicht löschen. Die Expiration Time kann nach hinten verschoben, aber nicht verkürzt werden, und auch die zugrunde liegenden Storage-Objekte lassen sich nicht löschen, solange geschützte Snapshots existieren.
Huawei Secure Snapshots schließlich lassen sich innerhalb ihrer Protection Period nicht löschen; die Schutzdauer kann verlängert, aber nicht verkürzt werden und reicht laut HyperCDP-Dokumentation bis zu 7.300 Tage. Die detaillierte Administrationsdokumentation beschreibt allerdings für bestimmte Secure-Snapshot-Operationen einen zusätzlichen privilegierten Pfad: Wer die Protection Period eines Dateisystem-Snapshots ändern will, meldet sich über die serielle Konsole als Security Administrator an und passt die Basiseigenschaften an. Die Aussage, ein Secure Snapshot sei nicht löschbar, ist deshalb auf die jeweilige administrative Trust Domain zu beziehen und nicht als absolute Unveränderbarkeit zu lesen. Ergänzend dokumentiert Huawei einen Vier-Augen-Mechanismus, bei dem die Snapshot-Löschung die Freigabe durch einen Approver erfordert.
Genau diese Differenzierung ist bei allen Herstellern erforderlich. Das Etikett immutable sagt für sich genommen nichts darüber aus, wer den Schutz aufheben kann.
Was passiert bei einem kompromittierten Administrator?
HPE Virtual Lock
Retention als durchgesetzte Systemeigenschaft. Nach dem Setzen weder reduzierbar noch entfernbar, abgesichert durch eine Compliance Clock.
Er kann den Schutz nicht entfernen. Gesperrte Volumes und Snapshots sind nicht löschbar, auch nicht über Super-User-Accounts, und die Retention läuft auch dann nicht vorzeitig ab, wenn Systemzeit oder NTP-Server manipuliert werden.
Laut HPE keiner, ausdrücklich auch nicht über den eigenen Tech Support. Ein Angreifer findet auf diesem Weg keinen Zugriff. Kehrseite: Eine zu lang gesetzte Retention bleibt für ihre gesamte Dauer bestehen.
Hitachi TIA Safe Snap
Retention auf dem geschützten Thin-Image-Paar, storage-intern durchgesetzt. Verlängerung möglich, Verkürzung oder Deaktivierung nicht.
Er kann das Paar während aktiver Retention über die normalen Kundenadministrationsschnittstellen nicht löschen — auch dann nicht, wenn er für Local-Copy-Operationen autorisiert ist. Der Pfad „Retention auf null setzen, dann löschen" scheitert.
Öffentlich nicht dokumentiert. Ob ein Support-Pfad existiert, sollte im Auswahlprozess beim Hersteller erfragt werden.
Dell Secure Snapshot
Unveränderbare Kopie mit Expiration Time, entkoppelt von der erzeugenden Protection Policy.
Er kann den Snapshot nicht manuell löschen und die Expiration Time nur nach hinten verschieben. Auch der Umweg scheitert: Das Löschen der Secure-Snapshot-Regel oder das Entfernen der Policy lässt bestehende Snapshots geschützt, und das zugrunde liegende Storage-Objekt ist nicht löschbar, solange geschützte Snapshots existieren.
Öffentlich nicht dokumentiert.
Huawei Secure Snapshot
Protection Period bis zu 7.300 Tage. Verlängerung möglich, Verkürzung nicht.
Er kann den Snapshot innerhalb der Protection Period nicht löschen und die Schutzdauer nicht verkürzen.
Ein Security Administrator kann sich über die serielle Konsole anmelden und die Basiseigenschaften eines Dateisystem-Snapshots ändern. Ein Angreifer müsste also zusätzlich dieses Konto und den Konsolenzugang erlangen. Ergänzend ist eine Multi-Admin-Freigabe konfigurierbar, bei der die Snapshot-Löschung die Zustimmung eines Approvers erfordert.
NetApp ARP/AI Snapshot Lock
Workflow-Lock, gebunden an die Erkennung statt an eine Retention-Policy. Reguläre Aufbewahrung zwölf Stunden.
Er kann die gesperrte Kopie nicht direkt löschen.
Es braucht keine zusätzliche Identität — die Markierung des Alarms als False Positive veranlasst ONTAP, die gesperrte Kopie selbst zu löschen. NetApp empfiehlt deshalb Multi-Admin Verification ab ONTAP 9.13.1. Für dauerhaften Schutz sind die davon getrennten Snapshot-Locking-Mechanismen heranzuziehen.
Diese Matrix ist mindestens so wichtig wie der Detection-Vergleich, und sie fällt anders aus, als die Marketingbegriffe vermuten lassen. NetApp koppelt Detection und Recovery Point technisch am engsten, besitzt aber die schwächste administrative Absicherung dieser Kopien. HPE bietet die schwächste integrierte Clean-Point-Validierung und zugleich das strikteste Retention-Modell.
Die relevante Sicherheitsfrage lautet deshalb: Welche zusätzliche Identität oder Trust Domain müsste ein Angreifer kompromittieren, nachdem er bereits Storage-Administratorrechte besitzt, um die letzte geschützte Recovery Copy zu zerstören? Das ist wesentlich präziser als die Frage, ob ein Hersteller immutable snapshots anbietet.
Isolation als dritte unabhängige Dimension
Ein unveränderbarer Snapshot auf demselben Array besitzt dieselbe Failure Domain wie die Produktion. Er kann hervorragend gegen logische Löschoperationen geschützt sein und trotzdem vom Ausfall des gesamten Arrays betroffen sein, von Firmware- oder Plattformfehlern, von physischem Schaden, von Kapazitätsproblemen oder von der vollständigen Kompromittierung einer gemeinsamen Management Domain. Immutability und Isolation sind also verschiedene Eigenschaften.
Eine Remote Replica ist umgekehrt nicht automatisch ein Air Gap. Sind Produktion und Recovery Storage permanent über denselben Replikations- und Managementpfad verbunden, besteht weiterhin eine technische Beziehung zwischen beiden Domains — und damit ein Weg, auf dem sich ein Angreifer bewegen kann. Ein Cyber-Vault- beziehungsweise Air-Gap-Design versucht, diese Beziehung so weit wie möglich zu reduzieren.
Für Enterprise Storage ist deshalb eine Abstufung in vier Ebenen sinnvoll.
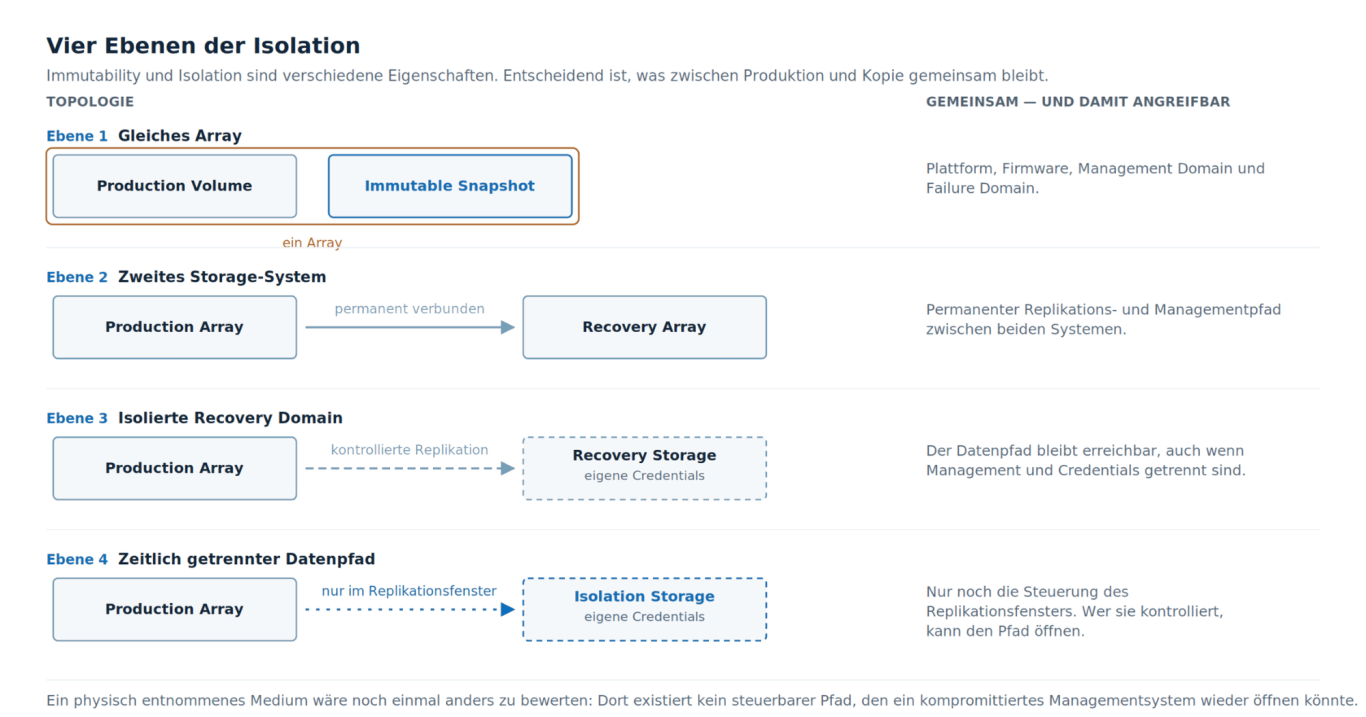
Ein vollständig entnommenes Tape oder ein physisch offline gelagertes Medium wäre noch einmal anders zu bewerten, weil dort kein steuerbarer Datenpfad existiert, den ein kompromittiertes Managementsystem wieder öffnen könnte.
Recovery Validation: das häufig unterschätzte Problem
Nach einem Angriff stellt sich nicht nur die Frage, welche Kopien noch existieren, sondern welche davon einen vertrauenswürdigen Zustand enthalten. Angreifer verbleiben oft über Wochen in einer Umgebung, bevor eine sichtbare Verschlüsselungsphase beginnt. Ein Snapshot von gestern kann deshalb unveränderbar und trotzdem längst unbrauchbar sein.
Daraus folgt ein Prinzip, das in Herstellerpräsentationen selten deutlich ausgesprochen wird: Immutability schützt die Integrität eines Recovery Points nach seiner Erstellung. Sie beweist nichts über die Integrität der darin gespeicherten Daten zum Zeitpunkt der Erstellung.
Genau hier unterscheiden sich die untersuchten Architekturen am stärksten. Hitachi CyberSense und Teile der Huawei-Architektur adressieren diese Frage direkt, indem sie den Inhalt gespeicherter Kopien analysieren. Reine Inline-Detection-Ansätze beantworten sie nicht und beanspruchen das im Fall von HPE auch ausdrücklich nicht. Wer eine Plattform allein nach der Qualität ihrer Erkennung auswählt, kauft möglicherweise eine sehr schnelle Antwort auf die falsche Frage.
Von Availability zu Adversarial Failure
Klassische Enterprise-Storage-Architekturen wurden für technische Fehler entworfen: Drive Failure, Controller Failure, Path Failure, Network Failure, Site Failure. CyberResilience fügt einen grundsätzlich anderen Failure Mode hinzu, nämlich den, dass eine gültig authentifizierte Instanz selbst Teil des Angriffs ist.
Dagegen schützt kein RAID. Dual Controller schützen nicht. Synchrone Replikation schützt nicht, sondern repliziert die Schäden zuverlässig mit. Auch ein klassischer Snapshot schützt nicht zwangsläufig, wenn derselbe Administrator ihn löschen kann.
Damit verändert sich die Architekturfrage grundlegend. Sie lautet nicht mehr, welche Komponente ausfallen darf, sondern welche administrative oder technische Trust Domain kompromittiert werden darf, ohne dass alle Recovery Points zerstört werden können. Das ist der zentrale Unterschied zwischen klassischer High Availability und Cyber Resilience.
Prüffragen für die Architekturentscheidung
Bei der Auswahl eines Enterprise-Storage-Systems sollten deshalb nicht Feature-Namen abgefragt werden, sondern Eigenschaften, die die Hersteller tatsächlich unterschiedlich implementieren.
Zur Detection: Wo sitzt die Detection Engine, und welche Informationen sieht sie an dieser Stelle überhaupt? Arbeitet sie inline im Write Path, near-real-time oder auf Snapshots? Welche Baseline benötigt sie, und wie lange ist das System vorher ungeschützt? Welche False-Positive- und False-Negative-Daten sind dokumentiert?
Zur Response: Wird nur alarmiert, oder entsteht automatisch ein Recovery Point? Kann Replikation gestoppt oder eine Isolation Zone automatisch getrennt werden? Und lässt sich eine automatische Reaktion kontrolliert übersteuern?
Zur Immutability: Wer darf eine Retention verkürzen? Was passiert mit bereits geschützten Snapshots, wenn die Protection Policy entfernt wird? Kann die Systemzeit zur Umgehung einer Retention manipuliert werden? Existiert ein Break-Glass-Pfad, und liegt er beim Kunden oder beim Hersteller?
Zur administrativen Resilience: Genügen Storage-Administratorrechte, oder ist eine separate Security-Rolle erforderlich? Gibt es Multi-Admin Approval, und ist es erzwingbar? Löscht ein regulärer Workflow — etwa das Zurücknehmen eines Alarms — einen geschützten Recovery Point?
Zur Isolation: Liegt die Kopie auf demselben Array oder in einer eigenen Domain? Gibt es getrennte Credentials? Ist der Replikationspfad permanent aktiv? Und welche Managementverbindungen bleiben während eines Air Gaps bestehen?
Zur Recovery Validation: Wie wird ein Clean Point identifiziert? Werden nur Storage-Anomalien betrachtet oder vollständige Inhalte analysiert? Muss eine Kopie dafür an einen isolierten Host exportiert werden, und wie lange dauert dieser Vorgang bei realistischen Datenmengen?
Fazit
Die großen Enterprise-Storage-Plattformen verfolgen bei Cyber Resilience keine einheitliche Architektur, und die Unterschiede liegen nicht dort, wo die Produktnamen sie vermuten lassen.
NetApp integriert Ransomware Detection am engsten in den produktiven Storage-Betrieb und koppelt sie unmittelbar an zusätzliche Recovery Points, sichert diese aber vergleichsweise schwach gegen administrative Eingriffe ab. HPE analysiert Daten inline vor Deduplizierung und Drive Encryption, trennt diese frühe Erkennung ausdrücklich von der Clean-Point-Validierung und bietet zugleich das strikteste dokumentierte Retention-Modell im Feld. Hitachi verlagert den Schwerpunkt mit CyberSense auf die Integritätsanalyse geschützter Recovery Points und die Identifikation eines vertrauenswürdigen Wiederherstellungszustands. Huawei beschreibt eine mehrstufige Architektur aus Secure Snapshots, WORM, snapshot-basierter Analyse durch eine separate Appliance und einer zeitweise verbundenen Isolation Zone, deren Stärke wesentlich von der Absicherung des orchestrierenden Managementsystems abhängt. Dell nutzt Veränderungen von Reducibility und I/O-Mustern zur Anomalieerkennung und kombiniert sie mit Secure Snapshots, dokumentiert den vollständigen Detection- und Response-Pfad öffentlich aber deutlich zurückhaltender als die Wettbewerber.
Die wichtigste Erkenntnis lautet deshalb: Cyber Resilience ist keine einzelne Storage-Funktion. Sie entsteht aus der Verkettung von Detection, automatischer Response, administrativ geschützten Recovery Points, getrennten Trust Domains, Isolation und einer belastbaren Methode zur Identifikation sauberer Daten. Ein immutable Snapshot beantwortet genau eine dieser Fragen.
Die entscheidende Architekturprüfung lautet damit: Wie weit kann sich ein Angreifer durch die Infrastruktur bewegen, nachdem Produktionssysteme und administrative Credentials kompromittiert wurden — und welche technisch unabhängige Schutzschicht verhindert anschließend noch die Zerstörung des letzten vertrauenswürdigen Recovery Points? Erst diese Betrachtung macht aus klassischer Data Protection eine Cyber-Resilience-Architektur.
Quellen
HPE: HPE Alletra Storage MP B10000 — Cyber resilience with data-adaptive ransomware detection, technisches Whitepaper a00147482eew.
HPE: HPE Alletra Storage MP B10000 Security Guide, a00138815enw, Abschnitte zu Ransomware Detection und Virtual Lock.
HPE: Advance your cyber resilience against ransomware with HPE Alletra Storage MP B10000, a00146263enw.
Hitachi Vantara: Ransomware Detection Powered by CyberSense, Datasheet.
Hitachi Vantara: VSP One Block — Thin Image Advanced, Safe Snap und Snapshot Data Retention, Produktdokumentation.
Huawei: Ransomware Protection Storage Solution — Technical Overview, technische Herstellerpräsentation, 2023.
Huawei: OceanCyber Data Security Appliance, aktuelle Produkt- und technische Dokumentation.
Huawei: OceanStor Dorado V6 Series — HyperSnap Feature Guide for File und HyperCDP Feature Guide for File, Secure-Snapshot-Konfiguration und Retention.
Dell Technologies: PowerStore Protecting Your Data — Secure snapshots, Version 5.x.
Dell Technologies: PowerMax Family Security Configuration Guide — Anomaly Detection, PowerMaxOS 10.
Dell Technologies: PowerMax und CloudIQ — Cybersecurity Ransomware Incident Detection.
Welche Entscheidung steht bei Ihnen an?
Sie möchten eine bestehende Infrastruktur bewerten, eine neue Architektur planen oder eine konkrete technische Fragestellung klären? Sprechen Sie mit uns über Ihre Anforderungen.
Spezialist für moderne Dateninfrastruktur
