
WISSEN > ENTERPRISE STORAGE -> ALL-FLASH
Autor: Dirk Neumann Geschäftsführer ASSISTRA Cloud Services GmbH 17.08.2026
All-Flash Storage: Performance und Architektur richtig bewerten
Wie Workload, I/O-Pfad, Controller, Data Services und Fabric die tatsächliche Performance bestimmen
Das sollten Sie mitnehmen:
- IOPS ≠ Performance.
Ohne Blockgröße, Zugriffsmuster, Queue Depth und gemessene Latenz sagt eine IOPS-Zahl wenig über die Eignung für einen Workload aus.
- Engpässe wandern.
NVMe, Write Cache und Datenreduktion verschieben die Grenze im Datenpfad, meist zum Controller oder zur Fabric, statt sie aufzuheben.
- Spitzenwert ≠ Dauerleistung.
Flash verhält sich im eingeschwungenen Zustand anders als kurz nach der Initialisierung; belastbar ist nur der Steady State.
- Der Workload entscheidet.
Datenbanken brauchen niedrige Write-Latency, Virtualisierung Stabilität unter Gleichzeitigkeit – die Bewertung beginnt dort und nicht beim Datenblatt.
- Watt und Höheneinheiten gehören dazu.
Dieselbe Architektur bestimmt Stromaufnahme, Kühllast und Stellfläche; wer das spät prüft, korrigiert teuer.

Inhaltsverzeichnis
All-Flash Storage hat Festplatten in vielen Enterprise-Workloads aus dem primären I/O-Pfad verdrängt. Der entscheidende Unterschied liegt aber nicht darin, HDDs durch SSDs zu ersetzen. Ein All-Flash Array verwendet Solid State Drives als primäres persistentes Speichermedium, und damit entfällt die mechanische Positionierung von Schreib-/Leseköpfen. Das verändert vor allem das Verhalten bei Random I/O: Bei Festplatten muss jeder Zugriff auf einen anderen Datenblock gegebenenfalls mechanisch angefahren werden, NAND Flash kennt diese Komponente nicht.
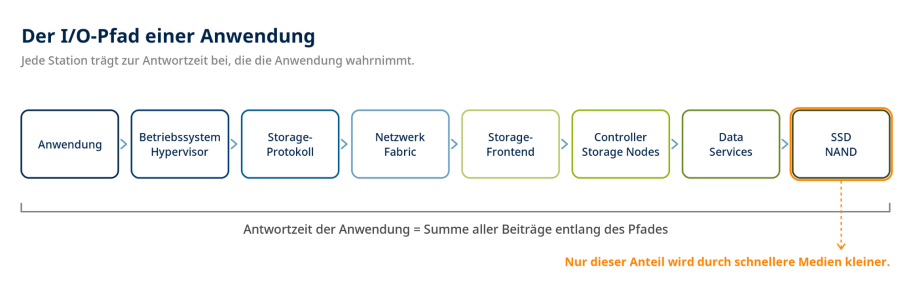
Sobald das Medium selbst kaum noch Zeit kostet, verschiebt sich die Frage nach der Performance jedoch auf alles, was davor liegt. Die SSD ist nur die unterste Ebene einer wesentlich längeren Verarbeitungskette. Zwischen der Anwendung und dem NAND liegen Betriebssystem oder Hypervisor, das Storage-Protokoll, das Netzwerk oder die Fabric, das Frontend des Arrays, die Controller beziehungsweise Storage Nodes und schließlich die Data Services. Die Antwortzeit, die eine Anwendung wahrnimmt, entsteht aus der Summe der Verzögerungen entlang dieses Pfades.
Ein schnelles Medium garantiert deshalb noch kein schnelles Storage-System, und die Leistungsfähigkeit eines All-Flash-Systems lässt sich nicht mit einer einzelnen IOPS-Angabe beschreiben. Für Virtualisierung, Datenbanken und geschäftskritische Anwendungen zählt, wie sich das gesamte System unter dem tatsächlichen Workload verhält.
Kennzahlen und Parallelität
Bei der Bewertung von All-Flash Storage müssen drei Größen getrennt betrachtet werden. Die Latenz beschreibt die Zeit, die ein einzelner I/O-Vorgang benötigt. IOPS beschreiben, wie viele I/O-Operationen pro Sekunde abgeschlossen werden. Der Durchsatz beschreibt die übertragene Datenmenge pro Zeiteinheit, üblicherweise in MB/s oder GB/s.
Zwischen IOPS und Durchsatz besteht bei konstanter I/O-Größe ein einfacher Zusammenhang: Throughput = IOPS × I/O Size. 100.000 IOPS mit 4 KiB entsprechen ungefähr 390 MiB/s Nutzdatenrate. Dieselben 100.000 IOPS mit 64 KiBentsprechen rund 6,1 GiB/s. Eine Angabe wie „eine Million IOPS" ist deshalb ohne weitere Parameter kaum aussagekräftig. Bekannt sein müssten mindestens Blockgröße, Read-/Write-Verhältnis, Random- oder Sequential-Anteil, Queue Depth, die Anzahl paralleler Hosts oder Threads, das verwendete Datenmuster, der Cache-Zustand, Testdauer, Steady State und die gemessene Latenz.
Genau deshalb existiert mit der SNIA Solid State Storage Performance Test Specification ein Verfahren, das diese Bedingungen festschreibt und reproduzierbar macht. Die PTS ist dabei ausdrücklich eine Spezifikation auf Geräteebene. Sie misst Block-I/O am physischen Gerät, nicht Dateisystem-I/O im Host, und sie richtet sich an NAND-Flash-basierte SSDs, nicht an komplette Enterprise Arrays. Zuverlässigkeit, Verfügbarkeit und Datenintegrität sind ebenso wie die Testplattform selbst ausdrücklich nicht Gegenstand der Spezifikation. Für die Bewertung eines Arrays ist sie damit ein Baustein, nicht die vollständige Antwort. Ein Detail lohnt trotzdem besondere Beachtung: Alle Tests laufen mit zufälligem Datenmuster, weil manche SSDs bestimmte Muster erkennen und optimieren. Wer mit gut komprimierbaren Testdaten misst, misst nicht das Gerät, sondern dessen Datenreduktion.
Der zweite blinde Fleck vieler Datenblätter ist die Parallelität. Ein einzelner I/O-Vorgang nutzt die Möglichkeiten moderner Storage-Systeme nur begrenzt; hohe IOPS-Werte entstehen typischerweise dadurch, dass viele Anforderungen gleichzeitig in Bearbeitung sind. Vereinfacht beschreibt Little's Law diesen Zusammenhang: Outstanding I/O ≈ IOPS × Latency. Soll ein System 100.000 IOPS bei einer durchschnittlichen Latenz von 1 ms verarbeiten, müssen im Mittel etwa 100 I/Os gleichzeitig offen sein.
Daraus folgt ein Punkt, der in Datenblättern selten steht. Ein Benchmark mit hoher Queue Depth kann sehr hohe IOPS erzeugen, ohne dass dies dem Verhalten einer konkreten Anwendung entspricht. Die SNIA zieht daraus eine bemerkenswerte Konsequenz: Ihr Latenztest läuft mit genau einem Thread und einem einzigen ausstehenden I/O. Er soll zeigen, wie ein Gerät einen einzelnen I/O ohne den Vorteil des Queuing verarbeitet, und er normalisiert zugleich den Einfluss des Testsystems. Für eine Architekturentscheidung ist deshalb weniger interessant, welchen maximalen IOPS-Wert ein System erreicht. Wichtiger ist, welche Leistung es bei der Queue Depth und der Latenzanforderung der tatsächlichen Anwendung liefert.
NVMe und NVMe over Fabrics
SATA und SAS entstanden in einer Zeit, in der magnetische Datenträger den Storage dominierten. Mit schnelleren Flash-Medien konnten deshalb nicht mehr nur die Medien selbst, sondern auch Schnittstellen und Softwarepfade zum limitierenden Faktor werden. NVMe wurde dagegen von Anfang an für nichtflüchtigen Speicher über PCI Express entwickelt. Die Architektur unterstützt mehrere Submission- und Completion-Queues und ermöglicht dadurch eine stark parallelisierte Verarbeitung von I/O-Kommandos, die moderne Betriebssysteme über mehrere CPU-Kerne verteilen können.
NVMe beseitigt damit aber nicht automatisch alle Storage-Latenzen. In einem Enterprise Array liegen zwischen Host und NAND weiterhin der Host-I/O-Stack, die Fabric, die Frontend-Ports, die Storage-Software, die Controller-CPU, der Cache, RAID oder ein anderer Protection-Mechanismus, Prüfsummen, Compression und gegebenenfalls Deduplication, der SSD-Controller und die Flash Translation Layer. NVMe modernisiert einen Teil dieses Pfads und schafft die Voraussetzung für hohe Parallelität und geringe Protokoll-Overheads. Das ist etwas anderes als eine Garantie für niedrige Latenz.
Die aktuelle Generation ist NVMe 2.4, ratifiziert am 31. Juli 2026 und veröffentlicht am 4. August 2026. Die Spezifikationsfamilie umfasst elf Dokumente und trennt Base Specification, Command Sets und Transport Specifications voneinander.
Bei Shared Storage muss der I/O-Pfad das Serversystem verlassen. NVMe over Fabrics erweitert das NVMe-Modell auf eine Fabric, sodass Hosts auf entfernte NVMe-Subsysteme zugreifen können, ohne für diesen Teil des Datenpfads auf SCSI-basierte Storage-Protokolle angewiesen zu sein. Die Struktur der Spezifikationen hat sich dabei geändert. Ein eigenständiges NVMe-oF-Dokument führt NVM Express nur noch als historische Referenz. Die Fabric-Anforderungen stehen heute in der Base Specification, die transportspezifischen Details in den Transport Specifications für RDMA und TCP. Fibre Channel als Transport für NVMe wird an anderer Stelle standardisiert, nämlich bei INCITS T11.
Dass der Zugriff nun über eine Fabric läuft, beseitigt keine Netzwerklatenz. Die Transportstrecke bleibt Bestandteil der End-to-End-Latenz. Wer die Performance einer NVMe-oF-Architektur beurteilen will, muss Storage und Netzwerk zusammen betrachten.
Der Weg eines Writes durch das Array
Enterprise Storage kann Daten nicht einfach möglichst schnell an eine SSD weiterreichen. Es muss gleichzeitig Anforderungen an Verfügbarkeit, Datenintegrität und Datenmanagement erfüllen. Ein Write durchläuft deshalb mehrere Stationen: Frontend, Cache oder Memory, Protection, Metadaten, Datenreduktion, Backend und schließlich die SSD. Die genaue Reihenfolge ist implementierungsabhängig. Daraus entsteht ein grundlegender Trade-off, denn Funktionen, die Daten schützen, Kapazität reduzieren oder Management ermöglichen, benötigen Ressourcen.
Besonders aufschlussreich ist der Umgang mit dem Write Cache. Viele Architekturen bestätigen einen Write gegenüber dem Host, bevor er auf seinem endgültigen Flash-Ziel liegt. Damit das ohne unvertretbares Risiko möglich ist, muss der bestätigte Write gegen relevante Fehler abgesichert sein, und wie das geschieht, unterscheidet sich von Architektur zu Architektur. Bei der Write-Latency ist deshalb nicht nur interessant, wie schnell NAND programmiert werden kann. Entscheidend ist, an welchem Punkt das System einen Write als ausreichend geschützt betrachtet und ihn gegenüber dem Host bestätigt. Für synchrone Datenbank-Workloads ist diese Frage wesentlich wichtiger als die theoretische Rohleistung einzelner SSDs. Wie stark der Cache-Zustand die Messung prägt, zeigt die SNIA-Methodik: Enterprise-Tests laufen mit deaktiviertem flüchtigem Schreibcache, Client-Tests mit aktiviertem.
Die zweite Station mit spürbarem Einfluss ist die Datenreduktion. Compression und Deduplication senken die physisch zu speichernde Datenmenge und damit Kapazitätsbedarf und Backend-I/O. Gleichzeitig müssen Daten analysiert, Metadaten verarbeitet und Inhalte komprimiert beziehungsweise dekomprimiert werden. Ob daraus ein Performance-Vorteil, ein messbarer Overhead oder praktisch keine Änderung entsteht, hängt von Implementierung und Workload ab.
Problematisch sind vor allem Kapazitäts- und Performancevergleiche, bei denen eine angenommene Data-Reduction-Ratio als feste Eigenschaft des Storage-Systems behandelt wird. Die tatsächlich erreichbare Reduktion hängt von den gespeicherten Daten ab. Bereits komprimierte oder verschlüsselte Bestände verhalten sich anders als stark redundante oder gut komprimierbare Daten.
Wie sich Flash über die Zeit verhält
Auch eine SSD schreibt Host-Blöcke nicht direkt an eine feste physische NAND-Adresse. Zwischen dem logischen Blockadressraum des Hosts und dem NAND liegt eine Flash Translation Layer, die diese Abbildung verwaltet. Das ist notwendig, weil NAND Flash sich grundlegend von magnetischen Datenträgern unterscheidet: Daten werden seitenweise programmiert, während Löschoperationen auf größeren Einheiten erfolgen. Daraus entstehen interne Prozesse wie Garbage Collection, Wear Leveling, Mapping, Block Erase und Fehlerkorrektur.
Unter Schreiblast kann die intern geschriebene Datenmenge deshalb größer sein als die vom Host geschriebene. Dieser Zusammenhang wird als Write Amplification bezeichnet. JEDEC definiert den Write Amplification Factor in JESD218 als die zum nichtflüchtigen Speicher geschriebene Datenmenge geteilt durch die Datenmenge, die der Host zur SSD geschrieben hat. Ein Wert von 1 wäre der theoretische Idealfall, bei dem für jedes vom Host geschriebene Byte genau ein Byte im NAND landet. In realen Systemen ist zusätzliche interne Datenbewegung erforderlich, und der Faktor ist keine feste Geräteeigenschaft: JESD218 hält ausdrücklich fest, dass er vom Workload abhängt und über die Lebensdauer des Geräts variieren kann. Der Workload beeinflusst damit nicht nur die Performance, sondern auch die Beanspruchung der Medien.
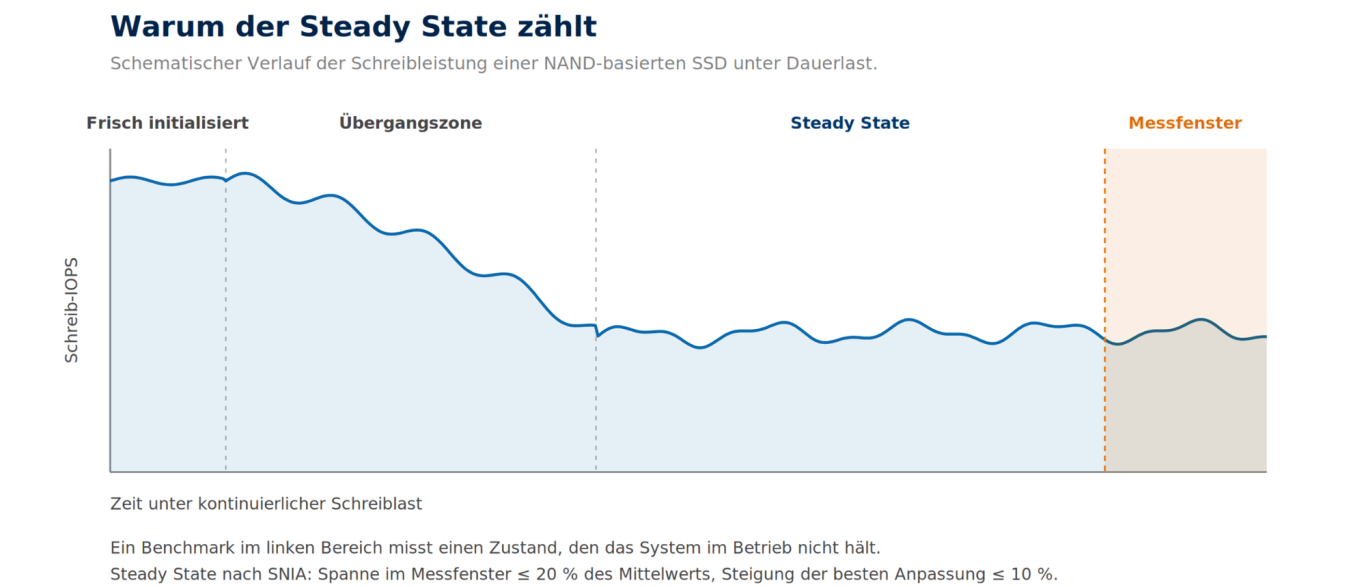
Das hat unmittelbare Folgen für jede Messung. Ein weitgehend unbeschriebenes System verhält sich anders als eines, das längere Zeit unter Schreiblast lief und intern Garbage Collection betreiben muss. Die SNIA berücksichtigt diesen Effekt ausdrücklich und definiert dafür ein präzises Verfahren. Vor jedem Test wird das Gerät in einen definierten Ausgangszustand versetzt, anschließend folgen eine vom Testworkload unabhängige und eine vom Testworkload abhängige Konditionierungsphase. Der Steady State selbst ist quantitativ definiert: Innerhalb des Messfensters darf die Spanne der beobachteten Größe höchstens 20 Prozent des Mittelwerts betragen, und die Steigung der besten linearen Anpassung darf 10 Prozent nicht überschreiten. Der Test läuft bis zum Erreichen dieses Zustands oder maximal 25 Runden, wobei das Messfenster die letzten fünf Runden umfasst.
Für Enterprise Storage ist das entscheidend. Ein kurzer Benchmark unmittelbar nach Initialisierung beantwortet eine andere Frage als ein längerer Test eines ausgelasteten Systems. Belastbar ist nur, wie sich das System unter dauerhaftem Workload verhält, nicht wie es während eines kurzfristigen Peaks aussieht.
Datenbanken und Virtualisierung
Datenbanken gehören zu den klassischen Einsatzbereichen für All-Flash Storage. Trotzdem reicht die Aussage, Datenbanken benötigten viele IOPS, nicht aus. Unterschiedliche Operationen erzeugen unterschiedliche I/O-Charakteristiken. OLTP-Workloads produzieren viele kleine, teilweise zufällige Zugriffe, während andere Datenbankprozesse große sequenzielle Transfers verursachen.
Besonders relevant sind synchrone Writes. Muss eine Anwendung auf die Bestätigung eines Writes warten, liegt dieser I/O direkt im zeitkritischen Pfad. Eine geringere Write-Latency ist dann unmittelbar wichtiger als ein hoher maximaler Durchsatz. Bei Datenbank-Storage müssen deshalb mindestens vier Dimensionen unterschieden werden: Read Latency, Write Latency, IOPS und Durchsatz.
Hinzu kommt die Verteilung der Latenzen. Ein Durchschnittswert verdeckt einzelne langsame I/Os. Die SNIA trägt dem Rechnung, indem sie neben der durchschnittlichen und der maximalen Antwortzeit auch die Antwortzeit auf dem 99,999-Prozent-Perzentil sowie ein Response-Time-Histogramm mit Confidence-Level-Plot vorschreibt. Für latenzkritische Anwendungen liefern genau diese Perzentile die relevante Information.
Virtualisierung stellt eine andere Frage. Ein Storage-System bedient hier nicht mehr einen klar definierten Workload, sondern viele virtuelle Maschinen mit unterschiedlichen I/O-Mustern. Eine VM liest überwiegend, eine andere schreibt. Betriebssystemupdates, Datenbanken, File Services und weitere Anwendungen laufen gleichzeitig auf demselben Storage. Relevant ist deshalb nicht die maximale Performance eines einzelnen Hosts, sondern das Verhalten bei konkurrierenden I/O-Strömen: die Anzahl paralleler Workloads, der resultierende Read-/Write-Mix, das Verhalten bei Spitzenlasten und vor allem die Latenz unter hoher Auslastung. Gerade in virtualisierten Umgebungen führt eine reine Peak-IOPS-Betrachtung deshalb in die Irre.
Wo Systeme an Grenzen stoßen
Wenn das Medium schneller wird, verschwinden Bottlenecks nicht. Sie verschieben sich. Ein Storage-System benötigt Rechenleistung für die I/O-Verarbeitung, für RAID oder andere Data Protection, für Prüfsummen, Compression, Deduplication, Metadaten, Snapshots, Replikation und Netzwerkprotokolle. Bei einer klassischen Dual-Controller-Architektur sind diese Ressourcen an die vorhandenen Controller gebunden. Werden mehr oder schnellere SSDs eingebaut, steigt die Applikationsperformance deshalb nicht zwangsläufig proportional. Ab einem bestimmten Punkt limitiert die Verarbeitungskapazität des Controllers oder ein anderes Element des Datenpfads. Kapazität und Performance skalieren nicht im gleichen Verhältnis.
Damit stellt sich die Frage nach der Skalierungsarchitektur. Bei einer Scale-up-Architektur wird ein bestehendes System innerhalb seiner vorgesehenen Grenzen erweitert. Typischerweise kommen Kapazität und Medien hinzu, während die zentralen Controller-Ressourcen bestehen bleiben. Das ergibt eine übersichtliche Architektur, deren Skalierung jedoch durch die Grenzen der Plattform bestimmt wird. Scale-out-Systeme verteilen die Storage-Funktionen dagegen über mehrere Nodes. Mit zusätzlichen Nodes kommen je nach Architektur neben Kapazität auch CPU, Memory, Netzwerkressourcen und weitere Verarbeitungskapazität hinzu. Dafür muss das System Daten und Metadaten über mehrere Nodes koordinieren, und Verteilung, Konsistenz, Failure Handling und Rebalancing werden Teil der Architektur.
Scale-out ist deshalb nicht automatisch leistungsfähiger als Scale-up. Die entscheidende Frage lautet, welche Ressourcen beim Hinzufügen von Kapazität tatsächlich mitskalieren, und das lässt sich nur anhand der konkreten Architektur beantworten.
Der dritte mögliche Engpass liegt außerhalb des Arrays. Bei Shared Storage endet die Performanceanalyse nicht am Storage-System, denn dieses kann nur die Datenrate liefern, die der vollständige Pfad zwischen Host und Storage transportieren und verarbeiten kann. Zu betrachten sind deshalb Link Speed, die Anzahl der Pfade, das Multipathing, die Auslastung der Fabric, Host-Adapter und Storage-Ports, das Protokoll, die Netzwerklatenz und mögliche Oversubscription. Mit schnelleren Medien wird diese Betrachtung wichtiger, weil ein zuvor durch Festplatten begrenztes System nach der Migration auf Flash an einer ganz anderen Stelle limitiert sein kann.
Energie, Kühlung und Fläche gehören zur Architekturentscheidung
Alles bisher Gesagte hat eine zweite Währung. Jede Entscheidung über Controller, Data Services, Skalierungsarchitektur und Fabric schlägt sich nicht nur in Latenz und IOPS nieder, sondern auch in Watt, in Kühllast und in Höheneinheiten. Wir behandeln diese Größen nicht als Nachtrag am Projektende, sondern als Teil derselben Architekturentscheidung – auch dann, wenn im Anforderungskatalog nicht danach gefragt wird.
Der Wechsel auf Flash verändert das Verhältnis zwischen Leistung, Kapazität und Energiebedarf grundlegend. Eine mechanische Festplatte benötigt Energie für die Rotation, unabhängig davon, ob sie gerade I/O verarbeitet. Bei Flash entfällt dieser konstante Anteil, dafür verschiebt sich der Verbrauch in Richtung Controller, Datenreduktion und Netzwerk, also in genau die Komponenten, die weiter oben schon als Performance-Engpass aufgetaucht sind. Wer Data Services einschaltet, bezahlt Kapazität mit CPU-Zyklen, und CPU-Zyklen sind Watt.
Der eigentliche Hebel liegt dabei selten beim einzelnen Laufwerk, sondern in der Konsolidierung. Liefert ein System die geforderte Latenz auf einem Bruchteil der bisherigen Höheneinheiten, entfallen nicht nur Medien, sondern auch Racks, Stromverteilung, Verkabelung und der zugehörige Kühlaufwand. An dieser Stelle ist allerdings Ehrlichkeit angebracht: Weniger Fläche bedeutet nicht automatisch weniger Kühlung, sondern zunächst konzentriertere Kühlung. Die abführbare Leistungsdichte pro Rack wird damit zur bindenden Größe, und das ist eine Frage an die Gebäudetechnik, nicht an den Storage-Hersteller. Wir klären deshalb früh, was ein Standort überhaupt abführen kann, bevor über Kapazität und Performance gesprochen wird.
Hinzu kommt die Lebensdauer. Write Amplification und Over-Provisioning bestimmen, wie schnell Medien verschleißen, und jeder vorgezogene Austausch kostet Energie und Material, die in keiner Betriebskennzahl auftauchen. Eine am tatsächlichen Workload ausgelegte Auslegung ist deshalb auch eine ökologische Entscheidung, nicht nur eine wirtschaftliche.
Messbar ist das durchaus, und zwar mit derselben Sorgfalt wie Performance. Die SNIA pflegt mit der Emerald Power Efficiency Measurement Specification ein Gegenstück zur PTS, das Energieverbrauch und Effizienz von Storage-Produkten unter definierten Bedingungen erfasst – im aktiven wie im Leerlaufzustand und einschließlich einer Prüfung darauf, welche kapazitätsoptimierenden Verfahren ein System tatsächlich mitbringt. Die Systemfassung 4.0.0 stammt vom 3. Juli 2020 und enthält eine überarbeitete Taxonomie speziell für Solid-State-basierte Systeme; für Laufwerke ist am 16. September 2025 eine eigene Fassung für Data Center Storage Devices hinzugekommen. Version 3.0.3 ist als ISO/IEC 24091:2019 international standardisiert, und die EPA verweist für die ENERGY-STAR-Zertifizierung von Data Center Storage auf Emerald. Wer Angebote vergleicht, hat damit eine belastbarere Grundlage als die Typenschildangaben der Netzteile.
Regulatorisch ist der Druck in Deutschland ohnehin da. Das Energieeffizienzgesetz gilt seit dem 18. November 2023 und erfasst Rechenzentren ab 300 kW nicht redundanter Nennanschlussleistung. Bestandsrechenzentren müssen ab dem 1. Juli 2027 eine Energieverbrauchseffektivität von höchstens 1,5 und ab dem 1. Juli 2030 von höchstens 1,3 erreichen; für Rechenzentren, die ab dem 1. Juli 2026 den Betrieb aufnehmen, gilt ein Wert von höchstens 1,2, jeweils im Jahresdurchschnitt und spätestens zwei Jahre nach Inbetriebnahme. Dazu kommen ein gestaffelt steigender Anteil wiederverwendeter Energie nach DIN EN 50600-4-6, die Umstellung auf erneuerbaren Strom und Meldepflichten gegenüber dem Energieeffizienzregister. Das Bundesministerium für Wirtschaft und Energie hat am 9. April 2026 einen Novellierungsentwurf vorgelegt, der die Grenzwerte für Bestandsanlagen lockern würde. Wer heute plant, sollte den Stand des Gesetzgebungsverfahrens prüfen.
Dabei begegnet uns regelmäßig ein Denkfehler, der erwähnt gehört. Der PUE misst die Infrastruktur, nicht die IT: Er setzt den Gesamtverbrauch des Rechenzentrums ins Verhältnis zum Verbrauch der IT-Systeme. Wer den Stromverbrauch der IT senkt, verbessert seinen PUE deshalb nicht, sondern verschlechtert ihn rechnerisch sogar, weil der Nenner schrumpft, während Klimatisierung und unterbrechungsfreie Stromversorgung weiterlaufen. Ein effizienteres Storage-System kann die Stromrechnung senken und die gesetzlich relevante Kennzahl gleichzeitig nach oben treiben. Wer nur auf den PUE schaut, optimiert am Ziel vorbei. Wir sehen uns deshalb immer beide Größen an: die Kennzahl, die berichtet werden muss, und den absoluten Verbrauch, um den es eigentlich geht.
Was das für die Auswahl bedeutet
Zwei All-Flash-Systeme lassen sich nicht seriös allein anhand ihrer maximal angegebenen IOPS vergleichen. Ein Wert von zwei Millionen IOPS sagt ohne Testbedingungen wenig über die Eignung für einen bestimmten Workload aus. Ein belastbarer Vergleich setzt für beide Systeme dieselben Bedingungen voraus – dieselbe Blockgröße, dasselbe Zugriffsmuster, dasselbe Read-/Write-Verhältnis, dieselbe Queue Depth, denselben Datenbestand und denselben Steady State – und zusätzlich eine Aussage zur Latenz. Die SNIA verfolgt für Geräte genau diesen methodischen Ansatz. Für komplette Enterprise Arrays muss die Bewertung darüber hinaus die Storage-Architektur und deren Data Services berücksichtigen, denn beides liegt außerhalb des Geltungsbereichs der Spezifikation.
Ein zweiter häufiger Fehler in Storage-Projekten besteht darin, ein Performanceproblem vorschnell dem Speichermedium zuzuordnen. Die beobachtete Antwortzeit einer Anwendung setzt sich aus mehreren Anteilen zusammen: aus der Anwendung selbst, dem Host, dem Protokoll, dem Netzwerk, dem Storage-System und dem Medium. Wenn der dominante Anteil im Netzwerk, im Host oder innerhalb der Anwendung entsteht, hat eine weitere Reduzierung der Medienlatenz nur einen begrenzten Effekt auf die gesamte Antwortzeit. All-Flash ersetzt deshalb keine End-to-End-Analyse. Vor einer Architekturentscheidung sollte geklärt sein, wo die relevante Wartezeit tatsächlich entsteht.
Die Bewertung beginnt daher beim Workload, nicht beim Datenblatt. Welche I/O-Größen treten auf, wie hoch ist der Random-Anteil, welche Parallelität entsteht, und gibt es zeitkritische synchrone Writes? Daraus ergibt sich die Latenzanforderung: Welche durchschnittliche Antwortzeit wird benötigt, sind einzelne Ausreißer relevant, und wie verhält sich die Latenz bei steigender Last? Parallel dazu steht die Frage nach der Bandbreite, die Hosts und Anwendungen benötigen, und danach, ob die gesamte Fabric diese Bandbreite überhaupt transportieren kann.
Auf der Architekturseite ist zu klären, wo Daten und Metadaten verarbeitet werden, welche Ressourcen mitskalieren und wo Controller- oder Node-Grenzen liegen. Eng damit verbunden ist die Data Protection: An welchem Punkt wird ein Write bestätigt, wie werden bestätigte Daten gegen Komponentenfehler geschützt, und wie verändert ein Fehlerfall den I/O-Pfad? Bei den Data Services lohnt eine ehrliche Bestandsaufnahme, welche Funktionen wie Compression, Deduplication, Snapshots und Replikation tatsächlich benötigt werden und wie sie implementiert sind.
Schließlich ist die Performance im Normalbetrieb nur eine Seite der Architektur. Ebenso wichtig ist das Verhalten während Controller-, Node-, Drive- oder Pfadausfällen sowie während Rebuild- und Recovery-Prozessen. Und parallel zu all dem läuft die Frage nach Anschlussleistung, abführbarer Kühllast und benötigter Fläche mit – nicht als Abschlusskapitel, sondern als Randbedingung, die eine Architekturvariante ausschließen kann, bevor über ihre Latenz überhaupt gesprochen wurde.
Fazit
All-Flash Storage reduziert die Abhängigkeit von den mechanischen Grenzen klassischer Festplatten. Für moderne Enterprise-Architekturen ist das der Ausgangspunkt, nicht das Ergebnis. Die entscheidende Performance entsteht aus dem Zusammenspiel des vollständigen I/O-Pfads von der Anwendung über Host, Protokoll und Fabric bis zur Storage-Software, den Data Services und dem Flash.
NVMe gestaltet den Datenpfad effizienter und stärker parallelisierbar. Moderne SSDs stellen hohe I/O-Raten bereit. Ob diese Leistung bei einer Datenbank, einer Virtualisierungsplattform oder einer geschäftskritischen Anwendung tatsächlich ankommt, hängt jedoch von der gesamten Architektur ab.
Ein All-Flash-System sollte deshalb nicht anhand seiner maximalen IOPS bewertet werden. Entscheidend sind die Latenz unter dem relevanten Workload, die I/O-Größe, die Parallelität, der Read-/Write-Mix, das Steady-State-Verhalten, die Data Services, die Protection-Mechanismen, die Fabric und die Skalierungsarchitektur. Die zentrale Architekturfrage lautet damit nicht, wie schnell die SSDs sind, sondern wie schnell und wie vorhersehbar das gesamte System den I/O der Anwendung verarbeitet – unter realistischen Bedingungen und einschließlich der Data Services und Schutzmechanismen, die der Betrieb tatsächlich erfordert.
Und weil dieselbe Architektur bestimmt, wie viel Strom fließt, wie viel Wärme abgeführt werden muss und wie viel Fläche belegt wird, gehört diese zweite Rechnung von Anfang an daneben. Eine Auslegung, die im Datenblatt überzeugt und am Standort weder gekühlt noch versorgt werden kann, ist keine Lösung. Wir halten diesen Aspekt in jedem Projekt im Blick, weil er sich später nur noch teuer korrigieren lässt.
Quellen
NVM Express, Inc.: NVM Express Base Specification, Revision 2.4. Ratifiziert 31.07.2026, veröffentlicht 04.08.2026. https://nvmexpress.org/specification/nvm-express-base-specification/
NVM Express, Inc.: NVM Command Set Specification, Revision 1.3. Ratifiziert 31.07.2026. https://nvmexpress.org/specification/nvm-command-set-specification/
NVM Express, Inc.: NVMe over PCIe Transport Specification, Revision 1.4. 2026. https://nvmexpress.org/specification/nvme-over-pcie-transport-specification/
NVM Express, Inc.: NVMe over RDMA Transport Specification, Revision 1.3. 2026. https://nvmexpress.org/specification/rdma-transport-specification/
NVM Express, Inc.: NVMe over TCP Transport Specification, Revision 1.3. 2026. https://nvmexpress.org/specification/tcp-transport-specification/
Storage Networking Industry Association (SNIA): Solid State Storage Performance Test Specification (PTS) Version 2.0.2. SNIA Standard, 01.10.2020. https://www.snia.org/tech_activities/standards/curr_standards/pts
JEDEC Solid State Technology Association: JESD218 – Solid-State Drive (SSD) Requirements and Endurance Test Method. Aktuelle Revision JESD218B.02, Juni 2022. https://www.jedec.org/standards-documents/focus/flash/solid-state-drives
Storage Networking Industry Association (SNIA): Emerald Power Efficiency Measurement Specification v4.0.0 (03.07.2020) sowie Emerald Power Efficiency Measurement Specification for Data Center Storage Devices V1.0 (16.09.2025). Version 3.0.3 entspricht ISO/IEC 24091:2019. https://www.snia.org/tech_activities/standards/curr_standards/emerald
Bundesrepublik Deutschland: Gesetz zur Steigerung der Energieeffizienz und zur Änderung des Energiedienstleistungsgesetzes (Energieeffizienzgesetz – EnEfG), in Kraft seit 18.11.2023, insbesondere § 11 (Anforderungen an Rechenzentren). https://www.gesetze-im-internet.de/enefg/__11.html
Welche Entscheidung steht bei Ihnen an?
Sie möchten eine bestehende Infrastruktur bewerten, eine neue Architektur planen oder eine konkrete technische Fragestellung klären? Sprechen Sie mit uns über Ihre Anforderungen.
Spezialist für moderne Dateninfrastruktur
